loader

Nerio News Magazine brings you trusted, timely and thought-provoking stories from around the globe.

Follow Us

前端监控体系落地:三个指标、四类异常与两个闭环

前端监控体系落地:三个指标、四类异常与两个闭环
关键词前端监控、Core Web Vitals、INP、LCP、CLS、RUM

很多团队的前端监控停留在「接了个 SDK,看个大盘」的阶段,指标全绿但用户投诉不断。问题不在工具,而在采集口径与行动闭环。这篇按「采什么、怎么采、采完怎么办」三段,给出一套能落地的监控体系,所有指标口径对齐 Google Core Web Vitals

一、采什么:三个核心指标 + 四类异常

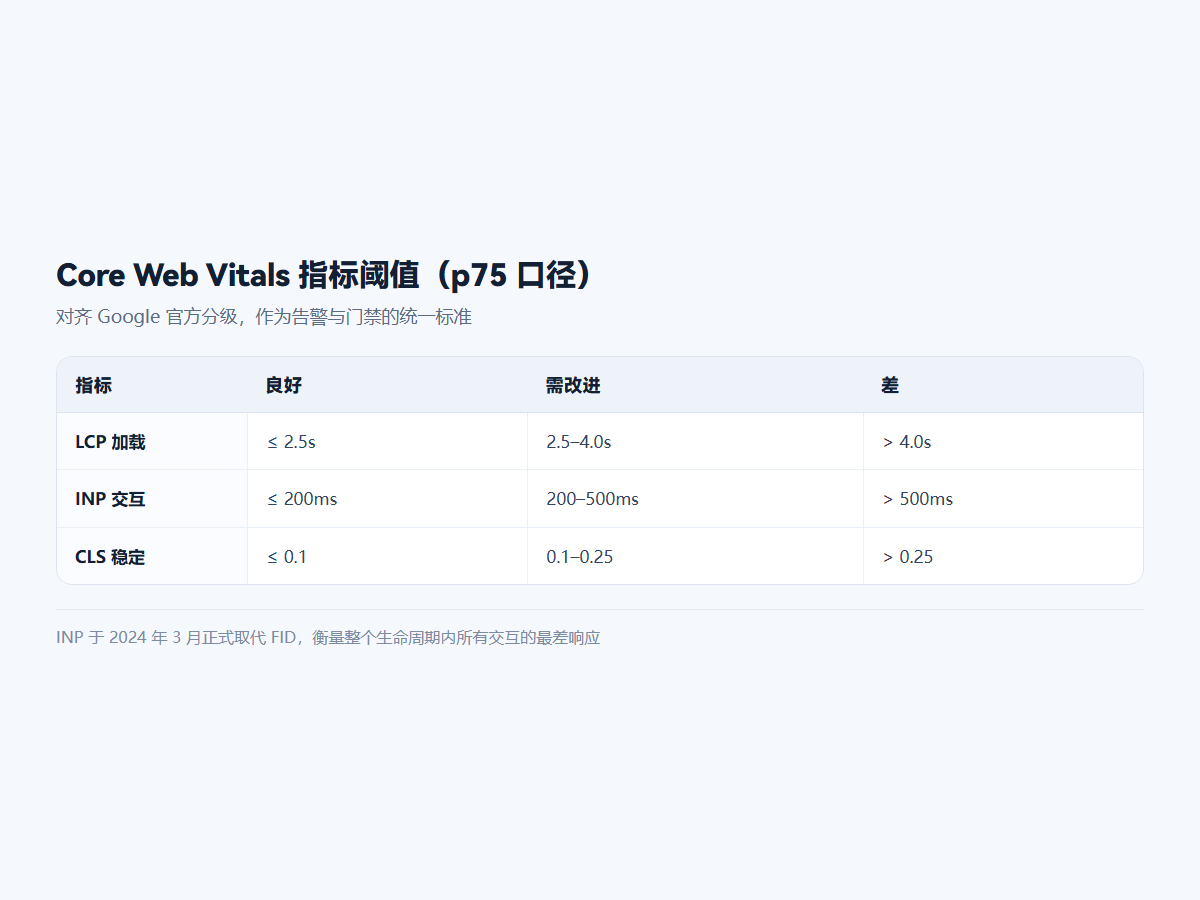
体验指标只看三个:LCP(加载)、INP(交互响应,2024 年 3 月起正式取代 FID)、CLS(视觉稳定)。INP 是最容易被低估的——它衡量整个页面生命周期内所有交互的响应延迟,比 FID 严格得多,长任务、 hydrate 未完成、事件处理过重都会在这里现形。

异常采集四类:JS 运行时错误(window.onerror)、Promise 未捕获拒绝(unhandledrejection)、资源加载失败(error 捕获阶段)、接口失败与慢请求(封装层统一埋点)。

Core Web Vitals 指标阈值(p75 口径)

二、怎么采:低侵入、可归因、控成本

官方 web-vitals 库(当前 6.x)已经把三个指标的测量逻辑封装好,自己实现很容易踩口径偏差:

import { onLCP, onINP, onCLS } from "web-vitals";

const report = (metric) => {
  navigator.sendBeacon("/api/rum", JSON.stringify({
    name: metric.name, value: metric.value,
    id: metric.id,          // 同一会话去重/聚合的键
    nav: performance.getEntriesByType("navigation")[0]?.type,
    url: location.pathname, // 只采路径,不采 query,防敏感信息泄露
  }));
};
onLCP(report); onINP(report); onCLS(report);

三条工程红线:上报走 sendBeacon(页面卸载也不丢);采样率按流量分级(头部页面全量、长尾 1%–10%);采集脚本独立版本化,不要跟着业务 bundle 一起发,否则 SDK 自身出问题就是监控盲区。

三、归因:把「指标差」翻译成「哪里坏了」

指标只是结果,归因要靠细节字段。实践中最值钱的几个:

  • LCP 差:看 metric.entries 里 LCP 元素是什么、其资源的 TTFB/下载耗时各占多少——TTFB 高是服务端问题,下载慢是资源问题,元素晚出现是渲染阻塞问题;
  • INP 差:用 performance 的 LongTask 与事件 timing 定位到具体长任务,常见元凶是 hydrate 未完成就绑交互、同步计算、大量 DOM 操作;
  • CLS 差:查没有尺寸的图片/广告位、动态插入在首屏上方的元素、字体切换闪动。

建议把「指标 + 归因字段 + 用户会话 ID」落成一条记录,能从大盘一路点到一个会话的完整行为序列,这是排查投诉时最省时间的形态。

四、闭环:告警分级与回归门禁

没有闭环的监控只是报表。两个抓手:

  1. 告警分级:p75 指标劣化超 10% 持续 1 小时 → 群通知;超 25% 或错误率突增 → 电话拉人。按页面维度拆开告警,避免大盘均值掩盖局部恶化;
  2. 发布门禁:每次上线前用实验室环境(Lighthouse/自建 lab)跑核心页面,LCP/INP/CLS 与 bundle 体积超阈值即阻断合并。线上回归 lab 数据不准确,但拦住「明显变差」足够了。

一句话总结:监控体系的价值 = 采集口径的准确 × 归因链路的完整 × 告警后的响应速度。三个指标、四类异常、两个闭环抓手,就构成了 2026 年前端监控的合格线。

标签

#前端监控#性能优化#Web Vitals#可观测性

React Server Components 实战:边界怎么划,收益才真实

React Server Components 实战:边界怎么划,收益才真实
关键词React Server Components、RSC、客户端组件、服务组件、React 19、前端架构

2026 年,React Server Components(RSC)已经从「实验特性」变成主流生产架构:React 19(当前 19.2.8)把 RSC 协议纳入稳定面,Next.js App Router、RedwoodJS 等框架都默认以 RSC 为骨架。但很多团队是「先用了再说」,对它的运行模型理解模糊,导致客户端包没有真正变小、数据请求也没有真正变少。这篇把 RSC 的核心模型、落地步骤和常见坑一次讲清。

一、RSC 改变了什么:渲染位置从「浏览器」前移到「服务器」

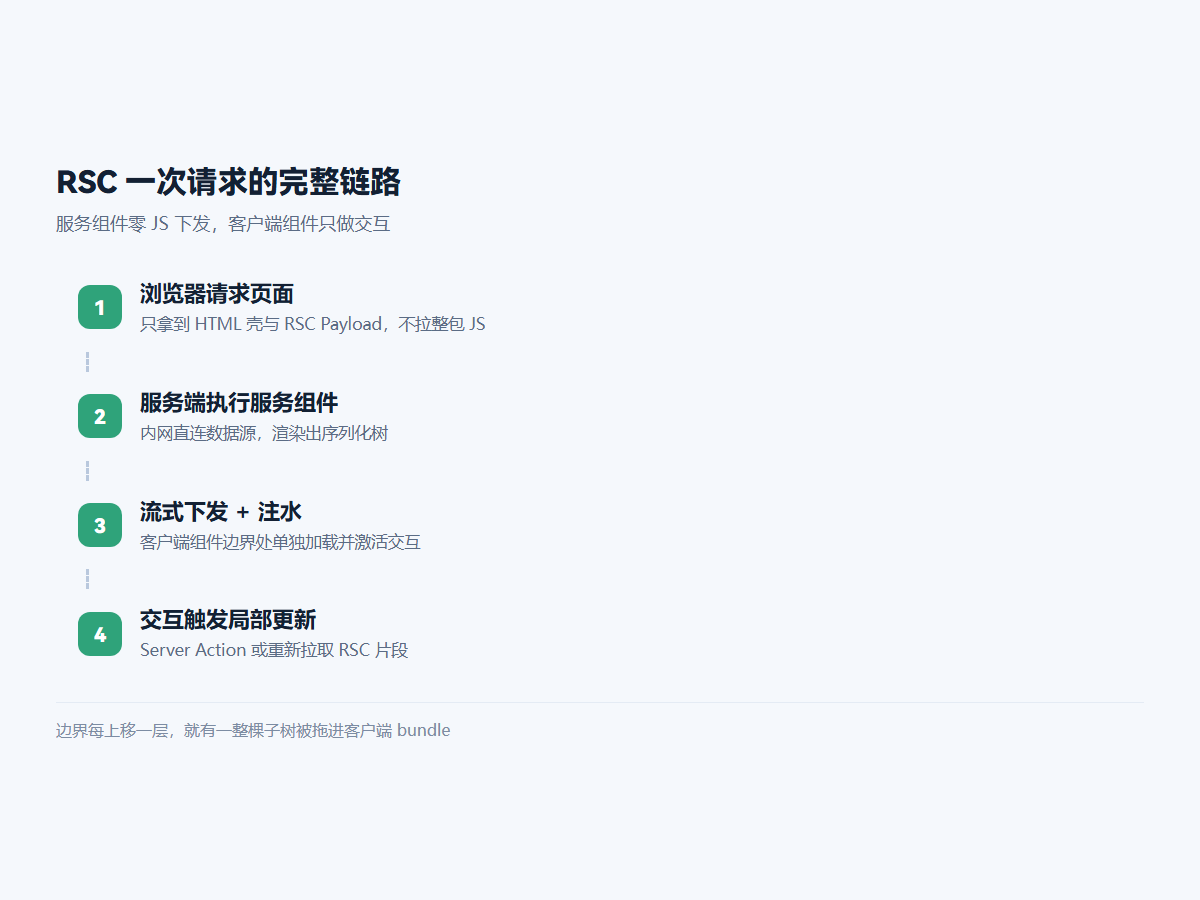
传统 SPA 是「一个 HTML 壳 + 一大坨 JS」,所有渲染、数据获取都在浏览器完成。RSC 把组件分成两类:

  • 服务组件:只在服务器执行,可以直接 await 数据库/文件/内部服务,产物是序列化后的 RSC Payload,不进客户端 bundle
  • 客户端组件:文件顶部标 "use client",和传统组件一样水合运行,负责交互与状态。

收益是两端的:客户端 JS 显著变小(服务组件零字节下发),数据获取在服务器内网完成,省掉了浏览器到 API 的多次往返。官方立场参考 React 官方博客

RSC 一次请求的完整链路

二、落地四步:从混用到分清边界

大多数团队的正确路径是「默认服务组件,按需下沉客户端」,而不是反过来:

  1. 默认全是服务组件:新页面不写 "use client",数据获取、模板、SEO 相关内容都放服务端;
  2. 只在叶子节点加 "use client":输入框、轮播、弹窗这类真正需要交互的组件;
  3. 把 children 穿过边界:客户端组件通过 children 接收服务组件渲染结果,避免把整个子树拖进客户端;
  4. 校验收益:用 bundle 分析确认 JS 体积与请求瀑布确实下降,否则说明边界划错了。
// app/product/page.tsx —— 服务组件:直接取数,零客户端 JS
import { AddToCart } from "./add-to-cart"; // 客户端组件

export default async function Page({ params }) {
  const product = await db.product.find(params.id); // 服务器内网直连
  return (
    <section>
      <ProductDetail product={product} />
      {/* 只有按钮是客户端的,整个详情树不进 bundle */}
      <AddToCart id={product.id} />
    </section>
  );
}

三、最容易踩的四个坑

现象 正确做法
边界划太大 页面顶部一个 "use client",整页退回 SPA 边界下沉到叶子,用 children/props 传服务端渲染结果
在服务组件里用 hooks/浏览器 API 构建报错或运行异常 交互逻辑拆成客户端组件;window 等只在客户端组件用
把函数/类实例当 props 传 序列化失败,报「Functions cannot be passed…」 props 只传可序列化数据;跨边界行为用 Server Actions
数据请求隐式去重失败 同一请求发多次 用框架的 fetch 缓存/Request Memoization 语义,或收敛到统一数据层

四、迁移期策略:并存,不搞一刀切

RSC 与传统组件可以在同一应用共存,框架按文件粒度识别。建议迁移期保留原页面路由不动,新页面全部走 RSC;对老页面按流量从低到高逐个改造,每改造一个页面用真实用户数据对比 LCP/INP 与 JS 传输体积。Next.js 文档对 App Router 下的缓存与流式语义有完整说明,迁移前值得通读一遍,很多「性能没变好」的问题出在对缓存默认值的误解上。

一句话总结:RSC 的本质是把「组件树」变成「客户端与服务端协作的协议」,边界划得越精细,两端各干擅长的事,收益越大。

标签

#React#Server Components#前端架构#React 19

HR 面试终局:反向提问、Offer 比较、背调与离职交接

HR 面试终局:反向提问、Offer 比较、背调与离职交接
关键词反向提问、Offer 比较、背景调查、离职交接、面试技巧

“你有什么想问我的吗?”——这是整场面试里唯一一个主动权在你手上的时刻,也是浪费率最高的一个问题。绝大多数人回答”没有了”,或者问几个百度一下就知道的问题,白白丢掉一次既展示自己、又核实信息、还能反向影响对方评价的机会。

本文讲清三件事:反向提问问什么、怎么问;拿到多个 offer 怎么比较;背调与离职交接怎么收尾。

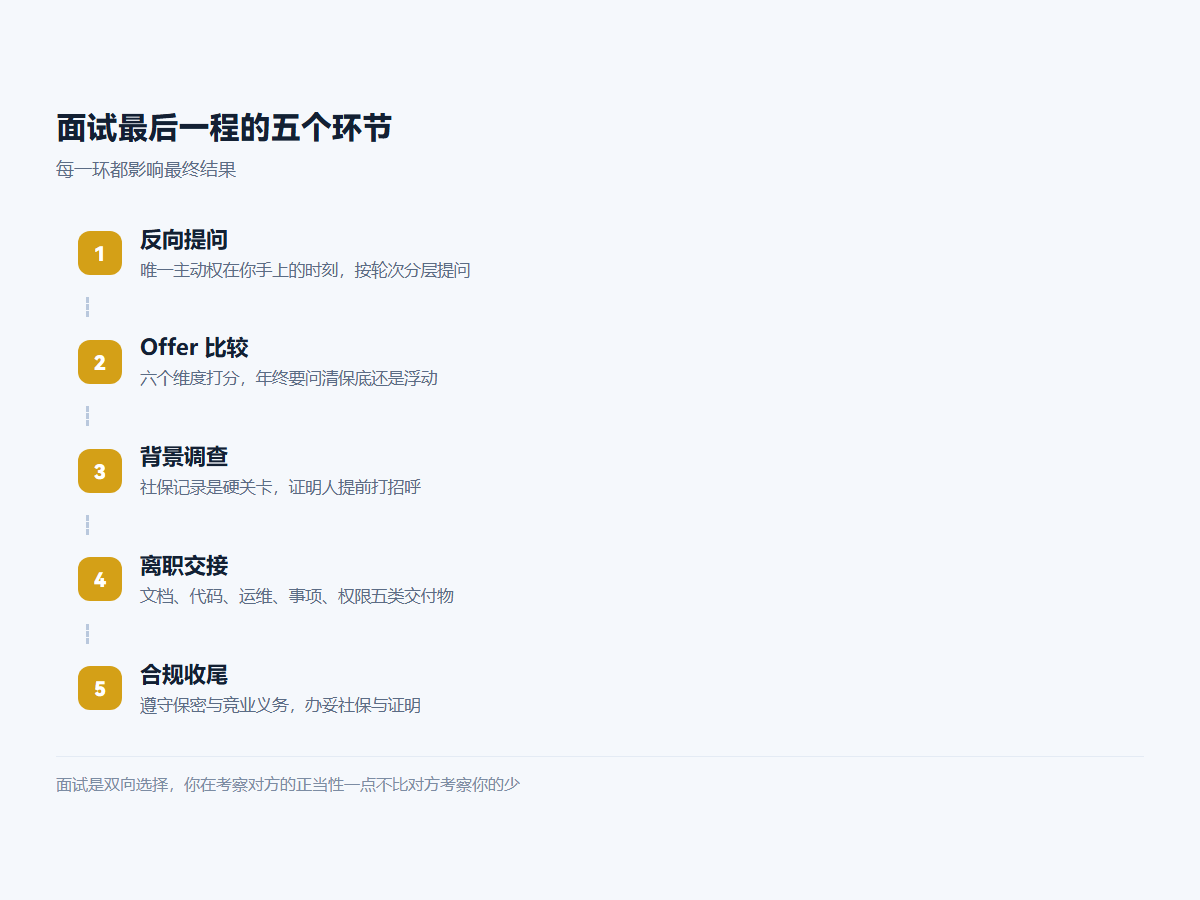
面试最后一程的五个环节
面试终局:反向提问 → Offer 比较 → 背景调查 → 离职交接 → 合规收尾

一、反向提问:它不是走过场

Q1:为什么面试官要问这个?

三个目的,理解清楚才知道怎么答:

  1. 考察你的思考深度——你问什么,暴露了你关心什么、看到哪一层。
  2. 考察你的动机真实性——真正做过功课的人,问的问题一定很具体。
  3. 考察你的沟通风格——提问的方式本身就是一次表达样本。

核心认知:反向提问不是”面试结束了客套一下”,它仍然是面试的一部分,而且是评价权重不低的一部分。很多面试官会在评分表上单独给”提问质量”打分。

Q2:绝对不要问的三类问题

  1. 能百度到的问题——”公司主要做什么业务””你们有多少人”。这说明你没做任何准备,是最减分的信号
  2. 过早谈个人收益细节——首轮就问”几点下班””年假几天””加班有没有调休”。关心可以,但时机要在拿到意向之后
  3. 让对方为难或无法回答的问题——”你觉得我这次面试能过吗””我表现得怎么样”。面试官通常不会正面回答,场面会尴尬。

Q3:按面试轮次分层提问

不同轮次的面试官掌握的信息不同,问的问题也该不同。

对技术面试官(考察团队真实状态)

  1. “这个岗位日常的工作内容,能具体说说最近一两个月在做什么吗?”
  2. “团队目前的技术栈和主要技术债是什么?”
  3. “现在团队面临的最大技术挑战是什么?”
  4. “代码评审和发布流程是怎么做的?有没有灰度、回滚机制?”
  5. “如果我入职,前三个月你希望我优先解决什么问题?”

第 5 题是性价比最高的一问:它既帮你判断岗位的真实性(答不上来往往意味着岗位需求没想清楚),又暗示了你已经把自己代入入职状态。

对直属领导(考察管理方式与成长空间)

  1. “您期望这个岗位的人半年后达到什么状态?”
  2. “团队的决策流程是怎样的?技术方案一般由谁定?”
  3. “您怎么看待技术债和业务节奏之间的平衡?”
  4. “团队里做得好的人,通常好在哪里?”
  5. “过去一年团队里有没有人获得晋升或者提拔?他们做了什么?”

第 9 题很关键:它把一个抽象问题(”有没有发展空间”)变成了可验证的事实。如果对方答不上来或者含糊其辞,基本可以判断这个团队晋升机制有问题。

对 HR / 更高层(考察组织与长期)

  1. “这个岗位为什么现在开放?是新增还是替补?”
  2. “这个业务在公司整体战略里处于什么位置?未来一年的投入方向?”
  3. “团队的组织架构和汇报关系是怎样的?”
  4. “公司的技术序列晋升标准和周期是怎样的?”
  5. “您觉得什么样的人能在这个团队待得久、做得好?”

第 11 题必须问。新增岗位和替补岗位的含义完全不同——替补岗要追问”上一任为什么离开”,这个信息非常关键。

Q4:怎么把提问变成加分项?

三个技巧:

  1. 问题要”嵌”进前面的对话。比如”您刚才提到团队在做服务拆分,我想追问一下,现在拆到什么阶段了?最大的阻力是什么?”——这说明你在认真听,而且能顺着往下想。
  2. 用问题展示你的专业判断。”我注意到你们的核心链路是同步调用,我之前遇到过类似架构在大促时的雪崩问题,你们有做过熔断或者降级的设计吗?”——这既是提问,也是一次能力展示。
  3. 一次问 2–3 个,不要连珠炮。问一个、听完反馈、再问下一个,让它像对话而不是清单。

二、Offer 比较:别只比薪资

Q5:多个 offer 该怎么比?

把 offer 拆成六个维度打分,而不是只看月薪:

维度 具体看什么 权重建议
现金 月薪 × 发薪月数 + 年终(问清是保底还是浮动
长期激励 股票/期权的归属节奏与行权条件
成长性 技术栈、业务复杂度、能否接触核心系统、带人的机会
稳定性 业务是否核心、团队是否有人员流失、公司现金流
工作强度 真实节奏(不要只看制度,要看团队实际
隐性成本 通勤、是否异地、五险一金基数

关键提醒:年终奖一定要问清”保底还是浮动、历史发放比例、是否按入职月份折算”。很多 offer 的总包差异,实际就藏在这几个字里。“16 薪”可能是”12 + 保底 2 + 绩效 2″,也可能是”12 + 浮动 4″。

Q6:股票期权怎么看?

别被数字迷惑,问清四件事:

  1. 形式:是 RSU(限制性股票)还是期权?期权需要行权,要真金白银掏钱。
  2. 归属节奏:常见 4 年归属、1 年 cliff。没到归属期离职,一分钱拿不到。
  3. 行权窗口:离职后多久内必须行权?(有的公司只有 90 天)
  4. 估值与流动性:非上市公司的股票能否变现、按什么价。没有流动性时,它的实际价值要大幅打折。

Q7:怎么判断一家公司/团队值不值得去?

给一份可操作的核查清单:

  • 问离职率:”团队过去一年的人员变化大吗?”——高流失是最危险的信号
  • 问业务位置:”这个业务对公司的重要性如何?今年的投入是增加还是收缩?”
  • 看面试官状态:他们聊起工作时是投入还是敷衍?面试官的精神面貌是团队氛围最真实的样本。
  • 看流程专业性:面试安排是否守时、反馈是否及时、问题是否有准备——招聘流程的粗糙程度,往往就是管理水平的缩影。
  • 交叉验证:通过脉脉、前员工、行业社群了解真实情况,但注意甄别情绪化评价

Q8:能不能用 offer 抬价?

可以,但要专业地抬

  • 诚实告知:”我手上还有另一个 offer,整体条件和这边接近,但我在技术方向上更倾向贵司。”——给出理由,而不是单纯比数字。
  • 给出可执行的锚点:”如果这边能到 X,我可以马上确认。”让对方知道你的决策条件。
  • 只做一次。反复拉扯会消耗信任,甚至导致 offer 被撤回。
  • 不要虚构 offer。HR 圈子很小,且有些公司会要求提供书面证明,穿帮的代价极大。

三、背调:别在最后一环翻车

Q9:背调一般查什么?

  • 任职经历:公司、岗位、在职时间(主要通过社保记录核实,这部分做不了假)。
  • 工作表现:联系你提供的证明人,或直接找到你的前上级/同事。
  • 离职原因与合规性:是否有违纪、竞业限制、劳动纠纷。
  • 学历:通过学信网等官方渠道核验。

Q10:背调前要做什么准备?

  1. 确认社保记录与简历一致。这是最硬的一关,时间对不上基本过不了。
  2. 提前和证明人打好招呼,说明对方可能来电、你会申请什么岗位、希望对方重点突出什么。不要让证明人接到陌生电话时措手不及。
  3. 选对证明人:优先选择真正了解你工作、且愿意客观评价的直属上级或核心协作方
  4. 如实披露竞业限制。如果签过,主动说明范围和期限——隐瞒被发现的后果远大于坦诚说明。
  5. 注意时机:通常背调在发 offer 前或后,别在原单位尚未知晓时就让对方开始背调,避免给现职带来麻烦。

四、离职交接:把最后一程走漂亮

Q11:提离职要注意什么?

  • 先想清楚再开口。一旦正式提出,挽留的博弈会很消耗,不要在没决定时试探性提离职
  • 先和直属领导沟通,再走 HR 流程。让领导从别人嘴里听到你要走,是很大的失礼。
  • 按合同提前通知(通常是 30 天)。如果希望提前离开,协商而不是单方面走人
  • 离职原因保持一致且体面。说”个人发展规划”,不必细说新去向,更不要吐槽公司和同事——行业圈子比想象的小。
  • 警惕”反 offer”(Counter Offer)。统计数据上,接受挽留的人大多在半年到一年内还是会走。除非导致你离开的问题被真正解决,否则不要留下。

Q12:交接怎么做才算专业?

一份合格的交接包应该包含:

  1. 文档:负责系统的架构说明、部署流程、常见问题处理手册。
  2. 代码:未合并分支、未完成改动、已知的技术债列表。
  3. 运维:监控告警在哪看、常见告警怎么处理、值班联系方式。
  4. 进行中事项:进度、风险、对接人、下一步计划。
  5. 账号与权限:需要移交的账号清单。

关键认知:交接质量是你在行业里口碑的一部分。很多人离职时草草了事,结果半年后前同事还在找他问问题,或者在行业场合被人评价”走得很难看”。把交接做成一份可交付的成果,成本不高,收益是长期的。

Q13:离职后还要注意什么?

  • 遵守保密与竞业义务。不要带走代码、文档、客户资料——这是法律风险,不是道德选择。
  • 保持联系。前同事是行业人脉的重要部分,体面离开的人往往会在未来再次合作。
  • 办妥手续:离职证明、社保公积金转移、未休年假结算、最后一个月工资确认。

五、小结

面试的最后一程,考验的是专业度和长远视角:反向提问是唯一一次你掌握主动权的机会,用好它能同时达到”核实信息 + 展示水平”两个目的;Offer 比较要把视野从月薪扩展到成长性、稳定性与隐性成本;背调和交接则是你在行业里长期口碑的一部分,别在最后一环消耗掉前面所有的努力。

记住一句话:面试是双向选择,你在考察对方的正当性,一点也不比对方考察你的少。


说明:本文为面试流程与方法论整理,涉及劳动权益、竞业限制、期权税务等具体问题时,建议咨询专业人士或查阅当地法律法规,不要仅凭本文做决策。

标签

#HR 面试#Offer#背调#求职

HR 行为面试全解:STAR 法则与 30 个高频场景应答思路

HR 行为面试全解:STAR 法则与 30 个高频场景应答思路
关键词HR 面试、STAR 法则、行为面试、面试技巧、失败经历

技术面考的是”你会不会”,HR 面考的是”你是个什么样的人,以及你说的话可不可信“。很多人误以为 HR 面是闲聊,结果在这一轮被问得前言不搭后语,或者讲了一堆空泛的形容词,拿不到分。

行为面试有一套成熟的方法论——STAR 法则。本文讲清它的正确用法、常见变形,以及 30 个高频追问场景的应答思路。

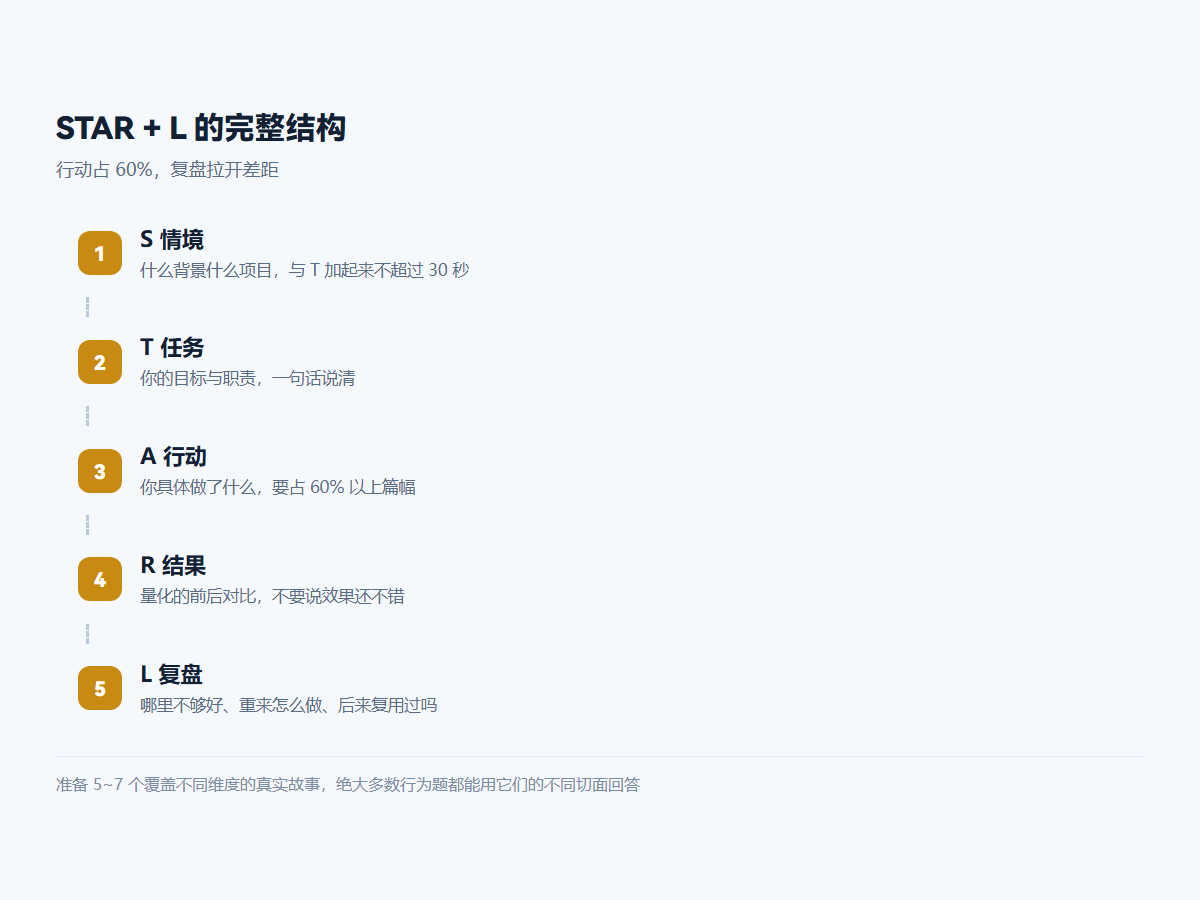
STAR + L 的完整结构
STAR 法则:情境 → 任务 → 行动 → 结果 → 复盘

一、STAR:看起来简单,用错的人特别多

Q1:STAR 是什么?为什么要用它?

四个字母对应四个要素:

  • S(Situation)情境:什么背景、什么项目、什么处境。
  • T(Task)任务:你要达成什么目标,你承担什么职责。
  • A(Action)行动你具体做了什么——这是核心,要占 60% 以上篇幅。
  • R(Result)结果量化的结果,以及你从中获得了什么。

为什么有效:因为 HR 要判断的是你过去的行为模式能否复用到未来岗位。空泛的”我抗压能力强”没有信息量,但”连续三周每天加班到十点赶上线,期间我做了 X 和 Y 保证进度”是可验证的。

Q2:最常见的三个错误用法?

  1. 情境讲太久。用两分钟铺垫项目背景,说到行动时已经超时被打断。正确做法:S 和 T 加起来不超过 30 秒,一句”那是 2024 年 Q3,我负责交易系统的重构,目标是把下单 P99 从 800ms 降到 300ms 以内”就够了。
  2. 只讲”我们”不讲”我”。全程”我们团队做了……我们的方案是……”,HR 听完不知道你个人贡献了什么。正确做法:团队部分一句带过,重点讲”我负责的模块””我提出的方案””我做的取舍”。
  3. 结果没有数字。”效果还不错””领导很满意”这类表述毫无说服力。正确做法:给出可量化的前后对比——性能提升多少、成本降了多少、Bug 率变化、交付周期缩短几天。
// 反面示范(空泛)
"我抗压能力比较强,之前项目很紧的时候,我主动承担了很多工作,
最后顺利完成了任务,领导也比较认可。"

// 正面示范(STAR 完整 + 量化)
S:去年双十一前,我们支付链路的压测达不到目标 QPS,距上线只剩两周。
T:我负责排查瓶颈并给出可落地的优化方案。
A:我先用火焰图定位到热点在订单校验的串行 RPC 调用上,
   把它改成并行编排,并对其中两个高频查询加了本地缓存;
   另外发现连接池配置偏小,调整后单实例吞吐提升了 40%。
R:最终 P99 从 1200ms 降到 260ms,压测 QPS 从 3000 提到 8500,
   双十一当天零故障。方案后来沉淀成团队的性能排查手册。

二、STAR 的进阶变体

Q3:面试官追问”还有别的吗”怎么办?

STARL——在 R 之后加一个 L(Learning)复盘

  • 这件事里我哪里做得不够好
  • 如果重来一次我会怎么做
  • 这个经验我后来复用了吗

这一层是拉开差距的关键。能主动复盘的人,在 HR 眼里意味着”成长性”和”自我觉察能力”。很多人答到这里就停了,非常可惜。

Q4:如果事情的结果是失败的,还要用 STAR 吗?

要用,而且更要用。HR 问”说一次失败经历”,考的不是你有没有失败过(人人都有),而是你如何面对失败、是否从中提取了可复用的教训

结构是:坦诚说明失败 → 归因到自己可控的部分 → 说明补救动作 → 讲清后续如何避免

// 错误的失败回答(甩锅 / 自我贬低)
"那次项目延期主要是因为需求一直变,产品那边也没定清楚。"   // 甩锅
"我那时候经验不足,做得不太好。"                            // 空泛,无信息

// 正确的失败回答
S:去年我主导过一个 SDK 的改版,目标是统一三端接口。
T:我负责方案设计和推动落地。
A:我当时低估了存量兼容的复杂度——只做了接口对齐,没提前梳理
   各个业务方的历史调用姿势,也没有灰度方案,直接全量发布。
R:上线后有两个业务方出现兼容性问题,回滚处理,项目延期三周。
L:复盘后我改了两条习惯:一是涉及多方的改动必须先做调用方清单
   和兼容性矩阵;二是任何 SDK 变更一律走灰度 + 可回滚开关。
   今年另一个类似的改造,用这套流程做到了零回滚。

关键:讲失败时把”我”放在归因的中心,把”改进”放在最后。避免甩锅给同事、产品、公司,也避免过度自我否定。

三、30 个高频场景的应答思路

按 HR 真正在考察的维度分组,每组给出应答要点。

A 组:抗压与执行力(考察稳定性)

  1. “说一次你顶着巨大压力完成任务的经历” → 讲压力的具体来源(时间紧/资源少/需求变),重点是你怎么拆解任务、排序优先级、争取资源,而不是”我很辛苦”。
  2. “项目延期了你会怎么办” → 先止损上报(不要自己扛到最后一刻),再砍范围还是加资源给出明确建议,最后说明如何避免。
  3. “同时有多个紧急任务怎么处理” → 讲你的优先级框架(影响面 × 紧急度 × 依赖阻塞),并说明你会主动和各方对齐优先级而不是自己硬扛。
  4. “你的工作被全盘否定时什么感受” → 先确认否定的是方案还是目标,要求对方给出具体理由,再决定是调整还是反驳。避免表现出防御性或情绪化。

B 组:冲突与协作(考察团队适配)

  1. “和产品/测试发生过冲突吗?怎么解决的”不要说”没有冲突”(显得不真实或回避)。讲一次具体分歧,重点在你怎么从”立场之争”回到”目标之争”——摆数据、明确共同目标、给出折中方案。
  2. “同事不配合你怎么办” → 先自查(是不是我需求不清楚、时机不对),再了解对方的实际困难(他手上有更紧急的事),最后才是升级到上级协调。
  3. “你觉得什么样的团队氛围最适合你” → 给出具体描述而不是抽象词(”信息透明、可以直接说’这个方案有问题’、决策有记录”),并且和这家公司的实际情况挂钩
  4. “跨部门推动一件事很难,你怎么做” → 讲利益对齐:找到对方部门也在意的指标,把你的事变成”对我们都有好处的事”;必要时拉通双方上级。

C 组:主动性与成长(考察潜力)

  1. “你做过哪些超出职责范围的事” → 讲一次你主动发现并解决的问题,强调”没人要求我做,但我认为这会影响 XX,所以我做了”。
  2. “最近学了什么新技术?怎么学的” → 讲学了什么 → 用在什么地方 → 解决了什么问题。只说”看了书/视频”是低分答案,必须有落地
  3. “你怎么保持技术敏感度” → 给出具体的信息源与实践方式(关注哪些社区、怎么验证新技术、有没有做技术分享或写笔记)。
  4. “你的技术短板是什么”说一个真实的、非致命的短板,紧接着说明你正在怎么补。避免说”我太追求完美”这类伪装成缺点的优点。

D 组:决策与取舍(考察判断力)

  1. “说一次你做过的艰难技术决策” → 讲可选的几条路 + 各自的代价 + 你为什么选了这条决策题考的是取舍意识,不是正确性。
  2. “技术债和业务需求冲突时你怎么选” → 不要给绝对答案。讲你怎么评估影响面(这个债会不会拖慢后续三个需求?会不会有稳定性风险?),并用数据说服业务方,而不是”技术债必须还”。
  3. “你推翻过自己的方案吗” → 讲一次你在有新信息时改变判断的经历,说明什么信息让你改变了主意。
  4. “如果给你一笔预算重做现有系统,你会怎么做” → 先问清楚约束(团队规模、时间窗口、业务目标),再给方案。开口就说”全部重写”是减分项。

E 组:动机与稳定性(考察是否会留下来)

  1. “为什么想离职”讲”追求”而不是”逃离”。说发展空间、技术方向、业务场景吸引你,避免吐槽前东家(薪资低、领导差、同事内斗——说了 HR 只会担心你以后也这么说他们)。
  2. “为什么选择我们公司” → 需要做过功课:具体到业务方向、技术栈、团队做的事情。泛泛说”平台大、发展好”没有说服力。
  3. “你手上还有别的 offer 吗”如实说。有多个 offer 是加分项(说明市场认可你),但要表达你对这个岗位的具体偏好,而不是拿它单纯当抬价筹码。
  4. “未来三年的职业规划” → 讲能力成长路径而不是职位路径(”我希望三年内能独立负责一个从 0 到 1 的系统”比”三年做到 P7″更好)。同时要和这个岗位能提供的东西匹配
  5. “能接受加班吗”诚实回答,但把边界说清楚:接受项目关键期的集中投入,但不接受把长期低效当作常态。可以反问团队的实际节奏,这也是你在考察对方。

F 组:价值观与边界(考察是否靠谱)

  1. “你最看重工作的什么” → 给出两三个明确维度并排序(技术成长、业务影响力、团队协作、报酬),比”都还行”强得多。
  2. “你和上级意见不一致时怎么办” → 表达先充分沟通、表达清楚我的判断和依据;若最终决策权在他,执行但保留我的数据记录。体现既有主见又能协作。
  3. “发现同事的代码有严重问题,你会怎么做” → 私下沟通 → 用数据/复现说明 → 若对方不认可则升级。不要当众指责,也不要默默放过。
  4. “你有没有为了赶进度牺牲过质量” → 坦诚讲一次,重点是你怎么记录和管理这个决策(明确列为技术债、排期补上、加监控兜底),而不是”牺牲了就牺牲了”。

G 组:场景应变(考察思维敏捷度)

  1. “入职后发现团队技术栈和你预期不符怎么办” → 先搞清楚为什么是这套栈(历史包袱?业务特性?),再评估是适应它还是推动改变,给出渐进方案
  2. “如果你的方案被同事全盘否定” → 要求具体的反对理由,用数据对比;如果对方有道理就采纳,如果是认知差异就用小范围验证来定夺。
  3. “领导交给你一个你完全不懂的领域” → 讲你的学习路径:先摸清全局和关键概念 → 找到领域专家请教 → 小步验证 → 定期同步进展和风险。
  4. “你怎么判断一个需求该不该做” → 讲你的评估框架:影响多少用户、解决什么问题、投入产出比、有没有更轻量的验证方式。
  5. “最后,你有什么想补充的吗”一定要有。补一个前面没来得及讲的核心亮点,或者重申你与岗位的匹配度。说”没有了”是最浪费的收尾。

四、三个通用原则

原则一:每个答案都要有”证据”

HR 评价的不是你答得多漂亮,而是你的话能不能被验证。形容词要换成事实:不要说”我很负责”,要说”我负责的模块连续两个季度零线上故障”。准备时给每个能力维度配一个具体故事,比背模板有效得多。

原则二:准备 5~7 个”万能故事”

面试前准备 5–7 个覆盖不同维度的真实案例:一个技术攻坚、一次冲突解决、一次失败复盘、一次主动推动、一次跨部门协作、一次艰难取舍、一次带人/被带。绝大多数行为题都可以用这些故事的不同切面来回答,比临场编造靠谱得多

原则三:不要背模板,要内化结构

面试官能听出背诵感。正确的准备方式是”记住故事的骨架和关键数字”,表达时用自然口语组织,而不是逐字背稿。同一个故事面对不同提问,强调的重点应该不同。

五、小结

行为面试的本质是用过去的行为预测未来的表现。STAR 提供的是”把故事讲得可信”的骨架,而真正决定分数的三件事是:有没有具体细节、有没有量化结果、有没有真诚复盘。

把 5–7 个真实故事准备好,每个都按 STAR 梳理清楚并补上复盘层,HR 这一轮基本就不会失分了。


说明:本文为面试方法论整理,具体应答请结合自身真实经历调整。虚构经历在追问下极易露馅,且背景调查环节可能被核实,务必以真实案例为基础准备。

标签

#HR 面试#STAR 法则#行为面试#求职

鸿蒙分布式面试 25 问:软总线、应用流转与跨设备数据同步

鸿蒙分布式面试 25 问:软总线、应用流转与跨设备数据同步
关键词鸿蒙分布式、软总线、应用流转、分布式数据库、跨设备协同

如果问”鸿蒙和其他移动操作系统最大的区别是什么”,标准答案只有一个:分布式。Android 和 iOS 的生态是”设备各自为战”,鸿蒙从内核层就把”多设备协同”当成一等公民来设计。

这也是鸿蒙面试里最容易被问懵的一块——很多开发者只做过单设备应用,一遇到”分布式软总线””应用流转””跨设备数据同步”就答不上来。本文把这块的核心概念、实现方式和典型追问梳理清楚。

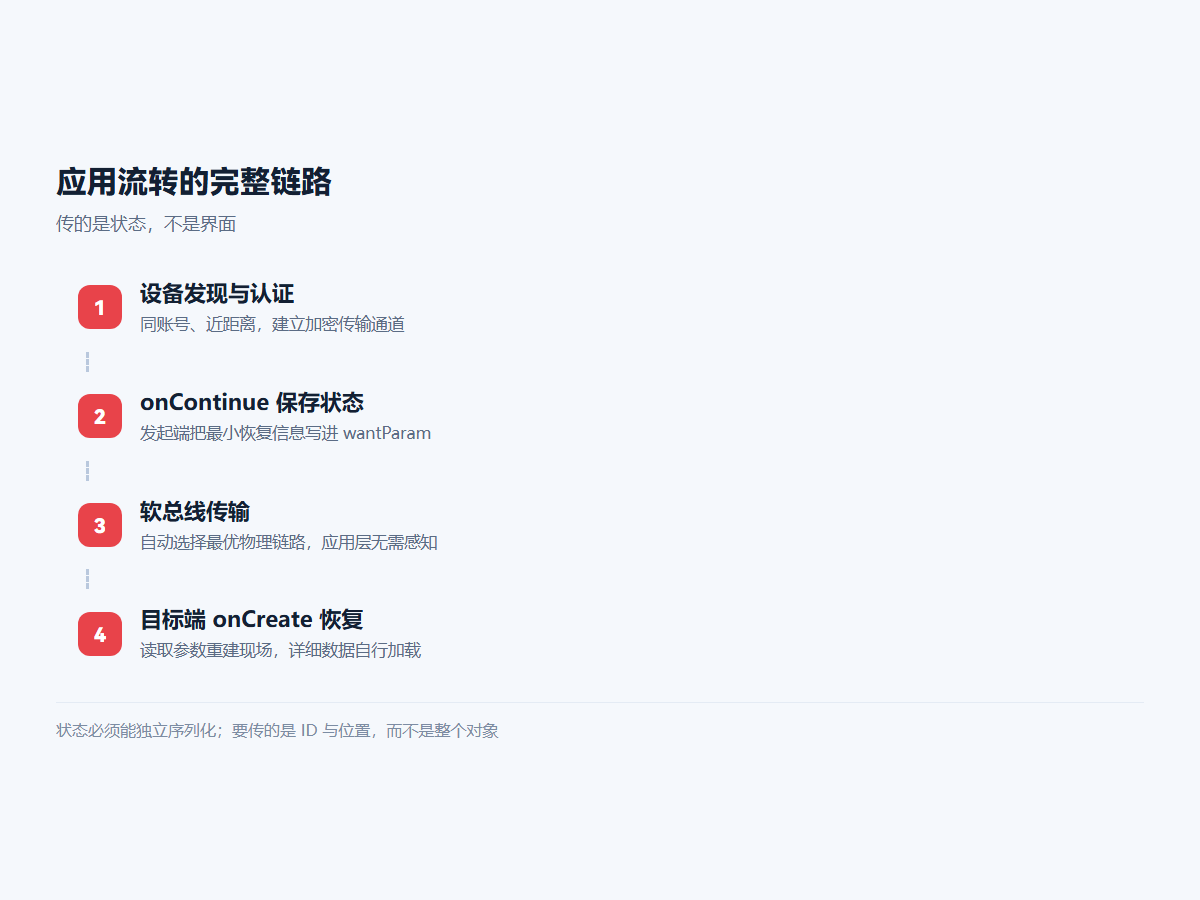
应用流转的完整链路
应用流转:发现认证 → onContinue 保存 → 软总线传输 → 目标端恢复

一、分布式软总线:理解一切的基础

Q1:什么是分布式软总线?

可以理解为把同一账号下、相互可信的多台设备,虚拟成一台”超级终端”。应用开发时不需要关心设备之间用的是 Wi-Fi、蓝牙还是 USB,软总线会自动完成设备发现、连接、组网和传输通道选择

它解决的是三个具体问题:

  1. 发现:附近的设备如何互相感知(基于 Wi-Fi P2P、蓝牙等物理通道)。
  2. 连接:如何建立认证过的、安全的传输链路(设备间互信认证)。
  3. 通信:如何屏蔽底层链路差异,向上提供统一的传输接口。

高分表述:“软总线对应用层屏蔽了物理链路的差异,开发者调用的是’设备 A 到设备 B 的通信’,而不是’通过蓝牙还是 Wi-Fi 通信’。”类比的话,它有点像局域网里的”服务发现 + RPC”的组合,但下沉到了系统层。

Q2:设备发现与认证是怎么做的?

需要满足几个前提条件:

  • 设备登录同一个华为账号(同一账号体系是信任基础)。
  • 处于同一局域网或近距离范围内(蓝牙/Wi-Fi 可及)。
  • 开启蓝牙与 Wi-Fi(底层发现机制依赖它们)。

认证通过后设备间建立加密传输通道。这一步由系统完成,应用只需要申请分布式设备发现与协同相关的权限,并调用系统提供的能力。

Q3:需要申请哪些权限?

// module.json5 中声明
{
  "requestPermissions": [
    { "name": "ohos.permission.DISTRIBUTED_DATASYNC" },        // 分布式数据同步
    { "name": "ohos.permission.DISTRIBUTED_SOFTBUS_CENTER" },  // 软总线中心
    { "name": "ohos.permission.GET_DISTRIBUTED_DEVICE_INFO" }  // 获取设备信息
  ]
}

要点:分布式相关权限属于较高级别的权限,需要在应用市场申请,且必须在代码中做动态申请与用户授权,声明了不代表直接生效。

二、应用流转:跨设备迁移

Q4:什么是应用流转(Continuation)?

把一个正在运行的应用(连同它的界面状态),从设备 A 迁移到设备 B 上继续运行。典型场景:手机上看着的视频,一碰平板就切换到平板上继续播。

核心 API 是 UIAbility 的两个回调:

import { UIAbility } from '@kit.AbilityKit'
import { BusinessError } from '@kit.BasicServicesKit'

export default class EntryAbility extends UIAbility {
  // 1. 发起端:保存状态,系统把它带到目标设备
  onContinue(wantParam: Record<string, Object>): AbilityConstant.OnContinueResult {
    wantParam['videoId'] = this.currentVideoId
    wantParam['playPosition'] = this.player.currentTime
    return AbilityConstant.OnContinueResult.AGREE   // 同意流转
  }

  // 2. 目标端:恢复状态
  onCreate(want: Want, launchParam: AbilityConstant.LaunchParam): void {
    if (want.parameters?.['videoId']) {
      this.currentVideoId = want.parameters['videoId'] as string
      this.startPosition = want.parameters['playPosition'] as number
    }
  }
}

关键点:onContinue 里返回 AGREE 表示允许流转;返回 REJECT 则拒绝(比如当前正处于支付等不适合迁移的界面)。状态通过 wantParam 传递,数据量应控制在较小范围。

Q5:流转时状态保存有什么限制?

  • 只能传可序列化的数据,不能传对象实例、函数、闭包。
  • 数据量有上限,通常建议控制在几十 KB 以内,只传”恢复现场所需的最小信息”(ID + 位置 + 少量上下文),详细数据由目标端自行从网络或分布式数据库加载。
  • 耗时操作不要在 onContinue 里做,它必须快速返回,否则流转会卡顿。

Q6:流转和”跨设备启动”有什么区别?

  • 流转(Continue):强调连续性——原设备上通常会退出,状态被带走。
  • 跨设备启动(StartAbility):只是在另一台设备上新开一个界面,原设备状态不受影响,更像”遥控器”式的协同。
// 跨设备启动:指定目标设备的 deviceId
const want: Want = {
  deviceId: targetDeviceId,        // 目标设备 ID
  bundleName: 'com.example.app',
  abilityName: 'EntryAbility',
  parameters: { docId: '123' }
}
context.startAbility(want).catch((err: BusinessError) => {
  console.error(`跨设备启动失败:${err.code}`)
})

三、分布式数据:跨设备状态同步

Q7:分布式数据库(KV Store)怎么用?

import { distributedKVStore } from '@kit.ArkData'

// 1. 创建 KVManager
const kvManager = distributedKVStore.createKVManager({
  bundleName: 'com.example.app',
  context: this.context
})

// 2. 获取分布式数据库(指定 multiUser 与 securityLevel)
const options: distributedKVStore.Options = {
  createIfMissing: true,
  encrypt: true,
  backup: false,
  kvStoreType: distributedKVStore.KVStoreType.SINGLE_VERSION,
  securityLevel: distributedKVStore.SecurityLevel.S2
}
const kvStore = await kvManager.getKVStore<string>('notes', options)

// 3. 写入会自动同步到同组网下的其他设备
await kvStore.put('note-1', JSON.stringify({ title: '购物清单', items: [...] }))

// 4. 订阅数据变更(包括其他设备改的)
kvStore.on('dataChange', distributedKVStore.SubscribeType.SUBSCRIBE_TYPE_ALL,
  (data) => {
    for (const entry of data.insertEntries) {
      console.info(`新增/变更:${entry.key}`)
      // 更新 UI
    }
    for (const entry of data.deleteEntries) {
      console.info(`删除:${entry.key}`)
    }
  })

// 5. 手动指定同步到哪些设备
const deviceIds = ['device-xxx', 'device-yyy']
await kvStore.sync(deviceIds, distributedKVStore.SyncMode.PUSH_PULL)

要点:SINGLE_VERSION 是单版本数据库(同一个 key 只保留最新值,适合状态同步);DEVICE_COLLABORATION 是设备协同数据库(按设备维度组织数据,适合多设备各写各的)。选错类型会导致数据被意外覆盖。

Q8:数据冲突怎么解决?

这是分布式场景最核心的问题。鸿蒙的 KV Store 默认策略是最后写入胜出(Last Write Wins)——以时间戳较新的修改为准。

如果业务上不能接受这种粗粒度策略,需要在应用层做冲突处理

  1. 按设备分区:用 DEVICE_COLLABORATION 类型,每个设备写自己的 key 空间(如 {deviceId}:{noteId}),从根本上避免写冲突
  2. 业务版本号:value 里带上版本号与更新时间,读取时比较并做合并。
  3. CRDT 思路:把数据结构设计成天然可合并的(如带逻辑时钟的增量操作日志)。
  4. 明确业务语义:某些场景下”谁最后操作听谁的”本来就是合理语义,那就接受默认策略,不必过度设计。

加分点:主动说明”离线修改 + 重新联网后的合并”这个场景。两台设备各自离线编辑了同一条记录,重新组网后必然冲突。能想到这一层,说明真的理解分布式数据的难点在哪。

Q9:安全等级(SecurityLevel)是什么?

分布式数据同步涉及跨设备传输,鸿蒙用安全等级来约束”什么样的数据可以在什么样的设备之间流动”。

  • 等级从 S0(最低)到 S4(最高,需硬件级安全能力)。
  • 设备安全等级必须达到数据库的等级要求,才能参与该数据库的同步。
  • 实践中常用 S2(需要设备具备基本的完整性保护能力)。

意义:防止敏感数据(如支付信息)同步到安全性不足的设备上。这是个常见的加分点,很多人完全不知道这个机制的存在。

四、分布式能力进阶

Q10:除了数据同步,还有哪些分布式能力?

  • 分布式文件:跨设备访问文件,用统一的 URI 访问远端设备上的文件。
  • 分布式硬件:调用其他设备的硬件能力——用平板的摄像头、用手表的传感器、用电视的扬声器。这是”超级终端”体验的核心。
  • 分布式任务调度:把计算任务调度到算力更强的设备上执行。
  • 跨设备剪贴板 / 拖拽:在一台设备复制、另一台设备粘贴;把文件从手机拖到平板。

Q11:分布式硬件(Device Virtualization)的原理?

把远端设备的硬件能力虚拟成本地硬件注册到硬件资源池里。应用调用 Camera 相关 API 时,系统返回的是”当前最优的摄像头”——可能是本机的后置摄像头,也可能是平板上画质更好的那颗。

关键点:应用代码不需要改,还是调用标准的相机 API,只是系统把硬件选择权接管了。这是软总线之上的一层抽象。

Q12:跨设备调用失败怎么排查?

给一套排查顺序:

  1. 设备侧:是否登录同一账号?蓝牙/Wi-Fi 是否开启?是否在同一局域网?设备是否解锁且亮屏?
  2. 权限侧:权限是否已在 module.json5 声明?是否完成了动态申请并获用户授权?是否通过了应用市场的权限审核?
  3. 安全等级:数据库的安全等级是否超过了目标设备的能力等级?
  4. API 侧deviceId 是否正确且未过期(设备 ID 会变化,不要硬编码或长期缓存)?
  5. 日志侧:看 BusinessError.code,对照官方错误码表定位;用 hilog 打点跟踪调用链。

五、设计层面的追问

Q13:做一个跨设备应用,架构上要注意什么?

  1. 状态与 UI 分离:跨设备迁移本质是”状态迁移 + UI 重建”,状态必须能被完整、独立地序列化出来。把状态耦合在 UI 组件里,流转必然出问题。
  2. 设备能力适配:手机竖屏、平板横屏、车机大字体、手表圆形屏——布局必须是响应式的。推荐用自适应布局 + 响应式布局能力(断点、栅格、媒体查询),而不是为每种设备写一套代码。
  3. 输入方式差异:手机是触摸,车机要考虑语音,手表要考虑表冠。交互设计要跟着设备走。
  4. 降级策略必须假设”只有一台设备”也能用。分布式能力是增强,不是前提——否则用户在没有第二台设备时完全无法使用。
  5. 数据量控制:跨设备传输有成本和延迟,只同步必要的增量,不要什么都往分布式数据库里塞。

Q14:分布式带来的性能开销怎么控制?

  • 减少同步频率:高频变更的数据不该走分布式同步(比如播放进度每秒更新一次,会持续触发跨设备传输)。只在关键节点同步(暂停、切集、退出)。
  • 数据分片:大文档不要存成一个大 value,拆成小单元,只同步改动的部分。
  • 订阅粒度收敛:订阅范围过大会收到大量无关变更通知,浪费 CPU 和电量。
  • 传输量预估:跨设备传输经由无线链路,延迟和带宽都远不如本地内存,设计时要按”网络调用”的心态来对待,而不是按”本地读写”。

六、小结

鸿蒙分布式这一块的答题主线是“屏蔽差异 + 状态可迁移”:软总线屏蔽了物理链路的差异,分布式数据对象屏蔽了”数据在哪台设备上”的差异,而应用流转要求把状态从 UI 里彻底剥离出来——因为跨设备迁移传的永远是状态,不是界面。

准备策略:亲手做一次”手机 → 平板”的流转,把 onContinueonCreate 的配对、分布式 KV Store 的订阅回调走通一遍。这块内容看文档很难建立直觉,跑通一次胜过背十道题。


参考:HarmonyOS 分布式开发指南应用接续(流转)文档分布式 KV 存储文档。API 与安全等级要求随版本演进,请以所用 SDK 版本的官方文档为准。

标签

#鸿蒙面试题#分布式#软总线#面试

鸿蒙 ArkTS 面试 25 问:语言约束、类型系统与并发模型

鸿蒙 ArkTS 面试 25 问:语言约束、类型系统与并发模型
关键词鸿蒙面试题、ArkTS、TaskPool、Worker、并发模型、ArkUI 状态管理

鸿蒙面试题里,ArkTS 语言特性与并发模型是最能区分”写过 Demo”和”做过项目”的一块。原因很简单:ArkTS 不是 TypeScript,它在 TS 的基础上加了静态约束;而鸿蒙的并发模型(TaskPool / Worker)和传统线程模型差异明显,很多人只会用 async/await,一问到跨线程数据传递就答不上来。

本文按语言约束 → 类型系统 → 并发模型 → 线程通信 → 常见坑组织,每题给出可直接口述的答案。

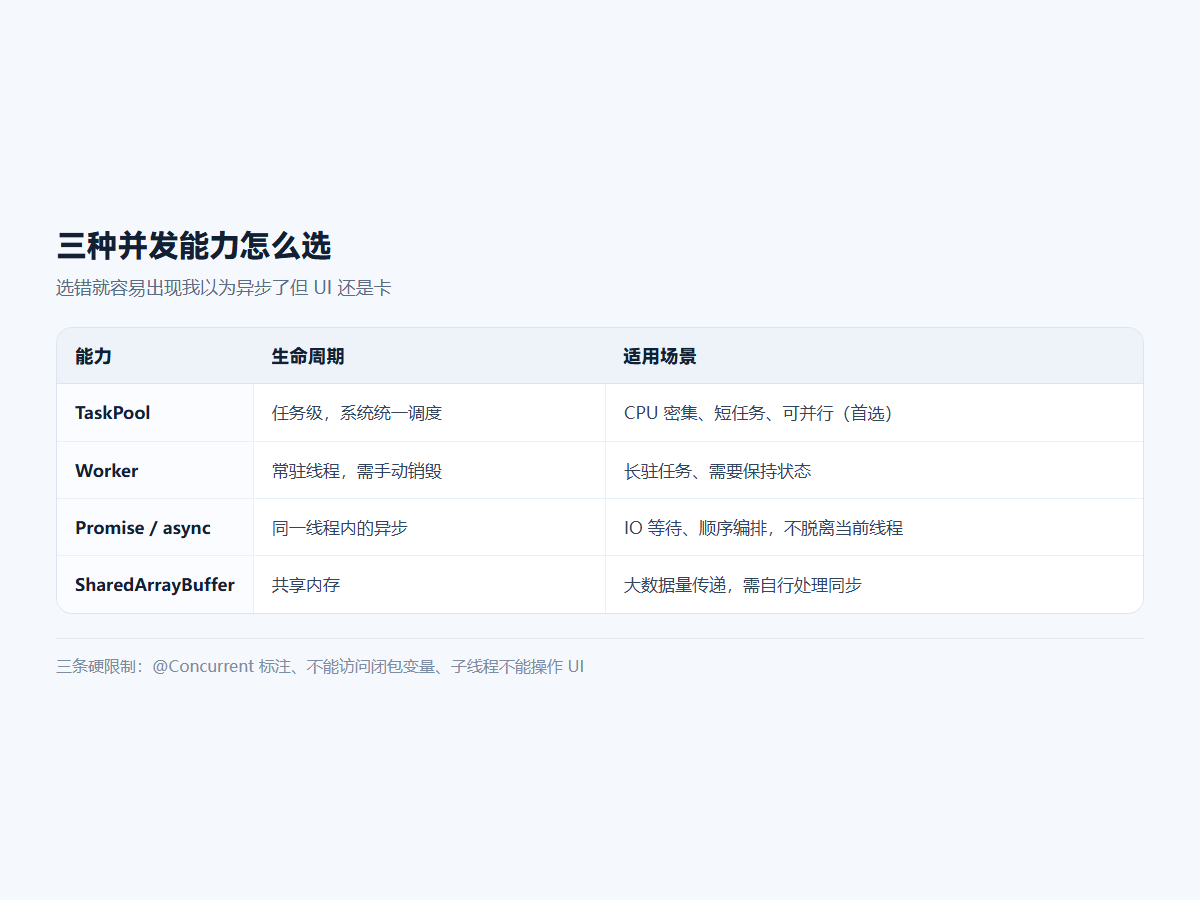
三种并发能力怎么选
Promise / TaskPool / Worker 与共享内存的能力定位对比

一、ArkTS 与 TypeScript:到底差在哪

Q1:ArkTS 是 TypeScript 的超集还是子集?

严格说是”受限子集 + 扩展”。ArkTS 基于 TypeScript 语法,但主动砍掉了一部分动态特性,同时增加了自己的语法(装饰器、ArkUI 声明式描述)

被限制的核心原因只有一个:为了在编译期进行更激进的优化,并保证运行时行为可预测。ArkTS 的编译目标是确定性强、性能可预期的运行环境,动态特性会让这些优化失效。

Q2:具体哪些 TS 特性在 ArkTS 里不能用?

受限特性 典型写法 ArkTS 的处理
动态增删属性 obj.newProp = 1 禁止,对象结构须在定义时确定
结构化类型(鸭子类型) 隐式结构兼容 采用名义类型,需显式声明类型关系
any / unknown 滥用 let x: any 不推荐 / 受限,需显式类型
运行期修改对象布局 delete obj.a 禁止
部分高级类型体操 条件类型、映射类型等 支持有限,复杂类型运算不保证

高分表述:“ArkTS 用’牺牲一部分 TS 的动态灵活性’,换取了’编译期可确定的对象布局’。”这句话能解释后面几乎所有语法限制——包括为什么必须给属性初始值、为什么不能动态加字段。

Q3:为什么 ArkTS 要求属性必须有初始值或明确可选?

// 不合规:属性未初始化且未标记可选
class User {
  name: string        // 报错:必须初始化或标记 ?
}

// 合规写法
class User {
  name: string = ''                 // 给默认值
  age?: number                      // 明确可选
  readonly id: string               // 构造函数中赋值
  constructor(id: string) { this.id = id }
}

原因:编译器需要为每个类生成固定的对象布局(隐藏类)。如果属性可以在运行期才出现,属性访问就无法优化成固定偏移量的内存读取,只能退化成哈希查找,性能大幅下降,也让 AOT 编译难以进行。

二、类型系统:名义类型是核心差异

Q4:什么是名义类型(Nominal Typing)?和结构类型有什么不同?

interface PointA { x: number; y: number }
interface PointB { x: number; y: number }

// TypeScript(结构类型):结构相同即可赋值,编译通过
let a: PointA = { x: 1, y: 2 }
let b: PointB = a          // OK

// ArkTS(名义类型):需要显式声明类型关系
interface PointB extends PointA { }   // 或用 implements
let b: PointB = a as PointB           // 需要显式转换

影响:从 TS 迁过来的代码,很多隐式兼容的赋值会报错。处理方式是用 extends/implements 显式建立关系,或适度重构类型定义,而不是到处 as 强转。

Q5:as 类型转换在 ArkTS 里有什么限制?

  • 只能在有继承/实现关系的类型之间转换,或者用于可空类型断言obj!.prop)。
  • 不能像 TS 那样用 as any 绕过类型检查——ArkTS 对 any 的支持是受限的。
  • 优先用类型守卫instanceoftypeof)做安全收窄,而不是强转。

Q6:泛型与空安全怎么落地?

// 泛型约束
function getFirst<T extends object>(list: T[]): T | undefined {
  return list.length > 0 ? list[0] : undefined
}

// 空安全:可空类型必须处理
let name: string | undefined = getName()
// let len = name.length            // 报错:可能为 undefined
let len = name?.length ?? 0         // 正确:可选链 + 空值合并

if (name !== undefined) {
  console.info(name.length)         // 收窄后安全
}

要点:ArkTS 的空安全是编译期强制的,与 Kotlin/Swift 的可空类型思路一致。养成用 ?. ?? 的习惯,比到处加 ! 断言更可取。

三、并发模型:鸿蒙面试的核心区

Q7:鸿蒙有几种并发能力?怎么选?

能力 定位 生命周期 适用场景
TaskPool 任务池,系统统一调度 任务级,无需手动管理 首选:CPU 密集、短任务、可并行
Worker 独立的常驻线程 需手动创建/销毁 长驻任务、需要保持状态、耗时后台任务
Promise/async 同一线程内的异步 不脱离主线程:IO 等待、顺序编排

一句话选型:能用 TaskPool 就用 TaskPool,需要常驻才用 Worker,只是等 IO 用 Promise 就够了。很多人的误区是把 async/await 当成”多线程”——它只是不阻塞当前线程的等待,实际执行仍在原线程。

Q8:TaskPool 怎么用?有什么限制?

import { taskpool } from '@kit.ArkTS'

@Concurrent
function heavyCompute(data: number[]): number {
  // 这个函数运行在任务池的工作线程里
  let sum = 0
  for (const v of data) sum += v * v
  return sum
}

async function run() {
  const data = generateLargeArray()
  // 派发任务,返回 Promise
  const result = await taskpool.execute(heavyCompute, data) as number
  console.info(`结果:${result}`)

  // 批量执行多个任务
  const tasks = chunks.map(c => new taskpool.Task(heavyCompute, c))
  const results = await taskpool.execute(tasks) as number[]
}

三个硬性限制必须记住:

  1. 必须用 @Concurrent 装饰器标注并发函数。
  2. 函数体内不能访问外部闭包变量,所有输入只能通过参数传入。
  3. 不能使用线程本地存储、不能操作 UItaskpool 工作线程里没有 UI 上下文

另外任务执行有时间上限(长耗时任务建议用 Worker),且系统会根据负载动态调整工作线程数量,不要依赖固定并发数做业务假设。

Q9:Worker 和 TaskPool 的数据传递有什么区别?

两者都不是共享内存,都通过结构化克隆(序列化/反序列化)传递数据。区别在于通信模型:

  • TaskPool:一次性派发任务并拿回结果,模型简单,适合无状态计算。
  • Worker:通过 postMessage / onmessage 双向持续通信,Worker 内可以持有长期状态
// 主线程
const worker = new worker.ThreadWorker('entry/ets/workers/MyWorker.ets')
worker.onmessage = (e: MessageEvents) => {
  console.info(`收到:${e.data}`)
}
worker.postMessage({ cmd: 'start', payload: data })
// 用完必须销毁,否则线程常驻
worker.terminate()

// Worker 线程(MyWorker.ets)
workerPort.onmessage = (e: MessageEvents) => {
  const result = process(e.data.payload)
  workerPort.postMessage(result)
}

追问”能不能共享内存避免拷贝?“——可以,鸿蒙提供了 SharedArrayBuffer / Atomics 等能力用于大数据量的共享,但需要自己处理同步(用 Atomics 做原子操作与等待通知)。这是进阶考点,能说出来说明做过真实的性能优化。

Q10:为什么不能在子线程更新 UI?

因为 UI 组件树不是线程安全的。ArkUI 的组件树在主线程构建和刷新,如果允许多线程并发修改,会需要大量锁来保证一致性,代价远超收益。这也是几乎所有 UI 框架的共识(Android、iOS、Flutter 都是单线程 UI 模型)。

正确做法:子线程算完 → 把结果传回主线程 → 更新状态变量 → 触发 UI 刷新。耗时任务结束后通常需要切回主线程更新 @State

四、状态管理与渲染:常见的连环追问

Q11:@State@Prop 的区别?

  • @State:组件私有状态,变化时触发该组件及其子组件的重新渲染。必须初始化。
  • @Prop单向从父组件传入,子组件内部修改不会同步回父组件。适合”父给子传值,子只读或本地改”。
  • @Link双向绑定,子组件的修改会同步回父组件的 @State。调用时要用 $ 语法传引用。
@Component
struct Child {
  @Prop countProp: number = 0      // 单向
  @Link countLink: number          // 双向
  build() { /* ... */ }
}

@Component
struct Parent {
  @State count: number = 0
  build() {
    Child({ countProp: this.count, countLink: $count })   // Link 用 $
  }
}

Q12:深拷贝 vs 浅拷贝在状态更新里的坑?

核心陷阱:直接修改对象内部字段不会触发刷新,必须整体替换引用。

// 反例:改了字段但引用没变,UI 不会刷新
this.user.name = 'Tom'           // @State user: User,不会触发更新

// 正例:整体替换
this.user = new User('Tom', this.user.age)
// 或展开语法
this.user = { ...this.user, name: 'Tom' }

// 数组的同理
this.list.push(item)                    // 不一定触发
this.list = [...this.list, item]        // 正确

原理:@State 的观察粒度是”引用是否变化”(浅观察)。深层的嵌套对象变化需要配合 @Observed + @ObjectLink 才能被观察到。

Q13:@Observed@ObjectLink 解决什么问题?

@Observed
class User {
  name: string
  age: number
  constructor(name: string, age: number) { this.name = name; this.age = age }
}

@Component
struct UserCard {
  @ObjectLink user: User        // 能观察到嵌套对象内部的属性变化
  build() {
    Row() {
      Text(this.user.name)
      Button('改名').onClick(() => { this.user.name = 'Jerry' })  // 会刷新
    }
  }
}

关键点:@Observed 装饰@ObjectLink 装饰子组件中的变量,且不能在子组件里初始化(必须由父组件传入)。这套组合是处理”嵌套对象/数组元素”刷新的标准方案。

五、常见踩坑清单

Q14:ArkTS 里最容易犯的错误有哪些?

  1. async/await 当多线程用——它不脱离当前线程,CPU 密集任务照样卡 UI。
  2. 在子线程里直接改 @State——跨线程操作 UI 未定义行为,必须切回主线程。
  3. 直接改对象字段期望刷新——必须整体替换引用,或用 @Observed/@ObjectLink
  4. 在 build 里做耗时操作——build() 会被频繁调用,必须保持轻量,且不允许有副作用
  5. 在 build 里改状态——会造成无限重建循环
  6. Worker 忘了 terminate——线程常驻,内存和 CPU 持续占用。
  7. 把大量数据通过 postMessage 频繁传递——序列化开销大,大数据应考虑共享内存或分批。

Q15:怎么排查”UI 不刷新”?

给一套排查顺序:

  1. 确认状态变量是否用了正确的装饰器@State / @Link / @ObjectLink)。
  2. 确认是整体替换了引用而不是只改了内部字段。
  3. 确认修改发生在主线程(子线程回调里改状态不会生效)。
  4. 确认被观察的对象类型是否支持观察(基础类型、数组、@Observed 类)。
  5. 用 DevEco Studio 的 ArkUI Inspector 看组件树与状态,确认数据是否真的变了。

六、小结

ArkTS 与并发这一块的答题主线是“约束及其理由”:语言层面的每一条限制(禁止动态属性、名义类型、强制初始化)都指向同一个目的——让编译器能在编译期确定对象布局,从而做激进优化。并发层面的三条能力(Promise / TaskPool / Worker)则对应“等待”、”短任务并行”、”长驻任务”三种需求,选错就容易出现”我以为异步了但 UI 还是卡”这种典型问题。

准备策略:把”ArkTS 不是 TypeScript”和”async 不等于多线程”这两句话讲透,再配上 TaskPool 与 Worker 的选型对照,这一块基本就稳了。


参考:HarmonyOS ArkTS 开发指南TaskPool 官方文档。语言规范与 API 随版本迭代,请以所用 SDK 版本的官方文档为准。

标签

#鸿蒙面试题#ArkTS#并发#面试

iOS 面试高频 25 问:Runtime、RunLoop、内存管理与 SwiftUI

iOS 面试高频 25 问:Runtime、RunLoop、内存管理与 SwiftUI
关键词iOS 面试、Objective-C Runtime、消息转发、RunLoop、ARC、SwiftUI

iOS 面试的原理题有几个”经典得不能再经典”的考点:Runtime、RunLoop、内存管理(ARC)、Block、响应链、SwiftUI。这些常年不变,但考察深度差异极大——同样问”weak 的实现原理”,有人只答”自动置 nil”,有人能讲清 SideTable 与弱引用表

本文逐题给出标准答法、追问陷阱和那句”面试官想听的话”。版本背景:iOS 27 处于发布窗口,Swift 与 SwiftUI 的迭代节奏已趋稳。

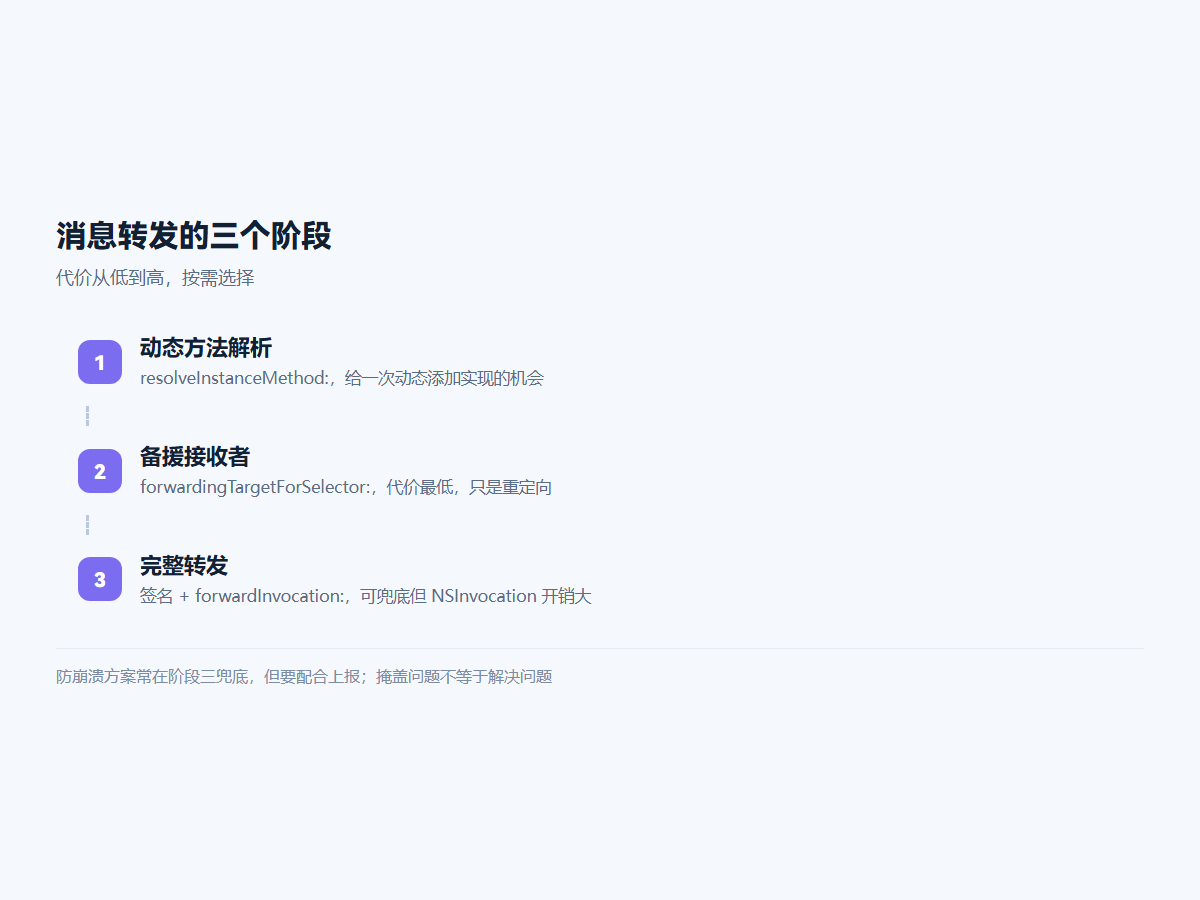
消息转发的三个阶段
OC 消息转发:动态方法解析 → 备援接收者 → 完整转发

一、Runtime:Objective-C 的动态性从哪来

Q1:什么是 Runtime?消息发送的完整过程?

Objective-C 的方法调用不是直接的函数地址跳转,而是消息发送。编译器会把 [obj doSomething] 转成:

objc_msgSend(obj, @selector(doSomething))

// 其执行路径(简化):
// 1. 快速查找:到 receiver 所属类的 cache(方法缓存哈希表)里找 IMP
//    → 命中则直接跳转
// 2. 慢速查找:缓存没命中,走 lookUpImpOrForward
//    → 在本类的 method_list 里二分/线性查找
//    → 没找到则沿 superclass 链一路向上,直到 NSObject
// 3. 仍未找到 → 进入"消息转发"三阶段

关键点:方法解析发生在运行时,不是编译时。这就是 OC 动态性的来源——你可以在运行时给类加方法、交换实现(Method Swizzling)、甚至在消息转发阶段把消息转给别的对象。

Q2:消息转发的三个阶段?

  1. 动态方法解析+resolveInstanceMethod: / +resolveClassMethod:。给一次机会动态添加方法实现class_addMethod)。常用于 @dynamic 属性的惰性实现。
  2. 备援接收者-forwardingTargetForSelector:。返回另一个能处理该消息的对象。这是三个步骤里代价最低的,只是重定向,不创建 NSInvocation。
  3. 完整转发-methodSignatureForSelector: 返回方法签名,-forwardInvocation: 拿到 NSInvocation 做任意处理(转发给多个对象、记录日志、吞掉)。
// 阶段 2:快速转发(性能最好)
- (id)forwardingTargetForSelector:(SEL)aSelector {
    if (aSelector == @selector(heavyCompute)) {
        return self.computeEngine;   // 交给别人干
    }
    return [super forwardingTargetForSelector:aSelector];
}

// 阶段 3:完整转发(可应对未实现崩溃的兜底)
- (NSMethodSignature *)methodSignatureForSelector:(SEL)aSelector {
    return [NSMethodSignature signatureWithObjCTypes:"v@:"];
}
- (void)forwardInvocation:(NSInvocation *)invocation {
    NSLog(@"未实现的方法:%@", NSStringFromSelector(invocation.selector));
}

加分点:很多”防崩溃”方案就是在阶段 3 兜底。但要主动说明代价——NSInvocation 的创建开销较大,且掩盖问题不等于解决问题,线上应当配合上报,不能默默吞掉。

Q3:isKindOfClassisMemberOfClass 的区别?

  • isKindOfClass: 判断对象是否为该类或其子类的实例(沿继承链比较)。
  • isMemberOfClass: 只判断是否恰好是该类的实例(只比较当前类)。

有个经典陷阱题:对类对象调用时会走元类(meta class)链。答这类题时要分清“实例方法版本走类链,类方法版本走元类链”

Q4:Category 和 Extension 的区别?

维度 Category(分类) Extension(扩展/匿名分类)
编译时机 运行时合并进类 编译时
能否加属性 只能加方法声明,属性需关联对象 可以加实例变量与属性
需要源码 不需要 需要(写在 .m 里)
典型用途 给系统类加方法、拆分大类 隐藏私有方法与属性

追问”Category 的同名方法会怎样“——后编译的 Category 会”覆盖”先编译的(实际是方法列表顺序靠前,查找时先命中)。这个行为是不确定的,不要依赖它。这也是为什么给系统类写 Category 时方法名必须加前缀

二、内存管理:ARC 到底做了什么

Q5:ARC 下还有内存泄漏吗?

有,而且很常见。ARC 只是自动管理”引用计数”,它解决不了循环引用。三类典型泄漏:

  1. 循环引用:对象互相强引用,或形成了环(A→B→C→A)。
  2. Block 捕获 self:Block 强引用 self,self 又持有这个 Block。
  3. 定时器 / 通知未清理NSTimer(iOS 10 前的 target-action 形式)强引用 target,NotificationCenter 的 block 式观察者持有 self。
// 循环引用:self -> completion -> self
self.completion = ^{
    [self doSomething];       // Block 强捕获 self
};

// 解法:weak-strong dance
__weak typeof(self) weakSelf = self;
self.completion = ^{
    __strong typeof(weakSelf) strongSelf = weakSelf;
    if (!strongSelf) return;              // 已释放则直接返回
    [strongSelf doSomething];             // 保证执行期间不会被释放
};

// NSTimer:iOS 10+ 用 block 版 API,避免 target 被强引用
self.timer = [NSTimer scheduledTimerWithTimeInterval:1.0 repeats:YES block:^(NSTimer *t) {
    [weakSelf tick];
}];
// 并且要在 dealloc / viewWillDisappear 里 invalidate

Q6:weak 为什么会在对象释放后自动变成 nil?

这是 Runtime 层面的一张表在起作用。简化后的结构是:

  • 系统维护若干张 SideTable(全局哈希表,按对象地址分桶,带锁保证线程安全)。
  • 每个 SideTable 里有 weak_table_t:以对象地址为 key,value 是所有指向它的 weak 指针地址的集合(weak_entry_t)
  • 对象释放时,Runtime 走 dealloc → objc_destructInstance → clearDeallocating查出该对象对应的所有 weak 指针地址,把它们逐个置为 nil,然后从表中移除记录。

所以 weak 的代价是额外的一次查表与置 nil 操作,比 assign(不置 nil,会产生悬垂指针)安全但略慢。

Q7:strongcopyassignweak 怎么选?

  • strong:默认,持有对象,引用计数 +1。
  • copy建立不可变副本NSStringNSArrayNSDictionary 属性必须用 copy——否则一个 NSMutableString 赋进来后,外部改动会意外影响属性值。
  • assign:只做简单赋值,不置 nil。用于基本数据类型(int、CGFloat、结构体)。修饰对象会产生悬垂指针。
  • weak:不持有,对象释放后自动置 nil。用于 delegate、IBOutlet 子视图、Block 中打破循环引用。

高频追问:”delegate 为什么用 weak 而不用 strong?“——因为典型结构是 Controller 持有 ViewViewdelegate 指回 Controller。若 delegate 是 strong,就形成了循环引用,两者都释放不掉。

Q8:AutoreleasePool 什么时候释放?

autorelease 的对象被加入当前的自动释放池,池子在一次 RunLoop 迭代结束时(即将进入休眠前)被 pop,池内对象收到一次 release

实践中真正需要注意的是循环内创建大量临时对象

// 反例:百万次循环产生的临时对象堆积到循环结束才释放,内存峰值飙升
for (int i = 0; i < 1000000; i++) {
    NSString *s = [NSString stringWithFormat:@"item-%d", i];
    // ...
}

// 正例:手动加自动释放池,及时释放
for (int i = 0; i < 1000000; i++) {
    @autoreleasepool {
        NSString *s = [NSString stringWithFormat:@"item-%d", i];
        // ...
    }
}

三、RunLoop:事件循环的骨架

Q9:RunLoop 是什么?和线程什么关系?

RunLoop 是一个事件处理循环:有事件就处理,没事件就休眠。每条线程最多一个 RunLoop,主线程默认开启,子线程默认不开启(需要手动 [[NSRunLoop currentRunLoop] run] 或用 CFRunLoopRun()),且必须至少有一个 Source/Timer/Observer 才能维持运行。

一次循环的核心流程:

  1. 通知 Observer:即将进入 Loop
  2. 通知 Observer:即将处理 Timer / Source0
  3. 处理 Source0(触摸事件、performSelector:onThread:
  4. 若有 Source1(基于 mach port 的端口消息),跳到第 9 步
  5. 通知 Observer:即将休眠
  6. 休眠等待(内核态,通过 mach_msg 等待唤醒,不占 CPU)
  7. 被某个事件唤醒(Timer 到点、Source1 消息、GCD 回主线程等)
  8. 处理唤醒时收到的消息,回到第 2 步
  9. 通知 Observer:即将退出 Loop

Q10:RunLoop 有哪些实际应用?

  • NSTimer 精度问题:Timer 依赖 RunLoop,若当前正在处理耗时任务,Timer 会被顺延;滚动 scrollView 时 RunLoop 切到 UITrackingRunLoopMode,默认 mode 下的 Timer 不触发——解法是把 Timer 加到 NSRunLoopCommonModes
  • 常驻线程:给子线程加一个 NSPort 并启动 RunLoop,让它不退出(AFNetworking 旧版本用这个模式保活网络线程)。
  • 卡顿监控:向主线程 RunLoop 注册 Observer,监听 kCFRunLoopBeforeSourceskCFRunLoopAfterWaiting 之间的耗时,超时即判定为一次卡顿。
  • 滑动时延迟加载大图:把任务放进 NSDefaultRunLoopMode,滚动结束(切回默认 mode)后再执行,避免影响滚动帧率。

Q11:RunLoop 的 Mode 有什么用?

Mode 是一组「Source / Timer / Observer 的集合」,RunLoop 同一时刻只能运行在某一个 Mode 下,只会处理当前 Mode 里的事件。这种设计是为了隔离不同场景的事件源——滑动时只关心触摸,就不去处理默认模式下的定时器与网络回调,从而保证滚动优先级的帧率。

常见 Mode:kCFRunLoopDefaultModeUITrackingRunLoopModeNSRunLoopCommonModes(注意:CommonModes 不是一个真正的 Mode,而是一组”标记为 common”的 Mode 的同步机制)。

四、Block 与 GCD

Q12:Block 有哪几种类型?

  • __NSGlobalBlock__:没有捕获任何外部变量,存在全局区。
  • __NSStackBlock__:捕获了外部变量,分配在栈上(MRC 下)。
  • __NSMallocBlock__:栈上的 Block 被 copy 到堆上。ARC 下大部分情况会自动 copy。

追问”为什么 Block 要捕获变量的值而不是引用?“——因为 Block 可能在其定义的作用域之外执行(比如异步回调),栈上的局部变量届时已经失效,所以普通局部变量是按值捕获(const 拷贝)。需要修改它时,必须用 __block,编译器会把它包装成一个结构体,让内外共享同一份存储

Q13:__block__weak 的区别?

__block 解决”能不能改”,__weak 解决”要不要持有”,两者维度不同,经常一起用。

__block int counter = 0;          // 让 Block 内部能修改外部变量
__weak typeof(self) weakSelf = self;  // 让 Block 不强持有 self

Q14:GCD 的队列与死锁?

关键区分:dispatch_get_main_queue() 是串行队列。在主队列里同步向主队列派发任务,就会死锁——因为同步派发要求”立即执行”,而主队列正在执行当前的同步派发语句,任务永远排不到。

// 死锁:主线程执行,sync 到主队列
dispatch_sync(dispatch_get_main_queue(), ^{
    NSLog(@"永远不会执行");
});

// 安全:判断当前是否已在主队列
if (dispatch_queue_get_label(DISPATCH_CURRENT_QUEUE_LABEL) ==
    dispatch_queue_get_label(dispatch_get_main_queue())) {
    block();                                    // 直接执行
} else {
    dispatch_async(dispatch_get_main_queue(), block);
}

五、SwiftUI:2026 年的必考区

Q15:SwiftUI 和 UIKit 的根本区别?

  • 声明式:描述”UI 应该长什么样”,而不是”怎么一步步改成那样”。
  • 值类型视图Viewstruct 而非 class,轻量、无继承,靠组合而非继承扩展。
  • 状态驱动@State 变化触发 body 重新求值,框架 diff 出真实变更。
  • 与 UIKit 可互操作:通过 UIViewRepresentable / UIViewControllerRepresentable 双向桥接,老项目可以渐进迁移。

Q16:@State@Binding@ObservedObject@EnvironmentObject 怎么选?

属性包装器 所有权 适用场景
@State 拥有 视图私有的简单值(开关、输入文本)
@Binding 借用 子视图读写父视图的状态,双向传递
@ObservedObject 外部持有 引用类型的外部模型,需自己保证生命周期
@StateObject 拥有 视图首次创建时初始化的模型,生命周期与视图绑定
@EnvironmentObject 环境注入 跨多层视图共享,避免逐层传递

高频陷阱:”@ObservedObject@StateObject 的区别?“——@ObservedObject 不持有对象,视图重建时可能被意外重置(比如在父视图 body 里 ViewModel() 现场创建);@StateObject 只在视图首次创建时初始化一次,重建时保持。在视图内部创建的模型必须用 @StateObject

Q17:SwiftUI 的 body 会被频繁求值,怎么优化?

  • 拆分视图:把大 body 拆成小组件,让状态变化只影响真正依赖它的子树(缩小失效范围)。
  • 减少依赖:视图只声明它真正用到的状态,多余的依赖会导致无谓重算。
  • 给模型加粒度:使用 @Observable(Observation 框架)后,只有真正被读取的属性才会建立依赖,比 ObservableObject 的”整体发布”更精准。
  • 耗时计算外移:body 应当是纯函数且开销极小,重活放进 model 或异步任务。

六、小结

iOS 原理题的核心主线是“动态性 + 内存模型 + 事件循环”:Runtime 支撑了 OC 的一切动态能力,ARC 与 weak 表解决的是引用计数自动化的边界问题,RunLoop 是主线程响应用户与系统事件的心跳,SwiftUI 则代表着从命令式到声明式的范式转移。

准备建议:每条主线配一个真实案例——”Block 循环引用导致页面不释放,用 weak-strong dance 解决””滚动时 Timer 不触发,改到 CommonModes 才正常”。具体经历比完整背诵源码更能说明你真的做过。


参考:Apple 开发者文档SwiftUI 文档swift-corelibs-foundation。API 行为随系统版本演进,涉及生命周期与后台行为的请以目标版本的官方文档为准。

标签

#iOS 面试题#Runtime#RunLoop#面试

Android 面试高频 25 问:Handler、Binder、四大组件与 Compose

Android 面试高频 25 问:Handler、Binder、四大组件与 Compose
关键词Android 面试、Handler 机制、Binder、Activity 生命周期、Jetpack Compose

Android 面试的”原理题”有非常稳定的核心区:四大组件、Handler、Binder、View 绘制、内存泄漏、Compose。这些内容不随版本剧烈变动,但考察深度差异很大——同样问”Handler 原理”,有人说到 Looper 就停了,有人能讲清为什么主线程 Looper 死循环不会 ANR

本文按高频考点组织,每题给出”标准答法 + 追问陷阱 + 面试官想听的那句话”。版本背景:Android 17 已 GA,两端 target SDK 的年度升级窗口同时生效。

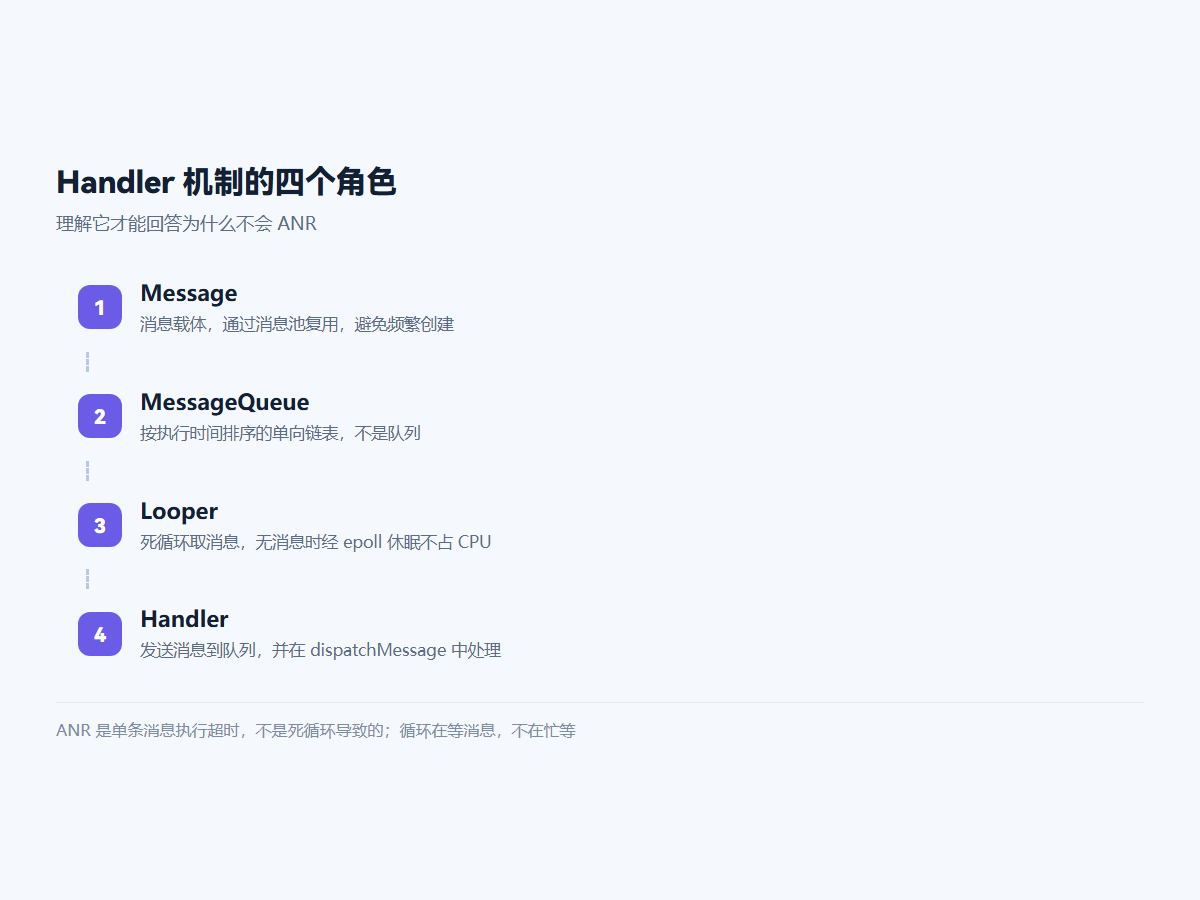
Handler 机制的四个角色
Handler 机制:Message → MessageQueue → Looper → Handler

一、Handler:面试的第一道分水岭

Q1:Handler 机制涉及哪几个类?各自做什么?

四个角色必须说全:

  • Message:消息载体。what/arg1/obj/target,以及用于复用的消息池obtain() 从链表中取,避免频繁创建对象)。
  • MessageQueue:按 when(执行时间)排序的单向链表。注意是链表不是队列,插入是按时间做有序插入。
  • Looper:持有 MessageQueue,loop() 方法里死循环取消息并分发。每个线程最多一个 Looper,用 ThreadLocal 保证线程隔离。
  • Handler:发送消息到 MessageQueue,并在 dispatchMessage() 里处理。
// loop() 的核心逻辑(简化)
public static void loop() {
    final Looper me = myLooper();
    final MessageQueue queue = me.mQueue;
    for (;;) {
        Message msg = queue.next();   // 没消息时在这里阻塞(nativePollOnce)
        if (msg == null) return;
        msg.target.dispatchMessage(msg);
        msg.recycleUnchecked();        // 回收进消息池
    }
}

Q2:主线程的 Looper 死循环为什么不会 ANR?

这是 Handler 最经典的追问,答不上来基本判定为”背过但没理解”

关键点:ANR 不是”卡住”,而是”该处理的事件没在规定时间内处理完”。主线程 Looper 的死循环,在没有消息时是通过 nativePollOnce 进入 epoll 等待睡眠的,不消耗 CPU;有消息到来时被唤醒继续执行。所谓 ANR,是某条消息(如 INPUT 事件、BroadcastReceiver.onReceive)执行超过阈值(输入事件 5s、前台广播 10s、Service 20s),而非循环本身。

一句话版:死循环在”等消息”,不在”忙等”;唤醒靠 Linux 的 epoll 机制;ANR 是单条消息执行超时,不是循环导致的。

Q3:Handler.postDelayed 是精确延时吗?

不是。它只是在 MessageQueue 里按 when = 当前时间 + delay 插入,到点后能否立即执行取决于前面有没有积压的消息。如果主线程正被一个耗时操作占着,延时会被顺延。此外系统还可能因为对齐唤醒(Alarm alignment)、Doze 模式做批量延迟。

需要精确计时的场景(如倒计时)应当用系统时间戳实时计算剩余值,而不是累加 postDelayed 的 delay。

Q4:Handler 引起内存泄漏的原因与解法?

泄漏链:延时消息 msg.target 持有 Handler → Handler 是非静态内部类,隐式持有 Activity → Activity 已 finish 但消息还在队列里 → Activity 无法回收。

// 反例:非静态内部类 + 延时消息
class MainActivity : AppCompatActivity() {
    private val handler = Handler(Looper.getMainLooper())   // 隐式持有 Activity
    override fun onCreate(...) {
        handler.postDelayed({ updateUI() }, 60_000)
    }
}

// 正例1:静态内部类 + 弱引用
class SafeHandler(activity: MainActivity) : Handler(Looper.getMainLooper()) {
    private val ref = WeakReference(activity)
    override fun handleMessage(msg: Message) {
        ref.get()?.updateUI()
    }
}

// 正例2:生命周期感知,销毁时清空消息
override fun onDestroy() {
    super.onDestroy()
    handler.removeCallbacksAndMessages(null)   // 关键:移除所有回调
}

二、Binder:Android 的 IPC 心脏

Q5:为什么 Android 用 Binder 而不用 Socket 或共享内存?

从三个维度对比:

维度 Binder Socket 共享内存
拷贝次数 1 次 2 次 0 次
安全性 内核校验 UID/PID 依赖上层协议 无访问控制
使用模型 C/S 架构,面向对象调用 字节流 需自行处理同步

要点展开:

  • 性能:Binder 通过 mmap 把内核缓冲区同时映射到内核空间和服务端用户空间,数据只需从发送方用户空间拷贝一次到内核,接收方直接读映射区。共享内存虽然零拷贝,但需要自己解决并发同步,且没有访问控制。
  • 安全:Binder 驱动在内核态记录调用方的 UID/PID,服务端可以据此做权限校验——这是 Android 权限体系的基石。Socket 和共享内存拿不到可靠的身份标识。
  • 易用性:Binder 是面向对象的(AIDL 生成的代理模式),调用远程方法像调用本地方法。

Q6:Binder 通信的完整流程?

  1. 注册:Server 向 ServiceManager(本身也是一个 Binder 服务,handle = 0)注册服务。
  2. 获取:Client 向 ServiceManager 查询,拿到服务的代理对象(BinderProxy)。
  3. 调用:Client 调用代理方法,数据打包成 Parcel,通过 transact() 发给 Binder 驱动。
  4. 驱动转发:驱动根据 handle 找到目标进程,拷贝一次数据,把请求加入服务端的 todo 队列,唤醒服务端 Binder 线程。
  5. 执行与返回:服务端在 onTransact() 中解包执行,结果沿原路返回。

同步调用时客户端线程会阻塞,所以要避免在主线程调用耗时远程方法。

Q7:AIDL 的 onewayin/out/inout 是什么?

  • oneway:异步调用,立即返回不阻塞,也不接收返回值。适用于”通知”型接口。
  • in:数据只从客户端流向服务端(默认)。
  • out:数据只从服务端写回客户端,客户端传入的对象内容不会被读取。
  • inout:双向。代价是两次序列化开销,实践中很少用

三、四大组件与生命周期

Q8:Activity 启动模式有哪几种?

  • standard:默认,每次都新建实例,压入启动它的那个任务栈。
  • singleTop栈顶复用。若目标已在栈顶则复用,回调 onNewIntent()。适合防止重复点击打开同一个页面。
  • singleTask栈内复用。若栈中已有实例,则把它上面的所有 Activity 全部出栈(clearTop),并回调 onNewIntent()。适合主页、登录页这类全局唯一的入口。
  • singleInstance独占一个任务栈,系统内全局唯一。适合来电界面、锁屏这类需要独立存在的页面。

追问”taskAffinity 有什么用“——它指定 Activity 归属的任务栈名,与 singleTaskallowTaskReparenting 配合使用时才生效,可以实现”把某个 Activity 挪到另一个任务栈”。

Q9:横竖屏切换时 Activity 的生命周期?

默认情况下会销毁重建onPause → onStop → onDestroy → onCreate → onStart → onResume

若配置 android:configChanges="orientation|screenSize",则不重建,只回调 onConfigurationChanged()

现代答法:不要靠 configChanges 逃避重建,而应该用 ViewModel 正确保存状态。ViewModel 的生命周期独立于 Activity 的配置变更,数据在重建后自动保留。这也是 Google 官方推荐的架构方式——把”配置变更”当成一次正常的生命周期事件来处理,而不是绕过它

Q10:Service 的两种启动方式有什么区别?

维度 startService bindService
生命周期 独立,需显式 stopService/stopSelf 随调用方,全部解绑即销毁
通信 单向,无直接回调 可通过 Binder 双向通信
典型场景 下载、播放(长期后台) 获取服务实例、跨进程调用

高频追问:后台限制。Android 8.0 起禁止后台应用创建后台服务,长期任务必须用前台服务(startForegroundService + 常驻通知),或改用 WorkManager 处理可延迟的后台工作。

Q11:BroadcastReceiver 的两种注册方式?

  • 静态注册(Manifest):应用未启动也能收到,但 Android 8.0 起大部分隐式广播被禁止静态注册(豁免列表内的除外)。
  • 动态注册registerReceiver):跟随组件生命周期,必须在 onDestroy/onStop 中反注册,否则内存泄漏。

四、View 绘制与性能

Q12:View 的绘制流程?

三个依次进行的阶段,由 ViewRootImpl 驱动:

  1. measure:递归测量,父 View 通过 MeasureSpec(模式 + 尺寸)把约束传给子 View,子 View 计算出自己的宽高并调用 setMeasuredDimension()
  2. layout:父 View 调用子 View 的 layout(l,t,r,b),确定四个顶点位置。
  3. draw:依次绘制背景 → 自身(onDraw)→ 子 View(dispatchDraw)→ 滚动条等装饰

MeasureSpec 三种模式必须记住:EXACTLY(精确值或 match_parent)、AT_MOST(wrap_content,上限为父的剩余空间)、UNSPECIFIED(无约束,常见于 ScrollView 内部、ListView 测量)。

Q13:为什么自定义 View 的 wrap_content 失效?

因为 View 的默认 onMeasure() 实现里,只要不是 EXACTLY 模式,就直接把父容器给的最大可用尺寸当成自己的尺寸——于是 wrap_content 表现得和 match_parent 一样。解法是重写 onMeasure,在 AT_MOST 模式下自己算出内容所需尺寸setMeasuredDimension()

Q14:UI 卡顿的原因与排查?

根因就两类:主线程做了耗时操作(IO、大量计算、JSON 解析、数据库查询),或绘制本身太重(布局层级过深、过度绘制、频繁触发 requestLayout)。

排查手段:Systrace / Perfetto 看主线程帧耗时、Layout Inspector 看层级、GPU 过度绘制调试看叠加层数、Choreographer.FrameCallback 做线上帧率监控、BlockedCanary 之类工具抓慢方法。

五、Jetpack Compose:2026 年的必考区

Q15:Compose 和传统 View 体系的根本区别?

  • 声明式:UI 是状态的函数 UI = f(state),状态变了自动重组,不需要手动 setText()
  • 无 View 实例:Compose 用 LayoutNode 树而非 View 树,没有 findViewById,也不需要 ViewHolder
  • 智能重组:只有读取了变化状态的可组合项才会重组,未读取的部分会被跳过(这是”重组作用域”的意义)。

Q16:什么是”状态提升”(State Hoisting)?

把状态从可组合项内部移到调用方,让可组合项变成无状态(stateless)的纯函数:参数进、事件出。

// 反例:状态藏在内部,调用方无法控制、难以复用和测试
@Composable
fun Counter() {
    var count by remember { mutableIntStateOf(0) }
    Button(onClick = { count++ }) { Text("$count") }
}

// 正例:状态提升,组件变成无状态的
@Composable
fun Counter(count: Int, onIncrement: () -> Unit) {
    Button(onClick = onIncrement) { Text("$count") }
}

// 调用方持有状态,单一数据源
@Composable
fun CounterScreen() {
    var count by remember { mutableIntStateOf(0) }
    Counter(count = count, onIncrement = { count++ })
}

价值:单一数据源、可复用、可预览、可测试,并且便于把状态放进 ViewModel 从而在配置变更后保留。

Q17:rememberrememberSaveable 的区别?

  • remember:只在重组之间保留,配置变更(旋转屏幕)或进程重建后会丢失。
  • rememberSaveable:把状态写入 Bundle能跨配置变更和进程重建恢复。要求对象可放入 Bundle,或用自定义 Saver

六、小结

Android 原理题的考察主线是“机制 + 取舍 + 踩坑”:Handler 考的是消息循环与线程模型,Binder 考的是跨进程通信在性能与安全上的权衡,组件考的是生命周期与后台限制,Compose 考的则是有没有真正从命令式思维转到声明式思维

准备策略:每条主线准备一个自己真踩过的坑——比如”延时消息导致 Activity 泄漏,最后用弱引用加 onDestroy 清理解决的”。这类具体经历比完整背诵源码更能拿到高分。


参考:Android 开发者指南Jetpack Compose 文档AOSP 架构文档。行为随 Android 版本演进,涉及后台限制与权限的部分请以目标 API 等级的官方文档为准。

标签

#Android 面试题#Handler#Binder#面试

JVM 与 GC 面试 25 问:内存结构、回收器选型与线上排查

JVM 与 GC 面试 25 问:内存结构、回收器选型与线上排查
关键词JVM 面试、GC 算法、G1、ZGC、Shenandoah、内存泄漏、JDK 25

JVM 是 Java 后端面试里最能区分”用过”和”懂”的一块。多数人能背出”堆分新生代和老年代”,但一追问”对象什么时候进入老年代””G1 为什么能设停顿目标””线上 Full GC 频繁你怎么排查”,就露怯了。

本文按内存结构 → 对象生命周期 → GC 算法 → 回收器选型 → 调优排查五段组织,并结合 JDK 25(2025 年 9 月发布的最新 LTS)的新变化,把 2026 年该答到的点补齐。

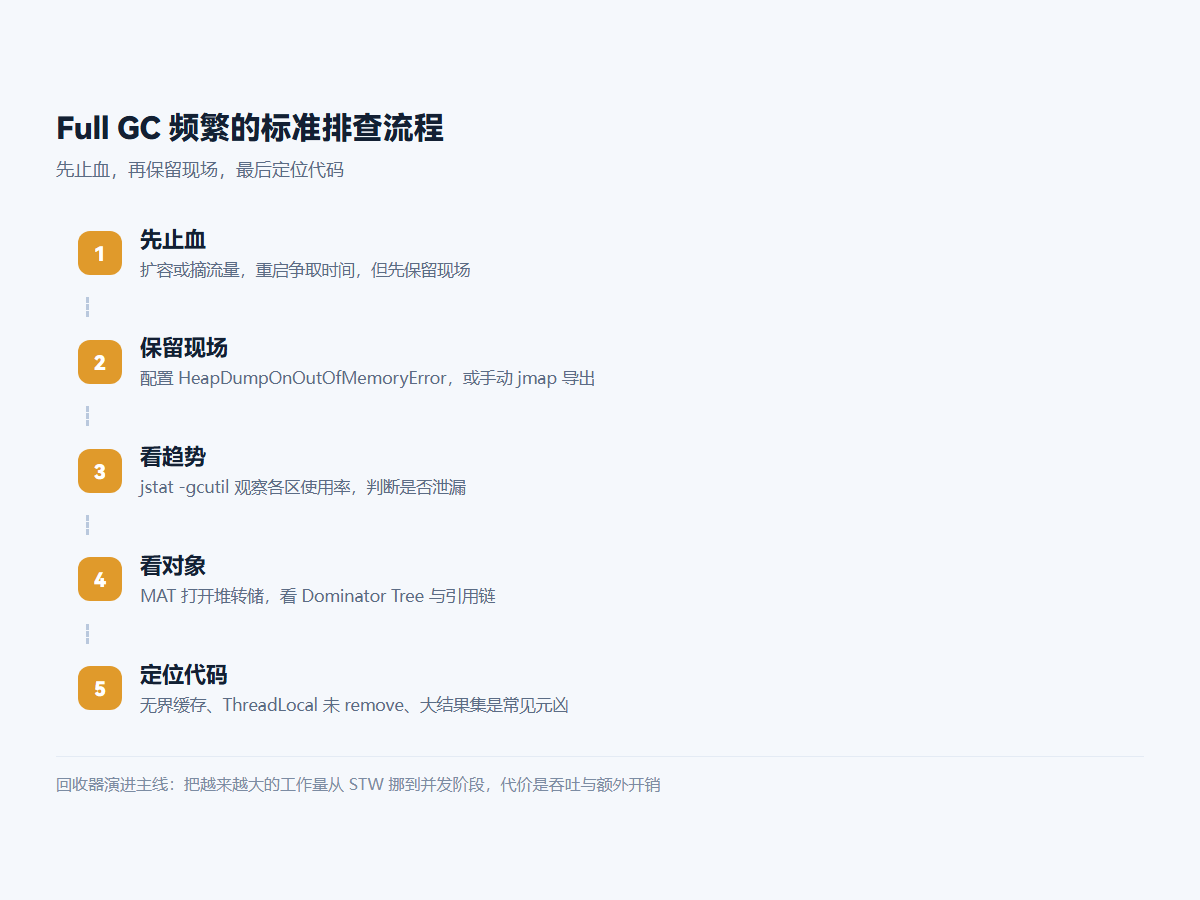
Full GC 频繁的标准排查流程
JVM 排查流程:止血 → 保留现场 → 看趋势 → 看对象 → 定位代码

一、运行时数据区:先分清哪些共享、哪些私有

Q1:JVM 内存分哪几块?

区域 线程共享 存什么 可能抛什么错
程序计数器 私有 当前指令地址 无(唯一不 OOM 的区域)
虚拟机栈 私有 栈帧(局部变量表、操作数栈) StackOverflowError / OOM
本地方法栈 私有 Native 方法 同上
共享 对象实例、数组 OutOfMemoryError: Java heap space
方法区 / 元空间 共享 类元信息、常量、静态变量、JIT 代码缓存 OOM: Metaspace

高频追问:元空间(Metaspace)和永久代(PermGen)有什么区别?

  • 永久代(JDK 7 及以前):在堆内,大小受 -XX:MaxPermSize 限制,容易 OOM。
  • 元空间(JDK 8 起):使用本地内存,理论上只受机器内存限制,默认值按需扩展。
  • 迁移带来的实际变化:字符串常量池和静态变量移到了堆里(JDK 7 就开始迁移),类元信息留在元空间。
  • 注意:元空间不受限不代表没风险,动态生成大量类(CGLib、反射、Groovy 脚本)仍会撑爆本地内存

Q2:对象在内存里长什么样?

对象头(Mark Word + 类型指针)+ 实例数据 + 对齐填充。Mark Word 里存着哈希码、GC 分代年龄、锁状态标志——这也是 synchronized 锁升级(偏向锁 → 轻量级锁 → 重量级锁)的状态载体。

2026 年加分点:JDK 25 的紧凑对象头(JEP 519)已转正,通过 -XX:+UseCompactObjectHeaders 可把 64 位平台上的对象头从 96–128 bit 压缩到 64 bit。对象密集型的负载通常能省下可观堆内存并改善数据局部性,相当于一次”免费升级”。落地前注意与所用 GC 组合的兼容性,需在目标环境实测验证。

二、对象生命周期:三个必考题

Q3:对象怎么判断”已死”?

不是引用计数法,是可达性分析。从 GC Roots 出发,能被引用链到达的对象是存活的,其余判定为可回收。

GC Roots 包括:虚拟机栈/本地方法栈中的引用、方法区中静态属性和常量的引用、被同步锁持有的对象、JVM 内部引用(如系统类加载器、异常对象)。

追问”引用计数法为什么不用“——因为它解决不了循环引用:A 引用 B、B 引用 A,两者计数都不为 0,但外部已经没人用了。

Q4:四种引用类型分别用在什么地方?

  • 强引用:默认。只要存在,GC 绝不回收。
  • 软引用(SoftReference)内存不足时才回收。适合做内存敏感的缓存。
  • 弱引用(WeakReference)下一次 GC 就回收ThreadLocalMapWeakHashMap 用它来避免内存泄漏。
  • 虚引用(PhantomReference):完全不影响生命周期,只用于在对象被回收时收到通知。典型用途是堆外内存的清理(DirectByteBuffer 的 Cleaner)。

高频连环问:”ThreadLocal 为什么会内存泄漏?“——ThreadLocalMap 的 key 是弱引用,value 是强引用。key 被 GC 回收后变成 null,但 value 仍被 Entry 强引用着,而 Entry 又在线程的 map 里。如果线程长期不结束(线程池场景尤其严重),value 就永远无法回收。解法:用完必须调用 remove()

Q5:对象什么时候进入老年代?

三条路径:

  1. 年龄阈值:每熬过一次 Minor GC 年龄 +1,默认 15(-XX:MaxTenuringThreshold)后晋升。
  2. 动态年龄判定:Survivor 区中同龄对象总大小超过 Survivor 一半时,大于等于该年龄的对象直接进入老年代。这条经常被漏答。
  3. 大对象直接进老年代:超过 -XX:PretenureSizeThreshold 的对象(典型是长数组、大字符串)直接在老年代分配,避免在 Eden 和 Survivor 之间反复拷贝。

还有一条空间分配担保:Minor GC 前 JVM 会检查老年代剩余空间是否大于新生代对象总大小(或历次晋升的平均大小),不够则先触发一次 Full GC。

三、GC 算法:三个算法各自的代价

Q6:三种基础算法及优劣?

算法 做法 优点 缺点 适用
标记-清除 标记后直接清除 简单,不移动对象 产生内存碎片 老年代 CMS 的并发清理阶段
复制 存活对象复制到另一半空间 无碎片,速度快 浪费一半空间 新生代(Eden:Survivor = 8:1:1)
标记-整理 标记后存活对象往一端移动 无碎片、不浪费空间 移动对象需要 STW 且更新引用 老年代

关键理解:复制算法在”大部分对象都会死”的前提下才划算。新生代对象朝生夕死(通常 98% 以上活不过一次 GC),所以只需要保留少量存活对象,10% 的 Survivor 空间就够了。老年代对象存活率高,用复制就得复制一大堆,所以改用标记-整理。

四、回收器选型:2026 年该答哪些

Q7:主流回收器怎么选?

  • Serial / Serial Old:单线程,STW 全程暂停。只适合客户端或极小堆(百 MB 级)。
  • Parallel / Parallel Old吞吐量优先,多线程并行回收但 STW。JDK 8 默认。适合批处理、离线计算这类不在乎单次停顿、只在乎总吞吐的场景。
  • CMS:并发标记清除,低停顿,但有碎片问题且已在 JDK 14 中被移除。了解即可,不要在新项目里提。
  • G1JDK 9 起的默认回收器。把堆划分成多个 Region,可预测的停顿时间模型-XX:MaxGCPauseMillis,默认 200ms),通过优先回收收益最高的 Region(Garbage First)来控制停顿。适合堆 4GB–数十 GB、要求均衡延迟与吞吐的服务。
  • ZGC超低延迟,停顿时间基本与堆大小无关,可稳定在毫秒级,支持 TB 级堆。核心技术是染色指针(Colored Pointers)+ 读屏障(Load Barrier),实现并发整理。JDK 21 起支持分代。
  • Shenandoah:与 ZGC 同属低延迟阵营,核心技术是 Brooks 转发指针 + 读屏障,实现并发整理。JDK 25 中分代模式转正(JEP 521),可用 -XX:ShenandoahGCMode=generational 开启,在短生命周期对象为主的负载上吞吐表现更好。

选型判断句:堆不大、追求吞吐 → Parallel;通用服务端、要平衡 → G1;延迟敏感且堆很大 → ZGC 或 Shenandoah。别一上来就说”用 ZGC”,它为了低延迟付出的是吞吐量下降和额外的内存开销(读屏障有成本)。

Q8:G1 为什么能设停顿目标?

因为它不再要求一次把整个代清理干净。G1 把堆分成约 2048 个大小相等的 Region,每个 Region 可以在新生代和老年代之间动态切换角色。回收时:

  1. 并发标记出各个 Region 的存活对象比例;
  2. 按”回收收益 / 停顿成本”排序;
  3. 在停顿目标的约束下,选择收益最高的一批 Region 作为回收集(CSet),采用复制算法把存活对象复制到空闲 Region;
  4. 一次只回收一部分,剩下的下次再来。

这就是”Garbage First”的含义:优先回收垃圾最多(收益最大)的区域,从而在有限的时间内拿到最大的空间收益。

Q9:ZGC 的染色指针是什么?

传统方案把对象状态(是否被移动、是否存活)存在对象头里,ZGC 把它编码进64 位指针的高位空闲比特里(所以叫”染色指针”,也叫 Colored Pointer)。好处是:

  • 并发整理时不需要访问对象就能知道它的状态,大大减少了屏障操作的开销;
  • 对象被移动后,只需修改指针的标记位;其他线程访问时会通过读屏障触发”自愈”——自动把指针修正到新地址,并重映射。

代价:需要 64 位平台、不支持压缩指针(Compressed Oops)、读屏障带来一定的运行时开销。

五、调优与排查:面试官真正想听的部分

Q10:线上频繁 Full GC,你怎么排查?

给一套可复述的标准流程:

  1. 先止血:如果是突发,先扩容或摘流量,重启大法能争取时间,但一定要先保留现场
  2. 保留现场:立即加 -XX:+HeapDumpOnOutOfMemoryError -XX:HeapDumpPath=/data/dump;或者手动 jmap -dump:format=b,file=heap.hprof <pid>
  3. 看趋势jstat -gcutil <pid> 1000 观察各区使用率与 GC 次数,判断是内存泄漏(老年代持续上涨且 GC 后不降)还是容量不足。
  4. 看对象:用 MAT / JProfiler 打开堆转储,看 Dominator Tree 里最大的对象是谁、被谁引用
  5. 定位代码:顺着引用链找到业务代码,常见元凶是无界集合缓存、ThreadLocal 未 remove、大结果集查询、流未关闭
# 常用诊断命令速查
jps -l                      # 找进程
jstat -gcutil <pid> 1000    # 实时 GC 统计
jmap -histo <pid> | head -30        # 活对象直方图(轻量)
jmap -dump:live,format=b,file=h.hprof <pid>   # 堆转储
jstack <pid> > stack.txt    # 线程栈(查死锁、CPU 飙高)
jcmd <pid> VM.flags         # 查看实际生效的 JVM 参数

Q11:常用调优参数有哪些?

# 基础
-Xms4g -Xmx4g               # 堆大小设为相同,避免动态扩缩容抖动
-Xmn2g                      # 新生代大小(G1 下不建议手动设)
-XX:MetaspaceSize=256m -XX:MaxMetaspaceSize=512m

# G1
-XX:+UseG1GC
-XX:MaxGCPauseMillis=200    # 停顿目标,别设太小,否则 GC 会更频繁
-XX:InitiatingHeapOccupancyPercent=45   # 并发标记触发阈值

# ZGC
-XX:+UseZGC
-XX:+UseNUMA                # NUMA 架构下开启

# 诊断(生产建议常开)
-XX:+HeapDumpOnOutOfMemoryError -XX:HeapDumpPath=/data/dump
-Xlog:gc*:file=/data/logs/gc.log:time,uptime:filecount=10,filesize=100m
# JDK 25 性能相关
-XX:+UseCompactObjectHeaders             # 紧凑对象头(需实测兼容性)

追问”-Xms 和 -Xmx 为什么要设成一样“——避免 JVM 在运行中动态扩缩容,扩容时需要向操作系统申请内存并可能触发 GC,造成抖动。容器化环境下这一点尤其重要。

Q12:容器环境里 JVM 有什么坑?

经典问题:JVM 在 JDK 8u191 之前不识别 cgroup 内存限制,会按宿主机的物理内存来算默认堆大小。结果容器限制 1GB,JVM 却按 64GB 宿主机算出默认堆,直接被 OOM Killer 杀掉。

# 现代写法(JDK 8u191+ / JDK 11+ 默认开启)
-XX:+UseContainerSupport
-XX:MaxRAMPercentage=75.0     # 按容器限制的百分比分配堆,比写死 -Xmx 更灵活

加分点:容器里不要写死 -Xmx,用 MaxRAMPercentage,这样调整 Pod 的 memory limit 时不用同步改 JVM 参数。

六、小结

JVM 这一块的答题主线是“分代假设 → 算法取舍 → 回收器定位”:绝大多数对象朝生夕死,所以新生代用复制算法;老年代存活率高,所以用标记-整理;回收器的演进主线是把越来越大的工作量从 STW 挪到并发阶段,代价是吞吐和额外开销。

2026 年回答时补上三点会显得跟得上:JDK 25 是当前 LTS紧凑对象头(JEP 519)与分代 Shenandoah(JEP 521)已转正虚拟线程的 synchronized 钉住问题已由 JEP 491 基本解决


参考:OpenJDK JEP 索引Oracle JDK 25 GC 调优指南ZGC Wiki。参数与特性状态以所用 JDK 版本的官方文档为准。
标签

#JVM#GC#后端面试题#面试

高并发系统设计面试 25 问:限流、削峰、熔断与一致性哈希

高并发系统设计面试 25 问:限流、削峰、熔断与一致性哈希
关键词高并发面试、限流算法、熔断降级、缓存雪崩、一致性哈希、系统设计

“设计一个秒杀系统””如何支撑百万 QPS”这类高并发题,是后端面试里最容易被答成一堆名词堆砌的一块。面试官听你念”限流、降级、缓存、MQ”的时候,其实在等你回答另一件事:你知道每一层挡住的是什么,以及挡不住的时候会发生什么。

本文按流量分层治理的思路组织:从客户端到数据库,逐层讲清每一层的手段、失效边界和常见追问。

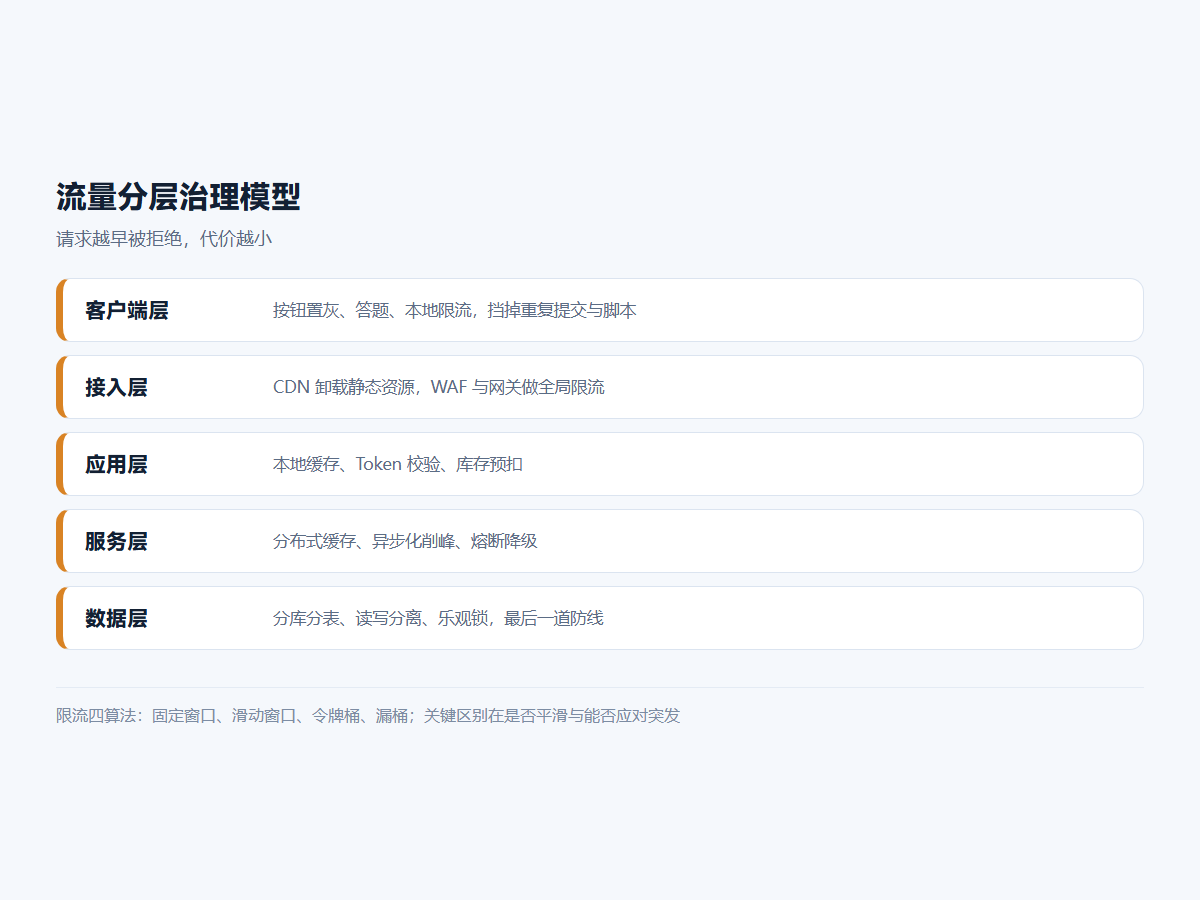
流量分层治理模型
高并发五层治理:客户端 → 接入层 → 应用层 → 服务层 → 数据层

一、先建立一个正确的分层模型

高并发不是”加机器”,而是把尽可能多的请求在尽可能靠外的层挡掉或消化掉。标准的分层是:

  1. 客户端层:按钮置灰、答题、本地限流——挡掉重复提交和脚本。
  2. 接入层(CDN / 网关):静态资源卸载、WAF、全局限流——挡掉大部分无效流量。
  3. 应用层:本地缓存、Token 校验、库存预扣——承接真正的业务请求。
  4. 服务层:分布式缓存、异步化、熔断降级——削峰填谷。
  5. 数据层:分库分表、读写分离、乐观锁——最后一道防线。

高分开场白:“我做高并设计的第一原则是:请求越早被拒绝,代价越小。”只要说出这句,后面所有的手段都有了主线。

二、限流:三种算法必须会画出来

Q1:计数器、滑动窗口、令牌桶、漏桶有什么区别?

算法 核心结构 是否平滑 能否应对突发 典型落地
固定窗口计数 一个计数器 + 时间窗 简单接口保护
滑动窗口 多个小格子的计数 较平滑 有限 Sentinel 默认
令牌桶 定速生成令牌 + 桶容量 平滑(限平均速率) (桶里有存货即可突发) Guava RateLimiter
漏桶 恒定速率出水 完全平滑 不能 流量整形

必考追问:固定窗口的临界问题。限流 100 QPS,如果在 0.9s 时来了 100 个请求、1.1s 时又来了 100 个,两个窗口各自都没超限,但这 0.2 秒内实际过了 200 个。滑动窗口就是为了解决它而出现的。

Q2:单机限流和分布式限流怎么选?

// 单机:令牌桶,性能好、无网络开销
RateLimiter limiter = RateLimiter.create(1000.0);   // Guava
if (!limiter.tryAcquire()) return tooManyRequests();

// 分布式:Redis + Lua(保证原子性)
// KEYS[1]=key, ARGV[1]=限流阈值, ARGV[2]=窗口秒数
local cur = redis.call('INCR', KEYS[1])
if cur == 1 then redis.call('EXPIRE', KEYS[1], ARGV[2]) end
return cur > tonumber(ARGV[1]) and 0 or 1

取舍要点:

  • 单机限流:无网络开销、性能好,但机器数量变化时需要重新计算阈值;适合保护本机资源(CPU、连接池)。
  • 分布式限流:精确控制全局总量,但每次请求都要打一次 Redis,本身成为热点;适合保护下游稀缺资源(数据库、第三方接口)。
  • 实践上两者叠加:网关做粗粒度分布式限流,应用内再做一层单机限流兜底。

三、削峰:把尖峰拉成平谷

Q3:秒杀场景为什么要异步化?

同步链路的问题:100 万请求直接打到数据库,数据库连接池瞬间被打满,正常业务也跟着挂。异步化的本质是用 MQ 做缓冲区,把”瞬时 100 万”变成”匀速消费 1 万/秒”。

// 标准秒杀链路
// 1. Redis 预扣库存(原子操作,挡掉 99% 的请求)
Long remain = redis.eval(DECR_STOCK_LUA, keys, args);
if (remain < 0) return "已售罄";

// 2. 写入 MQ,立即返回"排队中"
mq.send(new OrderCreatedEvent(userId, skuId));

// 3. 消费者匀速落库,前端轮询或推送结果
//    → 数据库实际承受的是消费速率,不是请求速率

追问:MQ 积压了怎么办?三个层次——① 临时扩容消费者;② 如果积压在业务低峰期可以慢慢消化,就不用管;③ 真正危险的是消息堆积导致磁盘写满或 TTL 过期丢失,所以要设积压告警 + 死信队列兜底。

Q4:缓存三大问题的标准解法

问题 成因 解法
缓存穿透 查询根本不存在的数据 空值缓存(短 TTL)+ 布隆过滤器
缓存击穿 单个热点 key 过期瞬间大量请求打到 DB 互斥锁重建 / 逻辑过期(永不过期 + 后台刷新)
缓存雪崩 大批 key 同时过期 TTL 加随机抖动 + 多级缓存 + 熔断
// 逻辑过期方案:value 里带一个逻辑过期时间,物理上永不过期
class CacheItem {
    Object data;
    long   expireAt;   // 逻辑过期时间
}

// 命中后发现逻辑过期:不阻塞,先返回旧值,另起线程重建
if (item.expireAt < now) {
    executor.submit(() -> rebuildWithLock(key));   // 只放一个线程去重建
    return item.data;    // 其他线程继续用旧数据,不等待
}

区分要点:击穿是”一个 key”,雪崩是”一批 key”。面试官经常故意混着问,你主动点出来会加分。

四、熔断与降级:什么时候该认输

Q5:熔断器的三种状态怎么转换?

  1. Closed(关闭):正常放行,统计失败率。
  2. Open(打开):失败率超阈值后,直接快速失败,不再调用下游。这是为了让下游有喘息时间恢复。
  3. Half-Open(半开):熔断一段时间后,放少量探测请求;成功则回到 Closed,失败则回到 Open。

关键认知:熔断保护的是下游,降级保护的是自己。熔断是”调用方发现下游不行了,先别打了”;降级是”我自己扛不住了,把非核心功能关掉保住核心链路”。

降级常见手段:返回兜底数据(默认值、缓存旧值)、关闭非核心功能(推荐、评论、排行榜)、异步化非必要步骤。

Q6:熔断和限流的区别?

一句话:限流是”我做不了这么多”,熔断是”下游不行了,我别给它添乱”。限流发生在入口,熔断发生在出口;限流是主动的容量管理,熔断是被动的故障响应。

五、一致性相关的高频追问

Q7:一致性哈希是什么?解决了什么问题?

普通哈希取模(hash(key) % N)的问题:节点数 N 变化时,几乎所有 key 的映射都会改变。集群从 3 台扩到 4 台,缓存命中率会直接崩掉,导致大量请求穿透到数据库。

一致性哈希把节点和 key 都映射到一个 0 ~ 2^32 的哈希环上,key 顺时针找第一个节点。增删节点时只影响环上相邻的一小段 key,大部分映射保持不变。

追问:节点太少导致数据倾斜怎么办?引入虚拟节点——一个物理节点对应环上几百个虚拟节点,让分布更均匀。这是标准答案,必须能说出来。

// 虚拟节点示意
for (int i = 0; i < VIRTUAL_NODES; i++) {
    String vnode = physicalNode + "#" + i;
    ring.put(hash(vnode), physicalNode);   // TreeMap 有序环
}
// 查找:tailMap(hash(key)) 取第一个,没有则回到环首

Q8:库存扣减怎么防超卖?

三种方案,按强度和代价递进:

  1. 数据库乐观锁UPDATE stock SET num = num - 1 WHERE sku_id = ? AND num > 0,靠影响行数判断是否成功。简单可靠,但高并发下大量失败重试,数据库压力大。
  2. Redis 原子预扣:Lua 脚本保证”判断 + 扣减”原子性,挡掉绝大部分请求,只有真正下单的才落库。秒杀场景的标准做法。
  3. 分段库存:把 1000 件库存拆成 10 个段各 100 件,请求随机落到某一段,把热点打散。能显著提升并发上限,代价是可能出现”某段卖完了但总量还有”的情况,需要额外的归并逻辑。

必考陷阱:”先查再改为什么不行?“——因为 SELECT numUPDATE 是两条语句,并发下两个事务可能同时读到 num=1,然后都判断通过后扣减,结果变成 -1。核心是判断与修改必须在同一个原子操作里完成

Q9:接口幂等怎么保证?

  • 唯一索引:最简单可靠。业务上用一个唯一键(订单号 + 操作类型),重复插入直接报错捕获。
  • Token 机制:进入页面前先申请一个 token,提交时带上,服务端校验后删除。用 Redis 的 DEL 返回值判断是否首次(原子性)。
  • 状态机:更新时带上前置状态,WHERE status = 'CREATED',只有状态匹配才更新。
  • 分布式锁:兜底手段,代价最高,慎用。
// Token 幂等:DEL 是原子的,返回 1 表示首次提交
Long deleted = redis.del("idempotent:" + token);
if (deleted == null || deleted == 0) {
    return "重复提交";     // 已被消费过
}
// 继续处理业务...

六、怎么把设计题答出层次

给一个可以直接套用的答题结构:

  1. 先问清量级:峰值 QPS 多少?读多写少还是相反?一致性要求多高?开口就上 Redis 集群是减分项。
  2. 给出分层架构:从 CDN 到数据库,画出请求流经的每一层,标注每层挡掉多少。
  3. 抓住核心矛盾:秒杀的核心是”库存扣减的原子性 + 流量削峰”;Feed 流的核心是”读写放大与扇出”;排行榜的核心是”实时性与写压力”。不同场景矛盾不同,别一套方案打天下。
  4. 主动说代价:每个方案都有副作用——异步化带来一致性延迟,缓存带来数据陈旧,限流带来部分用户失败。能说出”我接受什么代价”是资深和初级的分水岭。
  5. 补上可观测:监控哪些指标(QPS、RT、错误率、缓存命中率、MQ 积压)、告警阈值怎么定。

七、小结

高并发设计题考察的不是方案背诵,而是分层治理的思维方式 + 对每个手段失效边界的认知。把五层模型记住,把限流四算法、缓存三问题、熔断三状态、幂等四方案讲清楚,再配上”请求越早被拒绝代价越小”这条主线,这一块就能答得有结构、有取舍。


参考:Redis Lua 脚本文档Sentinel 官方文档Resilience4j 文档。实现细节请以所用组件的最新官方文档为准。

标签

#后端面试题#高并发#系统设计#面试