loader

Nerio News Magazine brings you trusted, timely and thought-provoking stories from around the globe.

Follow Us

一致性哈希与数据分布:哈希环、虚拟节点与哈希槽

一致性哈希与数据分布:哈希环、虚拟节点与哈希槽
关键词一致性哈希、哈希环、虚拟节点、Redis Cluster、哈希槽、数据分片

「数据量涨十倍,扩容要迁移多少数据?」——这个问题的答案,就是一致性哈希存在的理由。它是分布式存储(Dynamo、Cassandra、Redis Cluster 的设计前身)的基石算法,也是面试中检验分布式思维深度的经典题。这篇从朴素哈希的问题出发,讲清环、虚拟节点、热点治理三层设计,以及它与 CAP 的关系。

一、朴素哈希的死穴:节点数变了,一切重来

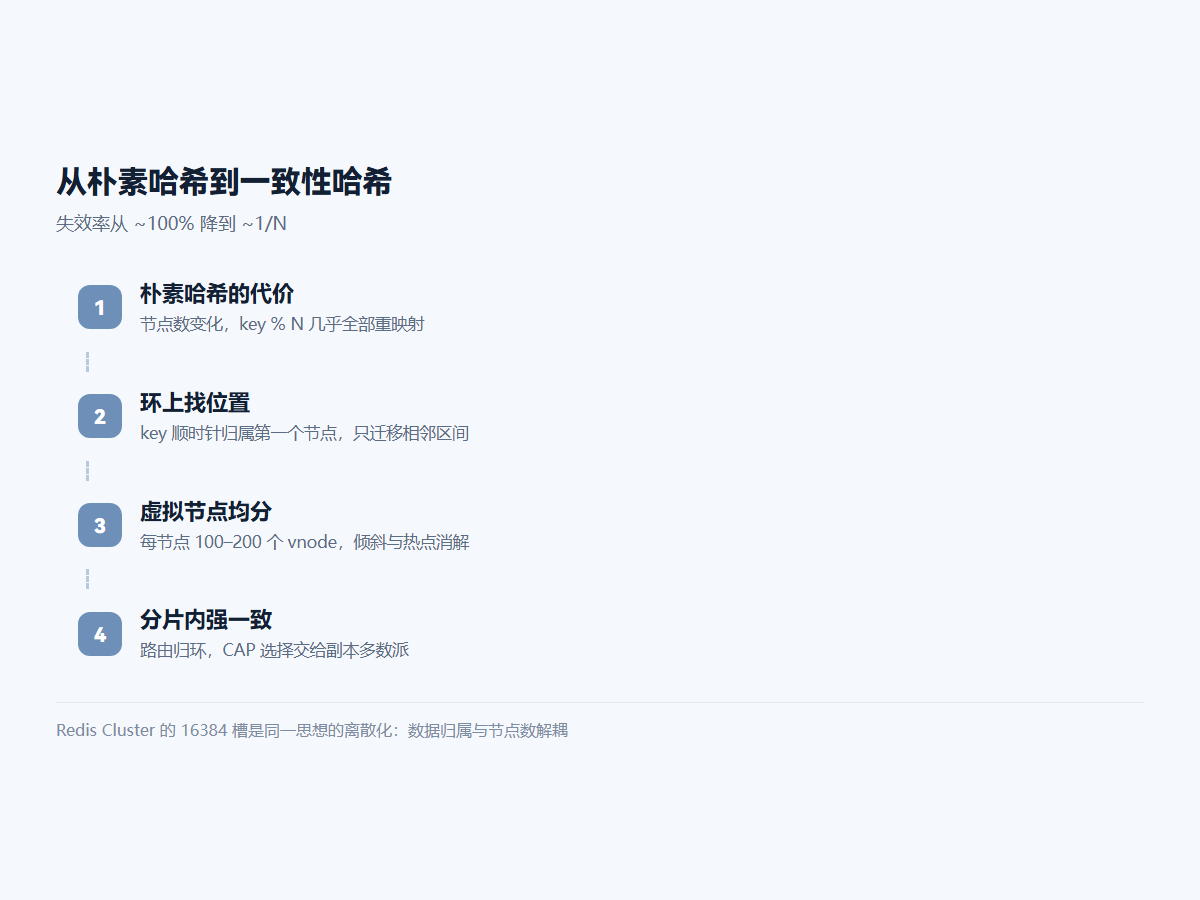
缓存集群用 hash(key) % N 分片,N=4 时一切正常。扩到 N=5,几乎所有 key 的映射全部改变——缓存瞬间整体失效,DB 被打穿。数学上:节点数从 N 变到 N+1,key % Nkey % (N+1) 大概率不同,失效率 ≈ N/(N+1),接近全量。

二、一致性哈希:把「对节点取模」改成「在环上找位置」

把哈希空间组织成一个环(如 0 → 2^32-1),节点与 key 都映射到环上,key 顺时针找到的第一个节点即归属节点。这样节点增减时,只有相邻区间的 key 需要迁移,失效率从 ~100% 降到 ~1/N(K 个 key 中只迁移 K/N 个)。
从朴素哈希到一致性哈希

三、虚拟节点:解决「环不均匀」与「热点」

物理节点少时,环上的区间划分天然不均,数据倾斜严重。标准解法是每个物理节点映射成 100–200 个虚拟节点散布在环上:区间划分趋近均匀,且新增节点从多个旧节点「各拿一点」,迁移压力分散。虚拟节点同时是异构容量的调节旋钮——性能强的机器多放虚拟节点,自然多承载数据。

# 伪代码:带虚拟节点的一致性哈希
ring = {}                                # hash(vnode) -> node
for node in nodes:
    for i in range(150):                 # 每节点 150 个虚拟节点
        ring[hash(f"{node}#v{i}")] = node

def locate(key):
    h = hash(key)
    return min(k for k in ring if k >= h, default=min(ring))  # 顺时针第一个

值得对照的是 Redis Cluster 的选择:它放弃哈希环,改用 16384 个固定哈希槽,槽是数据归属的最小单位,节点间按槽迁移——本质是把「环」离散化,迁移控制更精细。两种方案思路同源:让数据归属与节点数解耦

四、一致性哈希与 CAP:分区时的归属权问题

一致性哈希解决「数据放哪」,CAP 讨论的是「分区发生时保什么」。两者在工程上交汇于同一个问题:网络分区时,环上某段的两端节点各自认为自己拥有该区间怎么办?业界答案通常是一致性哈希负责路由 + 强一致协议(Raft 类)负责副本仲裁——即哈希环定分片,每个分片内部用多数派决斈权威,把 CAP 的选择题交给副本层而不是路由层。

一句话总结:一致性哈希的全部价值 = 归属与节点数解耦(环)+ 均匀与弹性(虚拟节点)。面试答到这两层,再能对比哈希槽方案,就是一份完整的回答。

标签

#一致性哈希#分布式系统#数据分片#CAP
TCP 拥塞控制演进:从 Reno、CUBIC 到 BBR v3

TCP 拥塞控制演进:从 Reno、CUBIC 到 BBR v3
关键词TCP 拥塞控制、CUBIC、BBR、慢启动、AIMD、bufferbloat

TCP 拥塞控制是面试与实际调优的交叉地带:面试官用它考察网络理解的深度,工程师则会在传输密集型服务(上传下载、直播推流、跨机房同步)里真实遇到它。2026 年的生产环境,CUBIC 仍是 Linux 默认,但 BBR(已迭代到 v3,纳入 相关 RFC 体系的讨论)在高丢包、长肥管道场景的优势已经被广泛验证。这篇把演进脉络与工程选型一次讲清。

一、问题本质:网络是个没有中央调度的共享系统

路由器缓存有限,所有发送方加起来的速率超过链路容量就会拥塞——队列堆积、延迟暴涨、最终丢包。拥塞控制的本质是分布式限流协议:每个发送方根据隐式信号(丢包/延迟)猜测网络状态,自觉调整发送速率。整个算法围绕一个窗口 cwnd 展开,实际发送量 ≈ min(拥塞窗口, 接收窗口)。

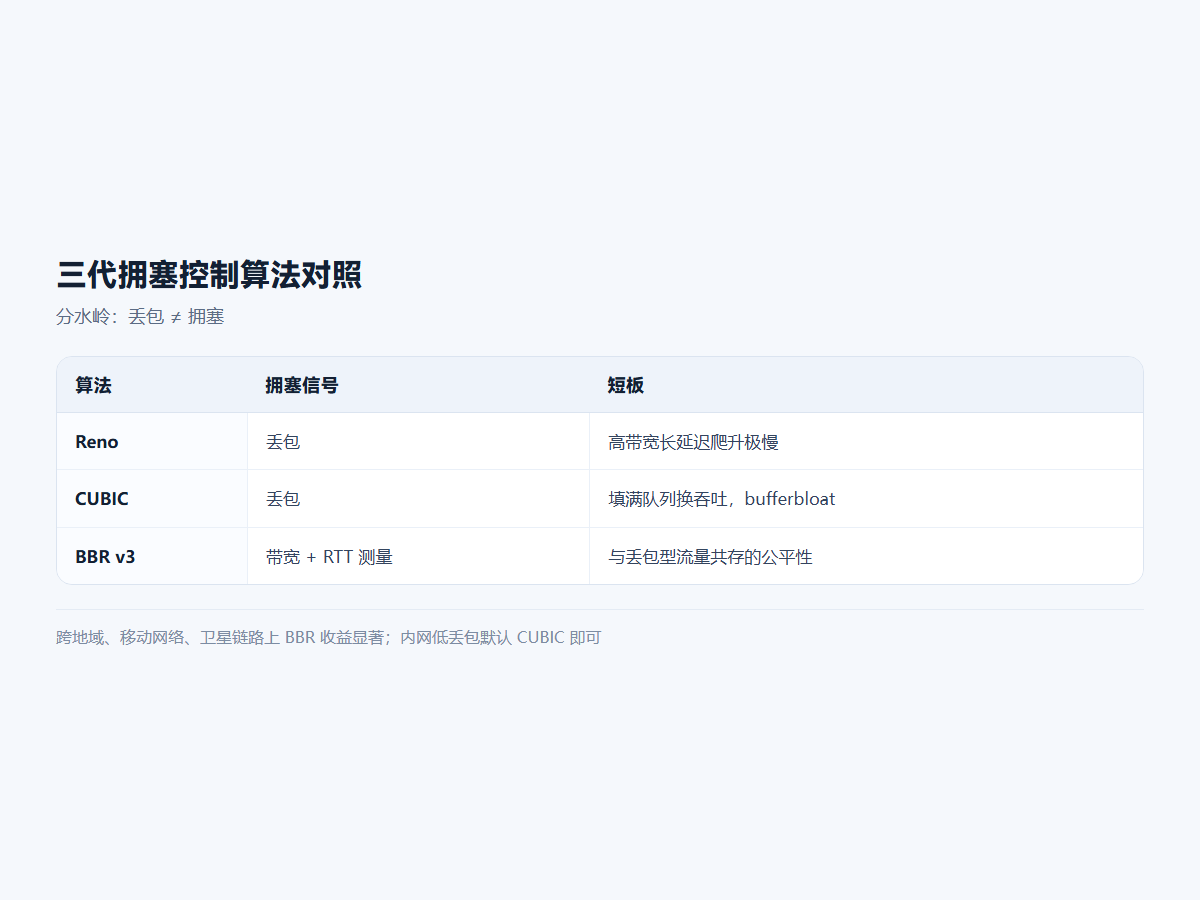
二、三代算法的演进逻辑

算法 拥塞信号 核心策略 短板
Reno(1988) 丢包 慢启动指数增长 → 丢包后减半(AIMD),线性爬坡 高带宽长延迟网络爬升极慢,深队列缓冲导致 bufferbloat
CUBIC(Linux 默认) 丢包 窗口增长曲线按三次函数:接近上次瓶颈时减速,远离时加速 仍依赖「填满队列才丢包」的信号,延迟换吞吐
BBR(v1→v3) 带宽与 RTT 测量 主动估计瓶颈带宽 btlbw 与最小 RTT rtprop,工作在 BDP 附近而不填满队列 与基于丢包的流量共存时公平性问题(v2/v3 重点修复)

理解 CUBIC 与 BBR 的分水岭:丢包 ≠ 拥塞。Wi-Fi、5G、跨洋链路存在大量非拥塞性丢包,把丢包当拥塞信号会导致这些场景下的带宽利用率极低——这正是 BBR 的出发点。

三代拥塞控制算法对照

三、工程视角:Linux 下怎么调

# 查看可用与当前算法
sysctl net.ipv4.tcp_available_congestion_control
sysctl net.ipv4.tcp_congestion_control

# 启用 BBR(内核 4.9+,v3 需要较新内核)
modprobe tcp_bbr
sysctl -w net.ipv4.tcp_congestion_control=bbr
sysctl -w net.core.default_qdisc=fq   # BBR 推荐 fq 队列规则

选型经验:内网或丢包极低的环境,CUBIC 与 BBR 差距不大,默认即可;跨地域传输、移动网络、卫星/跨境链路,BBR 收益显著(吞吐提升数倍是常见结果)。反向代理与下载服务值得逐台评估切换,注意服务端与对端各自的算法独立生效。

四、与面试高频问题的对齐

  • 慢启动为什么存在:没有先验信息时用指数增长快速探测可用带宽,直到丢包或达到阈值(ssthresh)转入拥塞避免;
  • AIMD 为什么公平:加性增(每 RTT +1)使各流线性爬升,乘性减(减半)让占用多的流让出更多,长期收敛到公平分享;
  • BBR 为什么不怕随机丢包:它不把丢包当拥塞信号,只依据 btlbw 与 rtprop 两个测量值控制速率;
  • bufferbloat 是什么:过大的路由器缓冲让「填满缓冲才丢包」的算法把延迟推到数百毫秒——CUBIC 时代网页卡顿的经典根源之一。

一句话总结:从 Reno 到 CUBIC 是「更聪明地利用丢包信号」,从 CUBIC 到 BBR 是「换掉信号本身」。理解这条主线,算法细节都可以现场推导。

标签

#TCP#网络协议#BBR#性能调优

全链路压测与容量保障:影子库、流量染色与预案演练

全链路压测与容量保障:影子库、流量染色与预案演练
关键词全链路压测、影子库、流量染色、容量保障、故障演练、大促备战

大促、开学季、爆款活动——容量问题总在流量峰值时爆发,而容量保障的所有工作都必须在流量到来之前完成。全链路压测是容量保障体系的核心手段,但它不是「压一下看看」,而是一套包含目标设定、数据隔离、流量染色、预案演练的完整工程。这篇按执行顺序拆解。

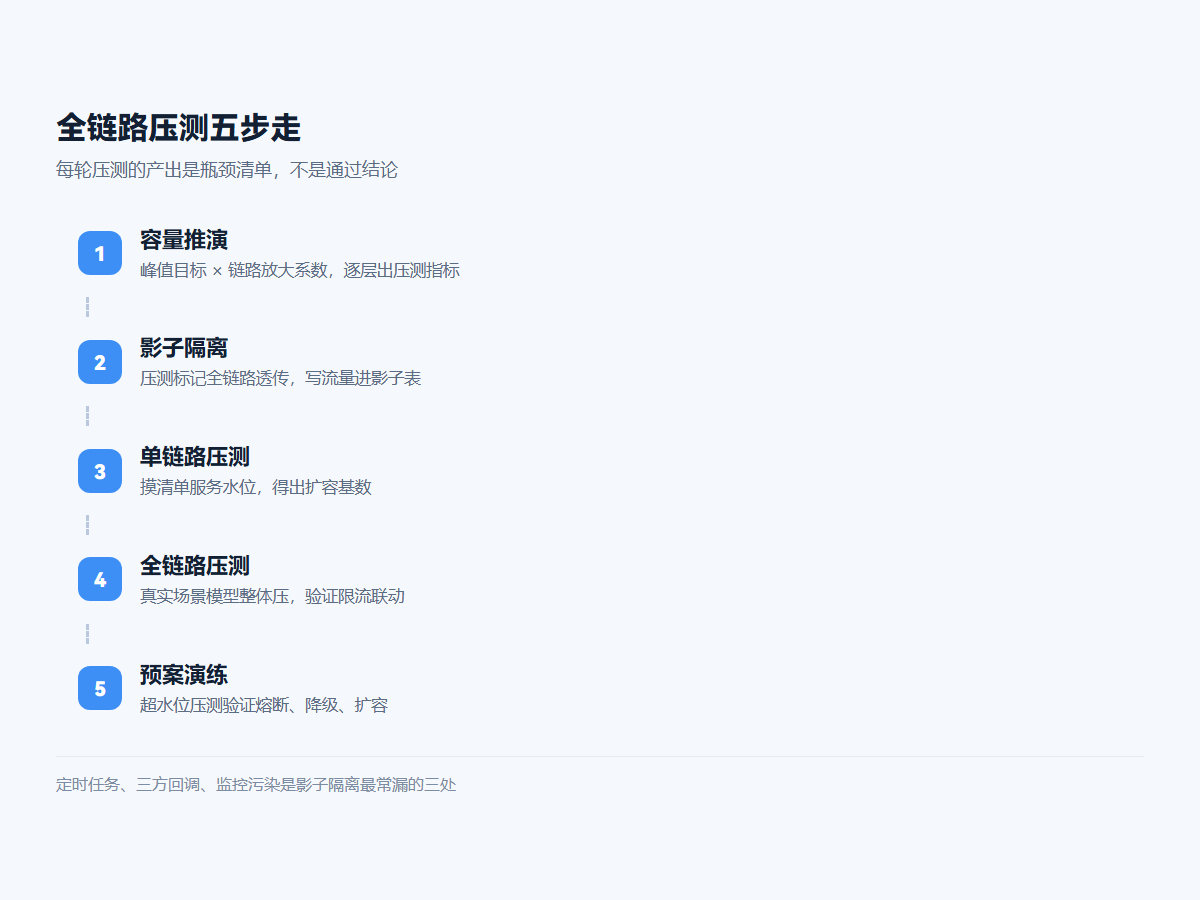
一、第一步:把「能扛多少」变成可计算的模型

压测前先做容量推演,否则压测就是盲目的。三个输入:

  • 业务目标:峰值 QPS 预估(去年峰值 × 增长系数,或活动玩法折算);
  • 链路模型:从入口到存储,每一跳的调用比例(下单 1 次 → 库存服务 2 次 → 缓存 5 次 → DB 0.8 次),逐层放大出每一层的压测目标;
  • 瓶颈假设:根据历史监控标注最可能先顶不住的组件(通常是 DB 连接、缓存热 key、下游三方接口限流)。
全链路压测五步走

二、数据与流量隔离:影子库是安全底线

压测流量绝不能污染生产数据。行业标准做法是影子表/影子库:压测请求打上标记(Header 或 RPC context),中间件层识别标记后把写操作路由到影子表,读操作正常走生产(读不会污染)。关键实现点:

// 全链路透传压测标记:入口打标 → RPC/MQ/DB 各层识别
if (ctx.getHeader("X-Load-Test") === "1") {
  ctx.loadTest = true;
  // DB 层:INSERT INTO shadow_order ... 而不是 order
  // MQ 层:发往 shadow_topic,消费者同样打标
}

容易遗漏的三处:定时任务(压测产生的数据触发真实扣款/通知)、三方回调(支付回调打到压测订单)、监控污染(压测流量进大盘导致告警误报——大盘要分桶)。

三、执行:从单链路到全链路的三级推进

  1. 单服务压测:摸清每个服务的单机容量水位,得出「扩容到多少实例」的基数;
  2. 链路压测:核心链路(下单、支付)单独压,验证服务间配比与缓存命中率;
  3. 全链路压测:真实场景模型整体压,验证限流、降级、扩容联动是否按预期工作。

每轮压测的产出不是「通过了/没通过」,而是瓶颈清单:哪一跳在多少 QPS 时出现什么征兆(RT 翻倍、错误率抬头、连接池打满)。压测的价值 = 修掉瓶颈的速度。

四、预案演练:压测的最终目的是验证「坏的时候会怎样」

容量保障的完整闭环必须包含故障演练:把压测推到超过目标水位,验证限流是否按预期挡住多余流量、降级开关是否生效、扩容是否自动触发。三个必演练场景:缓存整体失效(DB 瞬时承压)、三方接口挂掉(降级到本地兜底)、某一服务节点批量宕机(负载均衡与重试风暴)。

一句话总结:全链路压测的本质是用可控的成本,在演练环境里把生产事故提前发生一遍。目标模型 → 影子隔离 → 三级推进 → 预案演练,四步走完,大促才有底气说「我们准备好了」。

标签

#全链路压测#容量规划#稳定性保障#故障演练

微前端 2026 落地指南:Module Federation 与沙箱方案的选型

微前端 2026 落地指南:Module Federation 与沙箱方案的选型
关键词微前端、Module Federation、qiankun、wujie、沙箱隔离、前端架构

微前端在 2026 年已经过了「要不要用」的阶段,进入「怎么用对」的阶段:模块联邦成为构建期共享的主流方案,运行时沙箱方案(qiankun、wujie、micro-app)在多团队异构场景继续服役。选型错误的代价很高——微前端引入的隔离与通信复杂度,会让一个本不需要它的项目显著变慢。这篇讲清楚什么场景值得用、四种方案怎么选、以及落地时的四个关键决策。

一、先判断:你的问题是不是微前端能解决的

微前端解决的是组织问题,不是技术问题。三个信号说明值得用:

  • 多个团队独立开发、独立发版同一个产品(如中台 + 各业务线);
  • 技术栈异构且短期内无法统一(老 Angular 系统与新 React 系统共存);
  • 需要增量迁移:老系统逐模块替换,新旧长期并存。

反过来,如果只是「想让项目拆小一点」,拆模块、拆包、monorepo 就够了——引入微前端只会增加复杂度。

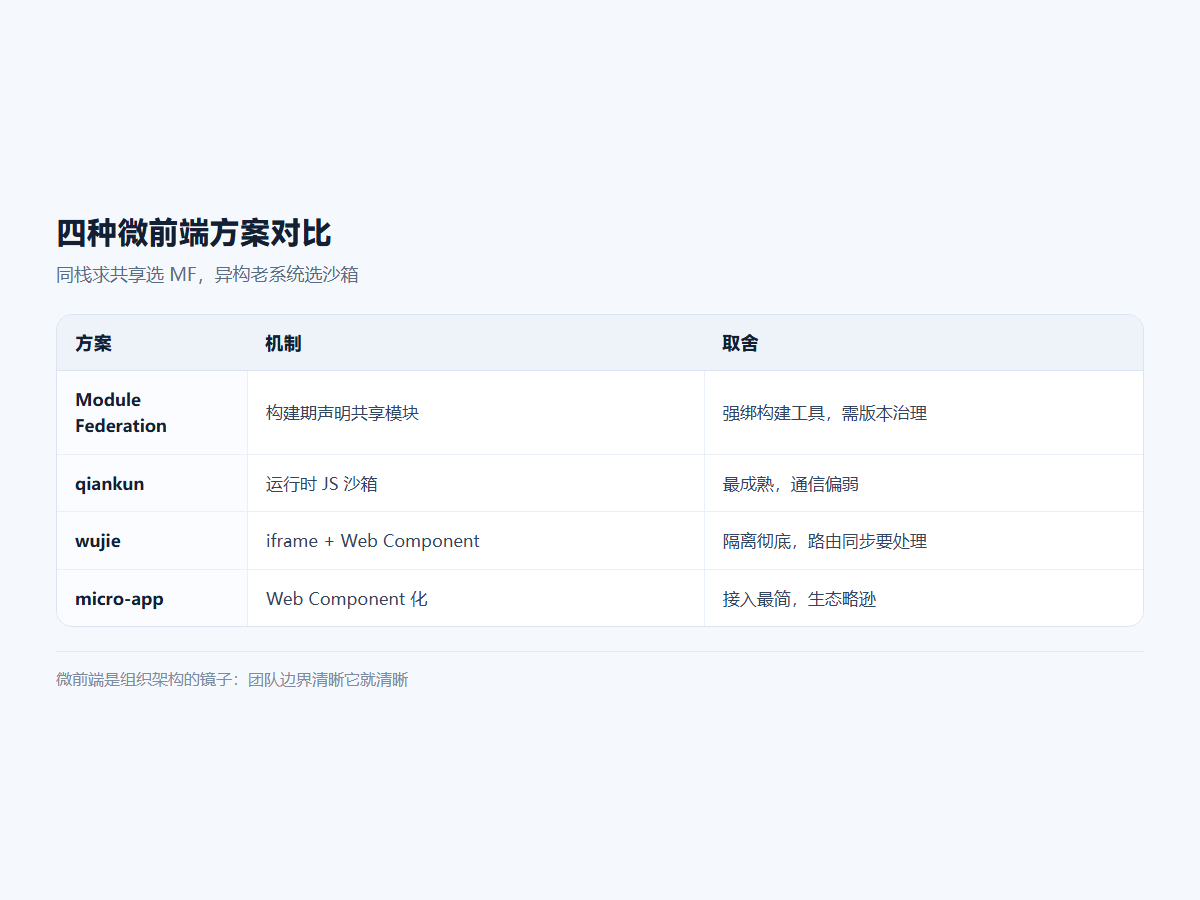
四种微前端方案对比

二、四种主流方案对比

方案 机制 优势 代价
Module Federation 构建期声明共享模块,运行时按需加载远程包 依赖共享精细、无 iframe 割裂感,Webpack/Rspack(2.x)原生支持 强绑定构建工具,版本协商需要治理
qiankun 运行时加载子应用 + JS 沙箱 + 样式隔离 最成熟,接入改造小,社区资料多 沙箱有边界情况,应用间通信偏弱
wujie iframe + Web Component 的混合方案 JS 天然隔离、保活、预加载体验好 iframe 路由同步与弹窗场景需处理
micro-app Web Component 化的类使用方式 接入方式最接近普通组件,学习成本低 功能完整度与生态略逊于 qiankun

选型粗略原则:同一技术栈、追求依赖共享 → Module Federation;异构老系统共存 → 运行时沙箱方案(三者中按团队熟悉度选)。Module Federation 的机制细节见Webpack 官方文档

三、落地四个关键决策

  1. 样式隔离策略:Shadow DOM 最彻底但会困住全局弹层;约定前缀 + CSS Modules 折中。原则是能靠规范解决的不要上重隔离;
  2. 公共依赖治理:共享 React/Vue 版本必须由基座统一提供并锁定,子应用擅自升级会直接炸运行时——把共享依赖清单写进 CI 检查;
  3. 通信设计:跨应用通信只传「事件 + 数据」,不做引用共享。状态提升到 URL、全局事件总线或独立状态服务,保持子应用可独立运行;
  4. 加载性能:子应用预加载 + 缓存(wujie 的保活与预加载是亮点),否则多应用串行加载会让首屏不可接受。

「公共依赖治理」在 Module Federation 下的具体形态——基座单点提供共享依赖,子应用只声明不打包:

// 基座(宿主):单点提供共享依赖,版本收口
new ModuleFederationPlugin({
  name: "shell",
  remotes: { orders: "orders@/remote/orders/entry.js" },
  shared: {
    react:   { singleton: true, requiredVersion: deps.react },
    "react-dom": { singleton: true, requiredVersion: deps["react-dom"] },
  },
});

// 子应用:只声明共享,不把 React 打进自己的产物
new ModuleFederationPlugin({
  name: "orders",
  exposes: { "./Page": "./src/pages/Orders" },
  shared: { react: { singleton: true }, "react-dom": { singleton: true } },
});

四、最常见的失败模式

微前端项目失败很少败在技术,多数败在边界没切干净:子应用之间互相 import 对方的工具函数、基座深度感知子应用内部状态、路由规则越写越复杂。保持三个纪律:子应用能独立启动独立发版;基座只管「壳」不管业务;跨边界交互全部走显式契约(事件/接口),纳入代码评审检查项。

一句话总结:微前端是组织架构的镜子——团队边界清晰它就清晰,团队边界混乱它就混乱。先用组织问题判断要不要用,再按技术栈与隔离需求选方案。

标签

#微前端#前端架构#Module Federation#工程化

鸿蒙应用安全与合规上架:签名、权限、加密与隐私声明

鸿蒙应用安全与合规上架:签名、权限、加密与隐私声明
关键词鸿蒙安全、应用签名、权限最小化、HUKS、隐私合规、应用市场审核

应用能上架鸿蒙市场,技术只是一半,另一半是安全与合规。华为应用市场对权限使用、隐私声明、数据收集行为的审核越来越细,加上《个人信息保护法》的合规要求,安全设计必须在开发期就进入流程,而不是上架前临时补救。这篇梳理鸿蒙应用从签名到数据保护的完整清单。

一、应用签名:发布体系的第一道门

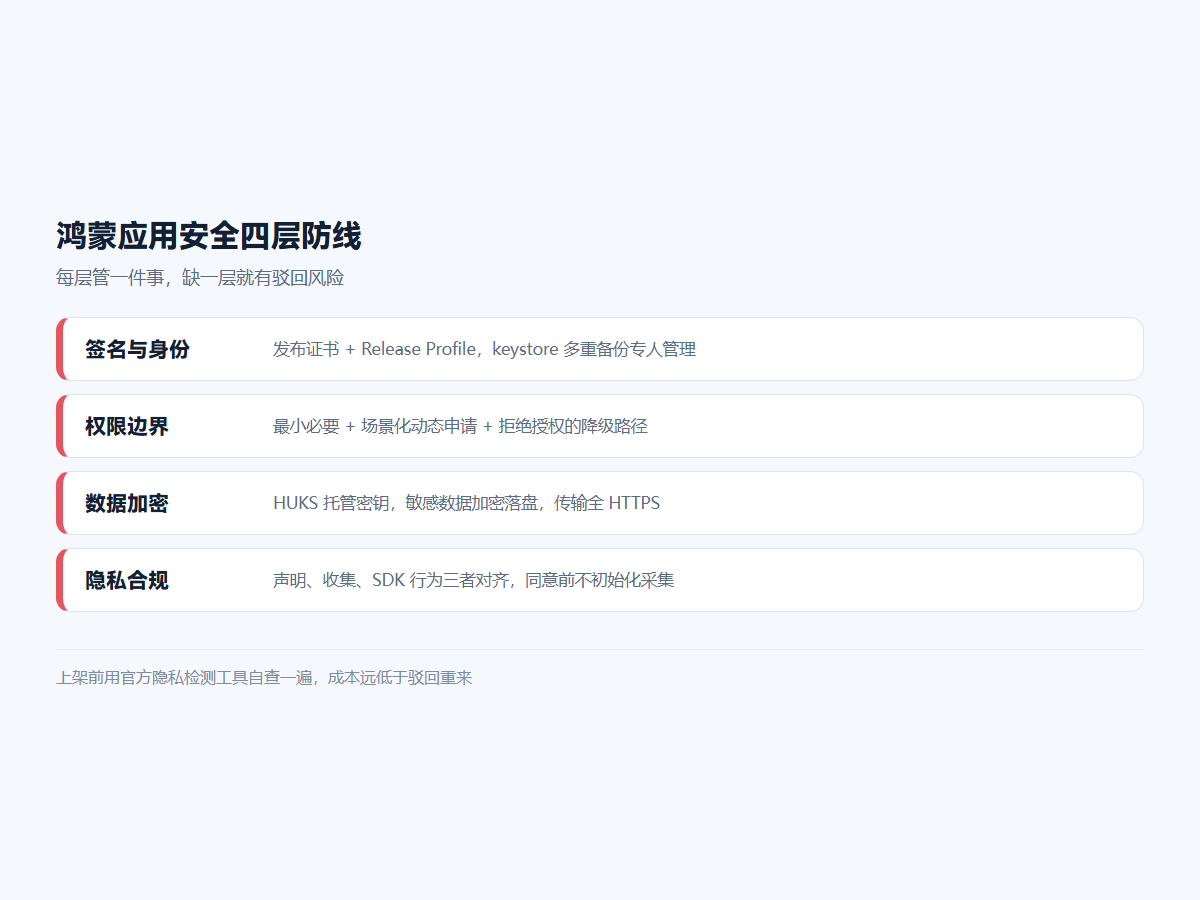
鸿蒙应用采用证书 + Profile 的签名体系:调试证书用于开发期真机调试,发布证书绑定应用身份,Release Profile 控制发布类型(上架/企业内部分发)。常见的翻车点:

  • 调试包直接提交审核(Profile 类型不匹配,直接驳回);
  • 证书与密钥丢失导致无法发新版本——发布证书与 keystore 务必多重备份并专人管理
  • 多团队协作时共用调试证书,权限边界混乱。

二、权限:最小化 + 场景化申请

权限模型的审核原则是「最小必要」:申请的每一个权限都必须能对应到具体业务功能,审核时会实际验证「不给权限功能是否可用」。工程上的正确姿势:

  • 按需动态申请:相机、位置等敏感权限在用户触发功能时申请,而不是启动时一次性索要;
  • 提供降级路径:拒绝授权后功能可用(如手动选择代替相册读取),这既是体验要求也是审核关注点;
  • 权限声明与实际调用一致:声明了不用的权限是驳回理由之一。
鸿蒙应用安全四层防线

三、数据安全:HUKS 与加密存储

敏感数据(token、用户资料)禁止明文落盘。鸿蒙提供了系统级密钥管理服务 HUKS(通用密钥库),密钥由安全环境托管,应用侧只持句柄:

import { cryptoFramework } from "@kit.CryptoArchitectureKit";
import { huks } from "@kit.UniversalKeystoreKit";

// 密钥生成与使用都走 HUKS,私钥不可导出
let props: huks.HuksParam[] = [{
  tag: huks.HuksTag.HUKS_TAG_ALGORITHM,
  value: huks.HuksKeyAlg.HUKS_ALG_AES
}, {
  tag: huks.HuksTag.HUKS_TAG_KEY_SIZE,
  value: huks.HuksKeySize.HUKS_AES_KEY_SIZE_256
}];
// generateKeyItem / initSession / finishSession 完成加解密闭环

配套动作:传输层全量 HTTPS 并证书校验;本地偏好设置里的敏感字段先加密再存;日志打印前过一遍脱敏规则。

四、隐私合规:声明、收集、共享三者对齐

审核的核心逻辑是「三对齐」:隐私声明里写的、代码实际收集的、第三方 SDK 实际获取的,三者必须一致。实操清单:

  1. 首次启动弹出隐私同意框,未同意前不得初始化任何会采集数据的 SDK;
  2. 隐私政策区分「必要」与「可选」收集项,可选项有独立开关且默认关闭;
  3. 列出所有三方 SDK 的数据收集行为并纳入隐私声明(很多驳回发生在这一条);
  4. 提供账号注销与数据删除入口,并保证后端真的删了。

政策原文与审核细则以华为开发者官网最新版本为准,上架前用官方的隐私检测工具跑一遍自查。

一句话总结:鸿蒙上架的安全合规 = 签名管住身份、权限管住边界、加密管住数据、声明管住承诺。四件事在开发期对齐,上架就是流程问题而不是风险问题。

标签

#鸿蒙开发#应用安全#隐私合规#应用上架

ArkUI 渲染架构与性能优化:状态粒度决定帧率

ArkUI 渲染架构与性能优化:状态粒度决定帧率
关键词ArkUI、渲染性能、状态管理、LazyForEach、组件复用、鸿蒙优化

鸿蒙应用开发进入平稳期后,性能优化的重点从「能不能跑」转向「跑得顺不顺」。ArkUI 作为声明式 UI 框架,性能模型与 Compose、SwiftUI 同源,但有自己的实现细节。理解它的渲染流水线与状态最小化更新机制,是做好鸿蒙性能的前提。

一、ArkUI 渲染流水线:一次状态变更会发生什么

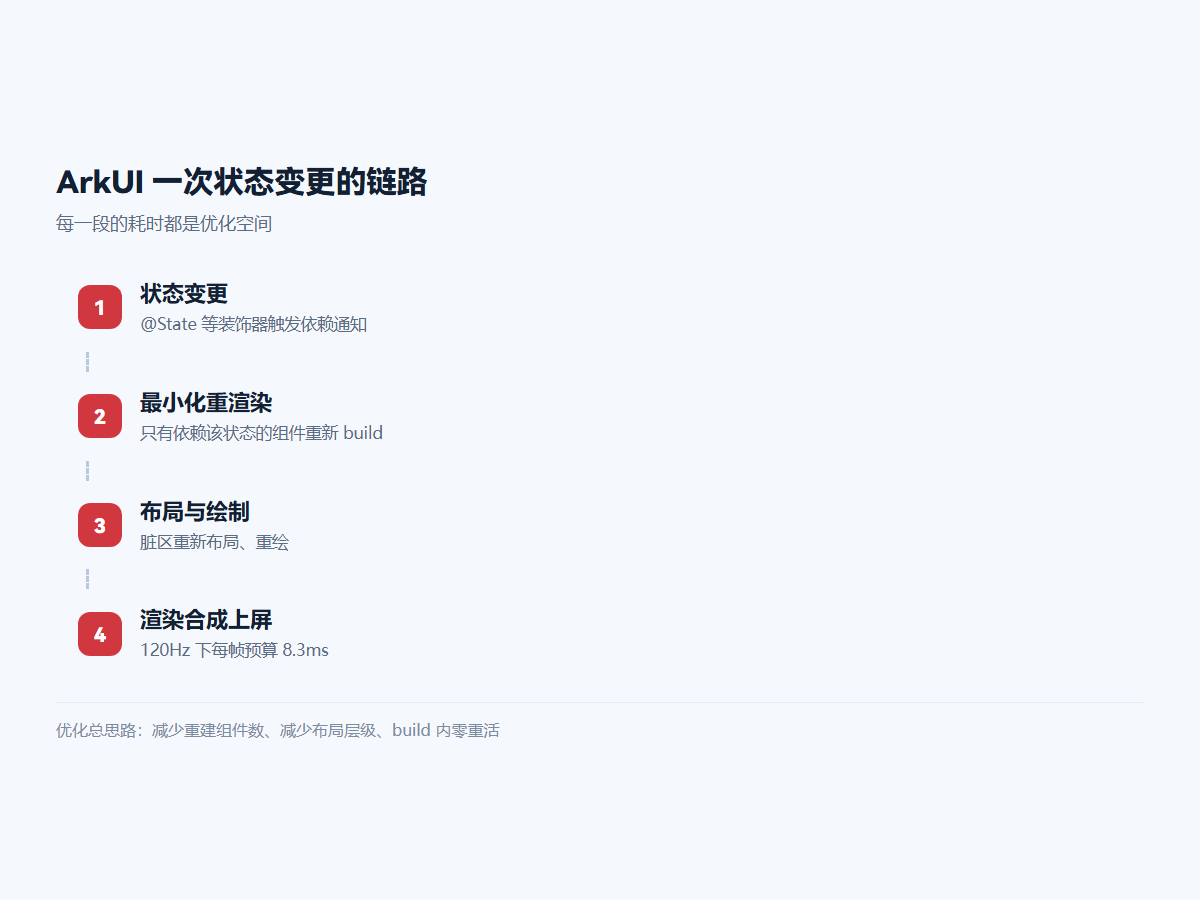
声明式 UI 的核心承诺是「状态变,UI 自动更新」,但这个自动化是有成本的。ArkUI 的一次更新链路:

  • 状态感知:@State/@Prop/@Link 等装饰器建立状态与组件的依赖关系;
  • 最小化重渲染:只有依赖了被改状态的组件会重新执行 build,粒度是组件级;
  • 布局与绘制:被标记的节点重新布局,脏区进入绘制阶段;
  • 渲染合成:最终由渲染服务合成上屏,目标是 120Hz 下每帧 8.3ms 内完成。

优化的全部思路都藏在这条链路里:减少进入「重新 build」的组件数量,减少布局层级,避免在 build 里做昂贵计算。官方性能指导见华为开发者文档性能优化章节。

ArkUI 一次状态变更的链路

二、状态管理:最常见的三个性能反模式

反模式一:大对象整体当状态。把整个列表数据放进一个 @State 数组,任何一项变化都触发依赖该数组的所有组件刷新。正确做法是把状态拆到「恰好需要的粒度」——每一项自己是子组件,只依赖自己那份数据。

反模式二:build 里做同步重活。build 应该是纯函数式的、毫秒级的;格式化大文本、加解密、JSON 解析都应移出 build,放到异步任务或提前算好。

反模式三:@Prop 深拷贝滥用。@Prop 是值拷贝语义,大对象用 @ObjectLink + @Observed 引用传递,避免每次都完整复制。

三、长列表:LazyForEach 是底线

长列表不使用 LazyForEach(按需创建、超出可视区域销毁)而用普通 ForEach,几千条数据直接把内存和首帧拖垮。配合组件复用(@Reusable)与缓存条目数设置,万级列表可以稳定满帧。关键代码形态:

List() {
  LazyForEach(this.dataSource, (item: Item) => {
    ListItem() {
      ItemView({ data: item })   // @Reusable 复用,减少创建销毁开销
    }
  }, (item: Item) => item.id)    // 键值生成函数必须稳定、唯一
}
.cachedCount(5)                  // 预加载屏外条目,平滑滚动

四、工具链:用数据定位,不靠感觉

DevEco Studio 的 Profiler 提供帧率、CPU、内存的时序分析,配合 HiTrace 能看到渲染管线各阶段的耗时分布。实操建议:先录一屏「可疑场景」的帧数据,找丢帧时刻对应的耗时峰值,再回代码查那一帧发生了什么状态变更。优化顺序永远是先解决丢帧(体验硬伤),再解决内存(稳定性),最后才是不影响体验的锦上添花

一句话总结:ArkUI 的性能优化 = 状态粒度足够细 × build 足够便宜 × 列表按需创建。三件事做到位,绝大多数「卡顿」会直接消失。

标签

#ArkUI#鸿蒙开发#性能优化#状态管理

小程序与混合开发 2026:Skyline 时代的技术选型

小程序与混合开发 2026:Skyline 时代的技术选型
关键词小程序开发、Skyline 渲染引擎、混合开发、uni-app、Taro、跨端选型

小程序依然是中国市场流量占比最高的「轻应用」形态,但它和 App、H5 的边界在 2026 年变得更加复杂:微信小程序推出 Skyline 渲染引擎后性能天花板被抬高,鸿蒙原生应用生态又在分流「次世代入口」。对于既要覆盖微信、又要覆盖 App 与鸿蒙的团队,混合开发的技术选型比以往任何时候都重要。

一、先分清三种「混合」

「混合开发」是个被滥用的词,先拆解清楚:

  • WebView 壳 + H5:最传统,开发成本低,但体验受 WebView 性能与桥接开销限制,适合低频工具页;
  • 小程序容器:宿主 App 内嵌小程序运行时(如微信开放给第三方 App 的小程序 SDK),一套小程序代码同时跑在微信和自家 App;
  • 跨端框架编译:Taro、uni-app 等把一套 DSL 编译到小程序/H5/RN 原生,业务代码一份,产物多端。
跨端方案怎么选

二、小程序内的性能分水岭:WebView 与 Skyline

微信小程序传统上跑在 WebView 渲染引擎上,页面切换与长列表是经典弱项。Skyline 改为类原生的渲染管线:去掉 WebView、线程模型更紧凑、支持 worklet 动画在 UI 线程执行,长列表滚动与转场动画接近原生体验。迁移注意两点:Skyline 对 CSS 子集有裁剪(部分旧写法不生效),且不能与同层渲染的部分旧组件混用,老项目要按页面灰度开启。具体能力边界以微信官方文档为准。

无论哪个引擎,小程序性能优化的基本盘没变:控制主包体积(首屏只留核心路径,其余走分包与分包预下载)、 setData 最小化(只传变化字段,避免大对象整体下发)、首屏数据并行(接口预取 + 骨架屏):

// app.json:分包 + 预下载,主包只留首屏核心路径
{
  "pages": ["pages/home/index"],
  "subpackages": [
    { "root": "pkgOrder", "pages": ["list/index", "detail/index"] }
  ],
  "preloadRule": {
    "pages/home/index": { "network": "all", "packages": ["pkgOrder"] }
  }
}

// setData 最小化:改哪项传哪项,别整对象下发
this.setData({ "list[3].status": "paid" });      // ✅ 只动一个字段
// this.setData({ list: this.data.list });       // ❌ 整列表重传

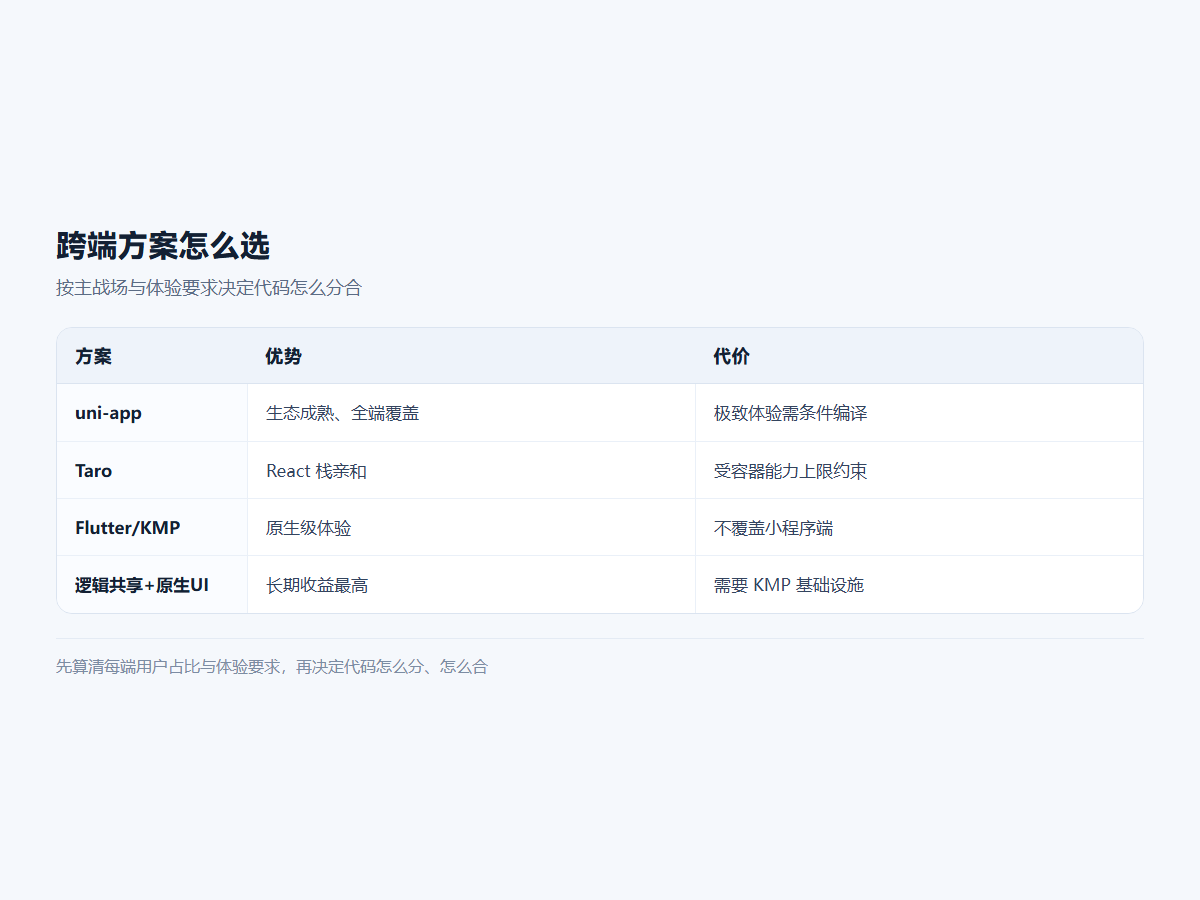
三、跨端框架怎么选

方案 优势 代价
uni-app(Vue 系) 生态成熟、小程序/App/H5 全覆盖、上手快 复杂动效与原生能力要写条件编译,两端体验趋平但不够极致
Taro(React 系) React 技术栈亲和、跨小程序端支持全 同样受小程序容器能力上限约束
Flutter / KMP 原生级体验,适合重交互 App 不覆盖小程序端,包体与团队技能成本高

实务建议:业务主战场在微信生态 → uni-app/Taro 是默认解;App 是主战场、小程序只是引流 → App 用原生或 Flutter,小程序用独立的轻量代码;团队已有 KMP 基础设施 → 业务逻辑层共享 + 双端原生 UI 的模式长期收益最高。

四、2026 年的新变量:鸿蒙入口

鸿蒙原生应用生态成型后,多了一个绕不开的问题:小程序代码能否跑到鸿蒙上?当前主流路径有三条:容器厂商提供的鸿蒙版运行时、跨端框架的鸿蒙编译目标、以及用 ArkUI-X 做局部原生化。决策依据依旧是成本结构——先把逻辑层与 UI 层分离,逻辑层跨端复用,UI 层按端选择最优实现,比押注任何一个「一套代码全端通吃」的承诺更稳。相关跨端能力可参考华为ArkUI-X 官方页面

一句话总结:混合开发的选型没有银弹,先算清楚每一端的用户占比与体验要求,再决定代码怎么分、怎么合

标签

#小程序#混合开发#跨端开发#微信小程序

移动端崩溃治理体系:从口径、归因到灰度闭环

移动端崩溃治理体系:从口径、归因到灰度闭环
关键词崩溃治理、崩溃率、OOM、ANR、灰度发布、移动端质量

崩溃率是移动端最硬的质量指标,但多数团队的治理是「哪里炸修哪里」,修了三年崩溃率还是降不下来。真正有效的治理是一套体系:统一采集口径 → 自动归因 → 分级处置 → 灰度验证。这篇按这套链路展开,适用于 Android(Android 17 / API 37 时代)与 iOS(iOS 26/27 时代)双端。

一、口径先行:崩溃率怎么算,决定了治理动作

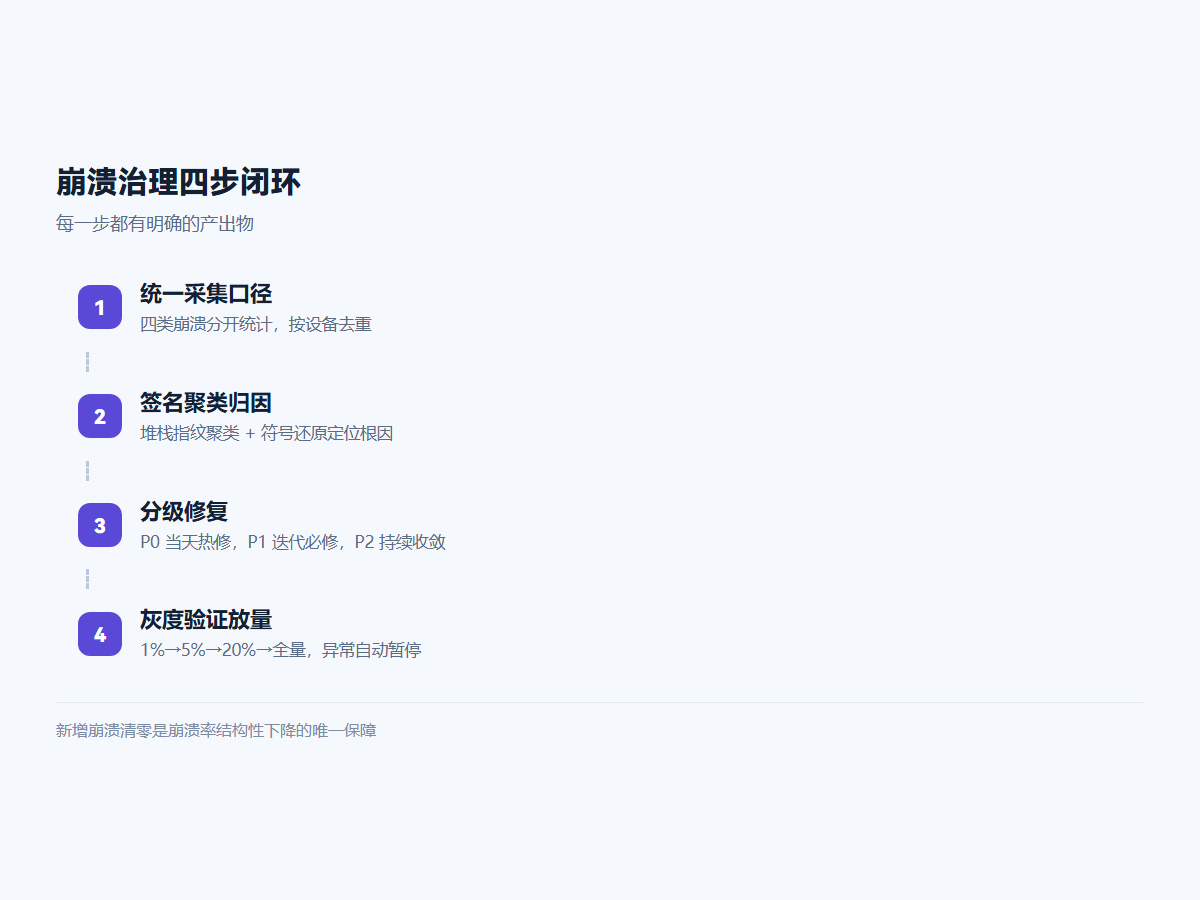
推荐口径:崩溃率 = 当日发生崩溃的设备数 / 当日活跃设备数(按设备去重,而不是按次数)。同时把崩溃拆成四类分开统计,因为处置方式完全不同:

  • Java/Kotlin 未捕获异常(Android)与 NSException/Swift Error fatal(iOS)——常规 bug,修代码即可;
  • OOM——不是传统 crash,常被系统标记为 killed,需要内存水位与页面轨迹还原;
  • ANR / Watchdog——主线程阻塞,需要看主线程堆栈与消息队列;
  • Native Crash——so/dylib 符号还原是关键,删除符号表前务必归档对应版本。
崩溃治理四步闭环

二、采集:信息不全的崩溃日志等于没有

崩溃日志的最低配置:完整线程堆栈 + 设备/系统/版本/构建号 + 内存水位 + 页面路径(崩溃前访问的页面序列)+ Breadcrumbs(崩溃前最近的用户动作与网络请求摘要)。双端官方工具链:Android Studio 调试与 ANR 工具、Xcode Organizer 与 MetricKit。接第三方 APM 时注意一点——自建符号表服务或确认厂商符号表上传流程,混淆/ stripping 后没有符号还原,堆栈就是天书。

三、归因与分级:Top 1% 的崩溃占 80% 的量

聚合时按「堆栈签名」聚类(取堆栈最深的 app 包帧做指纹),而不是按错误消息。然后按影响面分级:

级别 标准(示例) 响应动作
P0 新增崩溃 & 影响设备 > 0.5%,或启动即崩 当天热修,阻断灰度推进
P1 影响 0.1%–0.5%,或老版本高发 本迭代必修,纳入版本门禁
P2 长尾崩溃,影响 < 0.1% 按迭代排期,持续收敛

「新增崩溃」是治理的灵魂指标:每个版本发出去之前,对比上一版本,新引入的崩溃签名必须清零或给出豁免理由,这是崩溃率长期下降的唯一保障。

四、防复发:把稳定性做进流程

  1. 灰度发布:新版本按 1% → 5% → 20% → 全量推进,每个台阶盯 24 小时崩溃率,异常自动暂停放量;
  2. 启动路径重点保护:启动链路上的崩溃影响最大,这段代码的变更要求更高测试覆盖与更激进的容错(try-catch 兜底 + 功能降级);
  3. 三方 SDK 隔离:SDK 崩溃往往占了 Top 榜一大截,升级 SDK 视同代码变更,进灰度流程;
  4. OOM 专项:图片按需解码、大图下采样、页面退出时释放资源监听——OOM 无法从崩溃堆栈直接归因,必须靠内存水位曲线 + 页面轨迹回放。

「启动路径容错」的一个具体形态——初始化隔离,任何一个三方 SDK 炸了都不影响主流程:

object SafeInitializer {
    fun initAll() {
        // 逐个隔离初始化:单个 SDK 失败只记埋点,不中断启动
        listOf(::initAnalytics, ::initPush, ::initPay).forEach { init ->
            try {
                init()
            } catch (t: Throwable) {
                CrashMonitor.record("init:" + init.javaClass.name, t)
            }
        }
    }
}

一句话总结:崩溃治理不是修 bug 的速度问题,而是口径、归因、分级、灰度四件事是否成为团队默认动作的问题。新崩溃清零 + 灰度自动熔断,坚持两个版本周期就能看到崩溃率结构性下降。

标签

#崩溃治理#移动端#质量保障#稳定性

PostgreSQL 生产实践:连接池、VACUUM 与索引选型

PostgreSQL 生产实践:连接池、VACUUM 与索引选型
关键词PostgreSQL 18、PgBouncer、VACUUM、索引选型、EXPLAIN、数据库调优

PostgreSQL 在 2026 年的生态地位不需要再论证:AI 应用的向量检索(pgvector)、地理数据(PostGIS)、时序(TimescaleDB)都在往 PG 上收敛,PostgreSQL 18(2025 年 9 月发布)带来的异步 I/O(io_method = io_uring/worker)让顺序扫描和大表读取有明显提速。但「选 PG」和「用好 PG」是两回事,这篇聚焦生产环境最常翻车的五件事。

一、连接:别让连接数杀死数据库

PG 的每个连接是一个进程,直连模式下几千个连接的内存与调度开销足以拖垮实例。生产标配是 PgBouncer 或内置连接池(Supabase/云厂商 RDS 均已内置):

# pgbouncer.ini 关键项
pool_mode = transaction        # 事务级复用,吞吐最高
max_client_conn = 5000         # 客户端侧上限
default_pool_size = 40         # 到 PG 的真实连接数
server_reset_query = DISCARD ALL

用 transaction 模式的前提:不用 session 级特性(SET、游标跨事务、advisory lock 的 session 模式),否则会出现「连接串味」的诡异 bug。

二、索引:会建更要会查

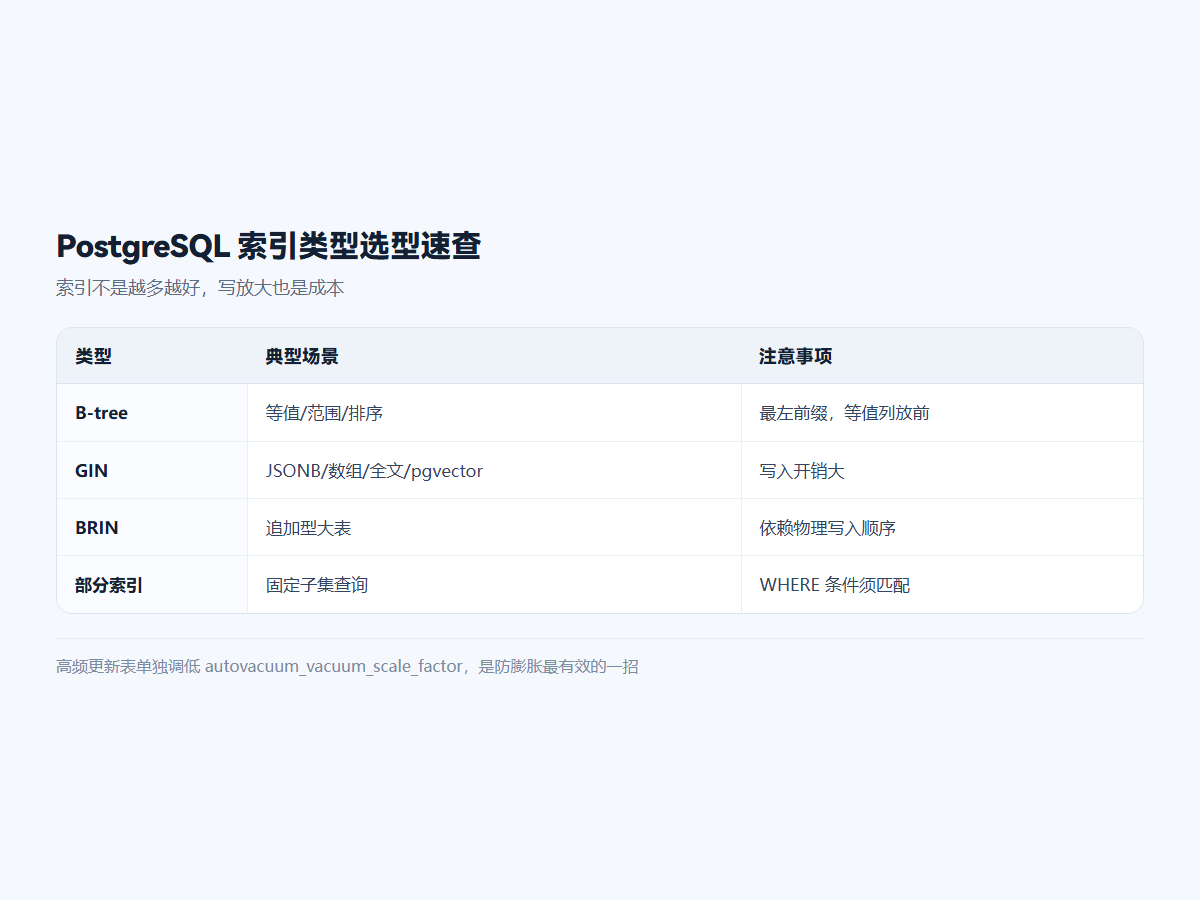
索引不是越多越好,写放大和规划器的开销都是成本。选型速查:

类型 场景 注意
B-tree 等值/范围/排序,默认首选 最左前缀原则,联合索引把等值列放前
GIN 数组、JSONB、全文检索、pgvector 写入开销大,更新频繁的表要权衡
BRIN 追加型大表(日志、事件流) 依赖物理顺序,乱序写入基本失效
部分索引 只查「未处理」等固定子集 WHERE status='pending',小而精准

三、VACUUM:理解 MVCC 才能理解膨胀

PG 的 UPDATE/DELETE 不原地修改数据,而是留旧版本等 VACUUM 回收。autovacuum 默认参数对大表过于保守,容易出现表和索引膨胀。两个硬性动作:高频更新的表单独调低 autovacuum_vacuum_scale_factor(如 0.01),定期用 pg_repack 在线重建膨胀严重的索引。监控上盯住死元组数与表年龄(防事务 ID 回卷),比盯 CPU 更能提前发现问题。官方文档对 routine vacuuming 有完整说明。

PostgreSQL 索引类型选型速查

四、EXPLAIN:调优的第一入口

所有慢查询先用 EXPLAIN (ANALYZE, BUFFERS) 而不是 EXPLAIN——前者拿真实执行数据。重点看三处:行数估算与实际的偏差(偏差大说明统计信息过期,先 ANALYZE);是否出现 Seq Scan 扫大表;Buffers: shared read 是否远大于 hit(缓存命中率低)。

五、分区与扩展:设计期决定上限

单表过亿再想分区就晚了。PG 18 的原生分区按 时间范围分区最常用(配合 BRIN 索引近乎零成本),把「删旧数据」变成「drop 分区」这种瞬时操作。水平扩展方面,Citus 或应用层分片都成熟,但先做好垂直拆分与归档,90% 的场景不需要一开始就分片。版本升级用逻辑复制做近零停机迁移,是当前最稳的路径(大版本变更参考 官方升级指南)。

一句话总结:PG 生产化的功夫在连接池、autovacuum、索引选型这三件朴素的事上——它们不起眼,但决定了系统是「能跑」还是「稳跑」。

标签

#PostgreSQL#数据库#性能调优#运维实践

API 网关与流量治理:限流算法、熔断降级与 Mesh 边界

API 网关与流量治理:限流算法、熔断降级与 Mesh 边界
关键词API 网关、限流算法、令牌桶、熔断降级、Service Mesh、流量治理

流量入口的架构在 2026 年发生了明显分化:南北向流量(客户端 → 服务)继续收敛到 API 网关,东西向流量(服务 ↔ 服务)则分化出 Service Mesh 与传统 SDK 治理两条路线。很多团队的问题是把两类流量塞进同一套治理方案,结果两头不讨好。这篇讲清入口网关的职责边界、限流熔断的正确打开方式,以及什么时候才真的需要 Mesh。

一、入口网关只做四件事,多了就是负担

API 网关(Nginx 1.30/1.31 稳定线、APISIX、Higress、Kong 等)的核心价值高度收敛:

  • 路由与协议转换:路径/域名/Header 路由,gRPC-Web、WebSocket 等协议桥接;
  • 安全防护:TLS 终止、认证鉴权(JWT/OIDC)、WAF、IP/地域封禁;
  • 流量治理:限流、熔断、灰度分流、重试与超时策略;
  • 可观测:访问日志、Trace 采样入口、监控埋点。

把业务逻辑、复杂聚合、数据拼装放进网关层是最常见的反模式——网关应该保持「薄」,编排型 BFF 单独成层。

四种限流算法怎么选

二、限流:算法选对,位置放对

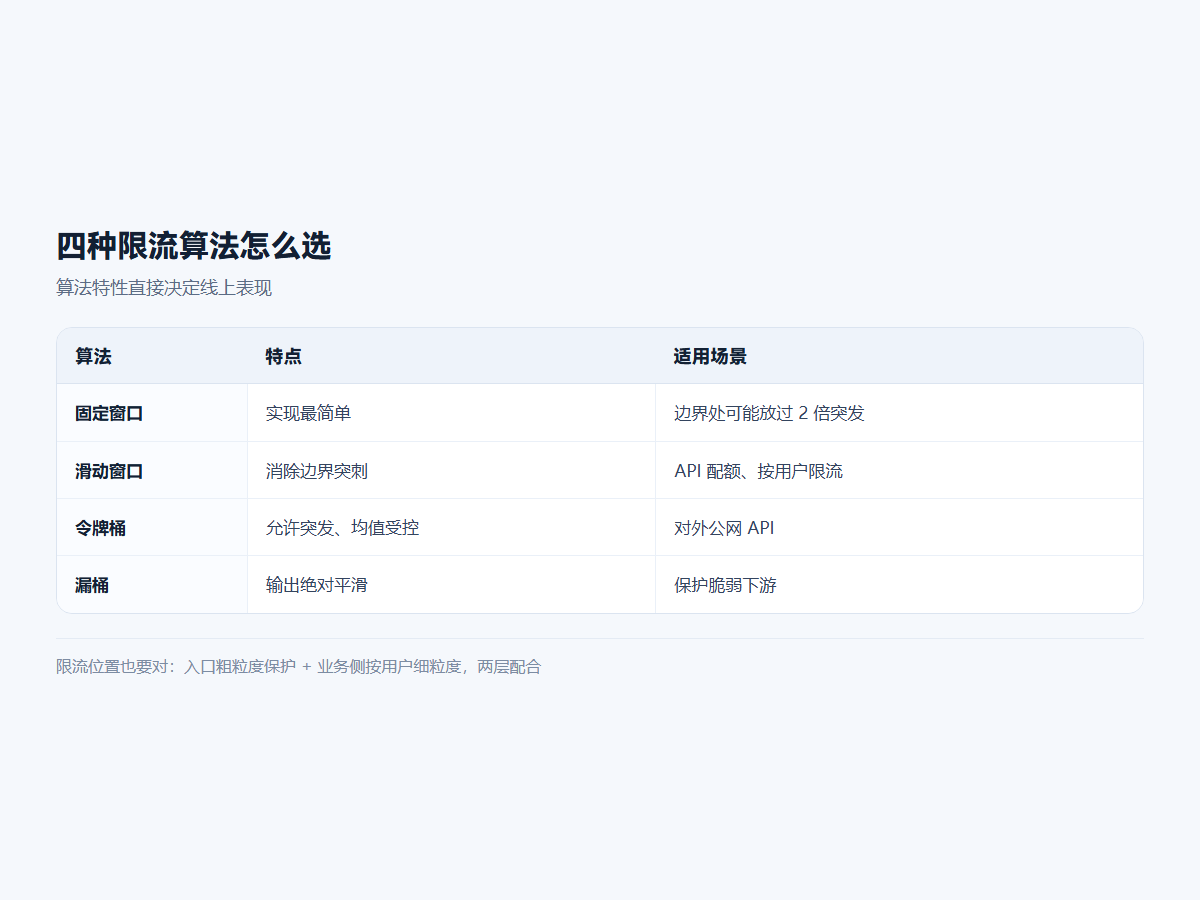
限流不是「配个数字」,算法特性差异直接影响线上表现:

算法 特点 适用
固定窗口 实现最简单,但窗口边界处可能瞬间放过 2 倍流量 粗粒度保护、内部调用
滑动窗口 消除边界突刺,统计精度与成本平衡好 API 配额、按用户限流
令牌桶 允许突发(桶内攒令牌),平均速率受控 对外暴露的公网 API,容忍合理突发
漏桶 输出速率绝对平滑 保护脆弱的下游(如老系统、三方接口)

以 Nginx 为例,limit_reqburst + nodelay 组合就是「令牌桶」语义:

limit_req_zone $binary_remote_addr zone=api:10m rate=100r/s;

server {
  location /api/ {
    limit_req zone=api burst=200 nodelay;  # 允许 200 的突发,不排队
    limit_req_status 429;
    proxy_pass http://upstream;
  }
}

三、熔断与降级:给失败留一条设计好的路

熔断的判断依据建议用滑动错误率 + 最小请求数双条件(例如 30 秒内错误率 > 50% 且请求数 ≥ 100 才触发),避免低峰期几个偶发错误就误熔断。半开状态放小流量探测恢复。降级预案必须在设计期确定:返回缓存数据、返回默认值、还是功能开关关闭入口——没有预案的熔断只是把 500 换成另一种 500

四、什么时候才需要 Service Mesh

Mesh 解决的是东西向流量的治理逻辑从 SDK 中剥离的问题。判断标准很实际:语言/框架异构程度高(Java + Go + Node 混合)、微服务数量大(50+)、SDK 升级成本已经成为团队痛点——三条满足两条再上 Mesh,否则 Sidecar 的资源开销与运维复杂度会先吃掉收益。中小规模的服务治理用「网关 + 稳定版 SDK(重试/熔断/负载均衡)」依然是性价比最高的组合。

一句话总结:南北向靠网关做薄而稳的入口治理,东西向先靠 SDK,规模到了再上 Mesh。顺序反了,复杂度就会反过来治理你。

标签

#API 网关#限流#高可用#微服务