loader

Nerio News Magazine brings you trusted, timely and thought-provoking stories from around the globe.

Follow Us

群面与谈薪终局:无领导讨论、Offer 决策与背调期纪律

群面与谈薪终局:无领导讨论、Offer 决策与背调期纪律
关键词无领导小组讨论、群面技巧、谈薪、Offer 决策、背调、终面

到了终面与谈薪环节,游戏规则变了:前面考察的是能力,这里考察的是判断力与成熟度。群面(无领导小组讨论)考察协作中的角色意识,谈薪与 Offer 决策考察你对自己市场价值的认知。这篇把三个环节的实操策略一次讲清。

一、群面:角色比观点更重要

无领导小组讨论有个反直觉的事实:淘汰的往往不是「说得少的人」,而是「角色错位的人」。常见的角色与得分策略:

  • 破题者:开场快速拆解问题框架(目标是什么、维度有哪些、时间怎么分)——高风险高收益,框架拆得好直接建立话语权;
  • 推进者:在讨论跑偏时拉回主线(「我们先对齐第二个维度的标准再讨论」)——最稳妥的高分角色;
  • 记录/总结者:阶段性小结共识与分歧(「目前我们达成两点共识,卡在 X,建议先解决 X」)——发言量适中但存在感强;
  • 时间管理员:提醒进度节点——存在感弱,需配合有质量的发言。

三个扣分行为:强行打断他人(哪怕观点好);全程附和无立场;为反对而反对。群面的隐藏评分项是你如何对待说错话的人——帮下台的人体面收场,考官都看在眼里。

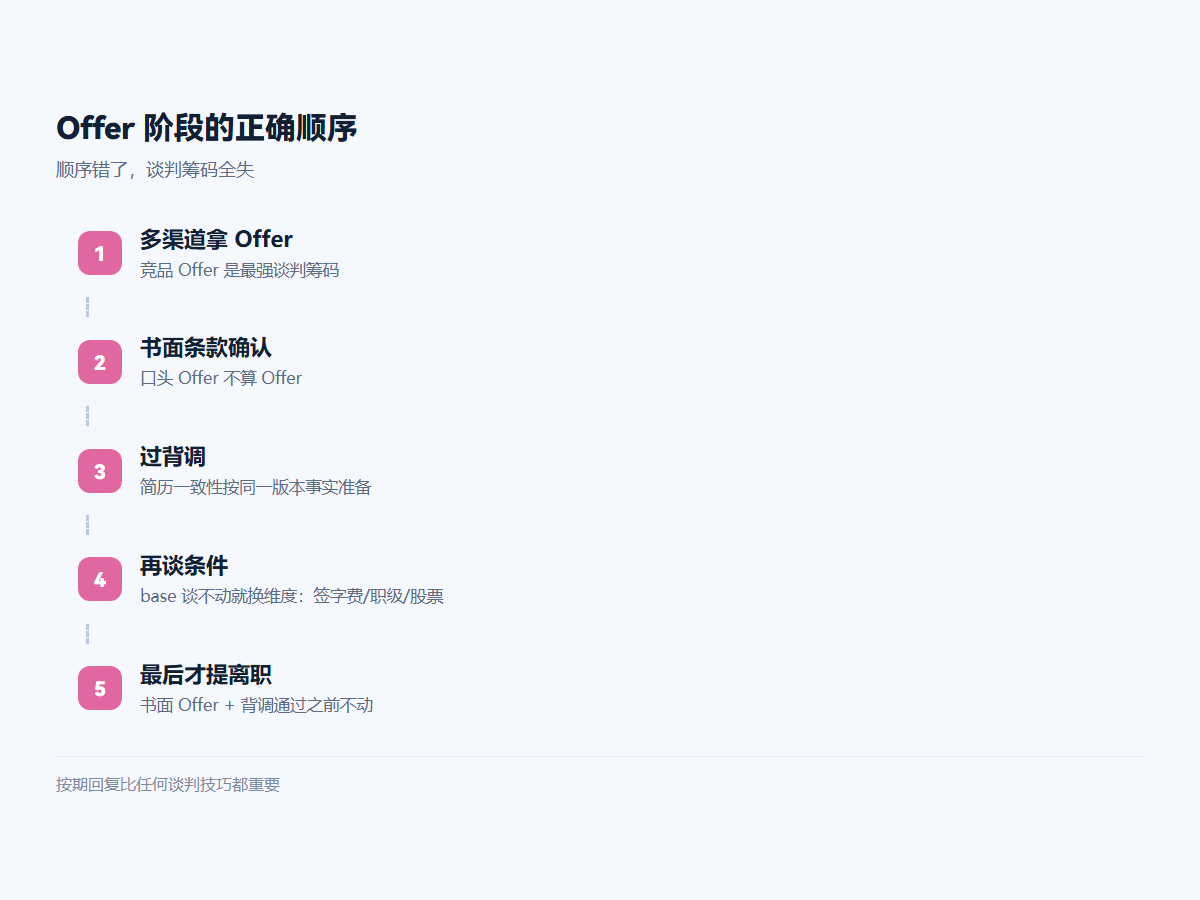
Offer 阶段的正确顺序

二、群面典型题型与破题模板

题型 破题框架 关键动作
排序题(如「荒岛求生带什么」) 先定「排序标准」再排序 把争论从「选什么」引导到「标准是什么」,这是破局点
开放设计题(如「给 XX 做增长方案」) 目标 → 拆维度 → 资源约束 → 取舍 主动认领「先对齐目标」的角色
两难题(如「利润 vs 用户价值」) 找第三条路或定义适用条件 避免站队式争论,提出「什么条件下选 A、什么条件下选 B」
资源分配题 先定分配原则,再逐项落 原则先行可以避免逐项拉扯消耗时间

三、谈薪:让对方先出价,但自己心里要有数

谈薪的第一原则:不要在没有信息的情况下先报数字。标准应对:

HR:"你的期望薪资是多少?"
你:"我相信贵司有成熟的定薪体系,方便先了解一下这个岗位的
     预算范围吗?我好判断是否与我的预期匹配。"

如果被坚持要求先出价,给区间而不是点值,区间下限 = 你的真实心理价位。报价依据三件套:当前薪资结构(底薪 + 奖金 + 股票折现)、市场行情(同职级多渠道了解)、竞品 Offer(有就是最强筹码,没有不硬编)。

四、Offer 决策与背调期的注意事项

  1. 多 Offer 对比框架:现金总包(注意 base 与奖金比例,奖金占比高的要打折评估)、成长性(业务趋势 + 直属上级水平 + 团队技术氛围)、稳定性(盈利状况/现金流/裁员历史)、通勤与生活成本;
  2. 争取时间的正确话术:「非常感谢信任,我需要 X 天认真评估,最迟 X 日给您答复」——按期回复比任何技巧都重要;
  3. 口头 Offer 不算 Offer:关键条款(薪资结构、试用期、绩效规则、股票行权条件)落到书面再考虑辞职;
  4. 背调期纪律:拿到书面 Offer 并过背调前,不要提离职。背调内容与简历一致性、前司评价,都按「事实陈述」准备,与离职原因话术保持同一版本;
  5. 协商的空间在哪:base 空间通常有限但可谈(用竞品 Offer);签字费、职级、股票、测评期、入职时间都可能是更弹的谈判项——「薪资谈不动时换维度谈」。

五、终面的隐性考察点

终面(高管面)通常不再问技术,看的是三件事:判断力(对行业与业务的理解,准备两三个关于公司业务的观察与问题)、成熟度(聊失败经历时是否既坦诚又有复盘能力)、意愿强度(为什么是我们、你还有什么想问的——问出好问题本身就是最强的意愿信号)。到这个环节,方法论已经不够用了,拼的是你对自己职业生涯是否真的想清楚了。

标签

#HR面试#群面#谈薪技巧#Offer

离职原因与职业规划:HR 面试的诚实表达框架

离职原因与职业规划:HR 面试的诚实表达框架
关键词离职原因怎么答、职业规划怎么答、HR 面试、话术框架、背调、裁员

HR 面试里最难的两问是「为什么离职」和「你的职业规划」——答好了是加分题,答砸了直接出局。它们的难点在于:既不能说谎(背调会穿帮),又不能全说真话(可能暴露风险)。这篇给一套诚实且有策略的表达框架,覆盖常见场景的具体话术。

一、离职原因的三段式框架

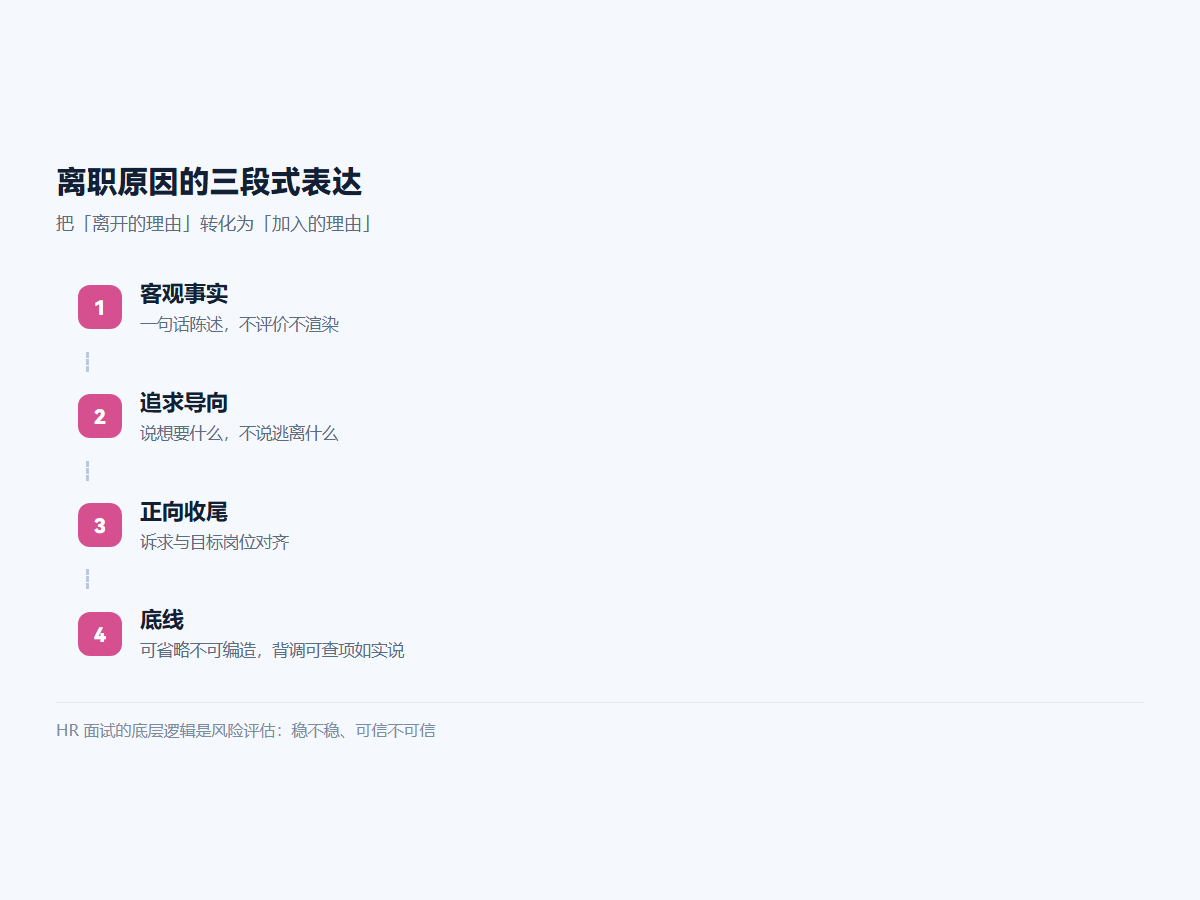
推荐的答法结构:客观事实 → 追求导向 → 正向收尾。全程不抱怨前东家,把「离开的理由」转化为「加入你的理由」。

  • 客观事实:一句话陈述真实情况,不评价、不渲染;
  • 追求导向:说明你想要什么(成长空间、技术挑战、业务方向),而不是在逃离什么;
  • 正向收尾:把诉求与目标岗位对齐——「贵司这个方向正好是我想要的」。
示例:
"我在上家公司三年,从初级做到模块负责人,技术栈和团队都很认可。
 但公司业务方向调整后,我负责的模块逐步边缘化(客观事实)。
 我希望在核心业务里继续做有挑战的技术工作(追求导向),
 贵司的 XX 业务正好是我看重的方向(正向收尾)。"
离职原因的三段式表达

二、六种常见场景的具体话术

场景 推荐说法 禁忌
被裁员/优化 大方直说:「业务收缩整条线被优化,与个人绩效无关,补偿与推荐都正常」 遮掩或编造「个人原因」——背调极易穿帮
薪资不满意 「薪酬与成长同步评估,目前涨幅空间已见顶,希望到价值定价更合理的平台」 只谈钱,显得价值观单一
晋升受阻 「内部坑位有限,我准备好承担更大职责但通道拥挤,希望去有空间的地方」 抱怨领导「不识人」
团队/领导矛盾 只谈风格适配:「管理风格偏 X,与我习惯的 Y 方式不匹配,这是事实陈述不是对错判断」 讲述矛盾细节、指责前上级
加班/强度问题 「我接受高强度,但不接受无意义消耗,希望投入产出可衡量的环境」 给人「怕吃苦」的印象
转行/转方向 用「长期积累 + 主动选择」叙事:此前经历如何为转向提供基础 说「之前做的不喜欢」——否定了自己的履历

三、高频追问与拆解

「你在上家待了三年,会不会在我们这也待不久?」——答题要点:把稳定性归因于「成长是否持续」而非「习惯不动」:前三年每年职责都有实质扩展,未来三年在贵司的成长路径是 XX,所以会持续投入。

「你同时在看哪些机会?」——诚实但模糊:「在看同方向的几个机会,贵司是我优先级最高的,因为 XX(具体到业务/技术细节)」。既表明竞争力,又给对方确定性。

「如果你入职后发现和预期不符怎么办?」——先验证后承诺:「面试阶段我会尽量了解清楚(反问细节);入职后短期差异我先适应观察,长期结构性差异会正式沟通,而不是消极对待。」

四、职业规划的「三层递进」答法

  1. 近期(1–2 年):具体到岗位能力——「把 XX 方向的核心能力补齐,独立负责一个模块/子系统」;
  2. 中期(3–5 年):方向而非头衔——「在 XX 领域形成技术深度 + 带小团队交付完整业务的经验」;
  3. 底层逻辑:说明你的选择标准(技术驱动 or 业务驱动),并解释为什么目标岗位在这个路径上。

禁忌:说「三年当管理者、五年当总监」(头衔式规划显得浮);说「没想过」(显得无目标);规划与应聘岗位明显脱节(显得拿这里当跳板)。

五、底线与红线

两条底线:一是可以策略性省略,但不编造事实——裁员、绩效、竞业这些背调可查项,坦白比被戳穿成本低得多;二是不透露前司机密——被问「上家核心数据/方案」时礼貌拒绝,反而是诚信加分项。HR 面试的底层逻辑是风险评估:你讲的所有内容,最终都会被归约为「这个人进来后稳不稳、可信不可信」。用事实与逻辑回答,比任何话术技巧都有效。

标签

#HR面试#离职原因#职业规划#面试话术

鸿蒙性能调优 25 问:状态粒度、LazyForEach 与工具链

鸿蒙性能调优 25 问:状态粒度、LazyForEach 与工具链
关键词鸿蒙性能面试、ArkUI 状态管理、LazyForEach、cachedCount、DevEco Profiler、性能基线

鸿蒙性能调优面试与技术文章的差异在于:面试官要的是「指标 → 工具 → 手段 → 验证」的完整闭环。这份 25 问按启动、状态与渲染、列表与滑动、内存与功耗、工具链五个板块组织,答案都控制在「面试口述 30 秒」的长度。

一、启动性能(5 问)

1. 鸿蒙应用启动流程分几段?

应用冷启动:进程创建 → AbilityStage 启动 → UIAbility onCreate → 首帧渲染 → 页面可交互。优化窗口主要在 onCreate 之前的初始化与首屏布局。

2. onCreate 里最适合做什么、最不该做什么?

只做:路由参数解析、首屏必需数据准备。不做:非首屏 SDK 初始化(挪到首帧后异步)、同步 IO、大对象解析。用启动任务编排(TaskPool + 依赖图)管理。

3. 启动耗时怎么测?

Profiler 的 Launch 模板给分段耗时;线上用 HiLog 打点(进程创建 → 首帧完成)上报 p75。两套数据对齐看,实验室定位、线上验收。

4. 首屏加载慢的通用组合拳?

首屏数据预取(AbilityStage 阶段发请求)+ 布局精简(层级浅、懒加载非首屏组件)+ 缓存快照先渲染 + 骨架屏兜底。

5. HSP/HAR 对启动有什么影响?

共享包越大加载越重,非首屏能力的 HAR 拆出去按需加载;动态 HSP 可延迟加载。答题要点:模块化本身就是启动优化的一部分。

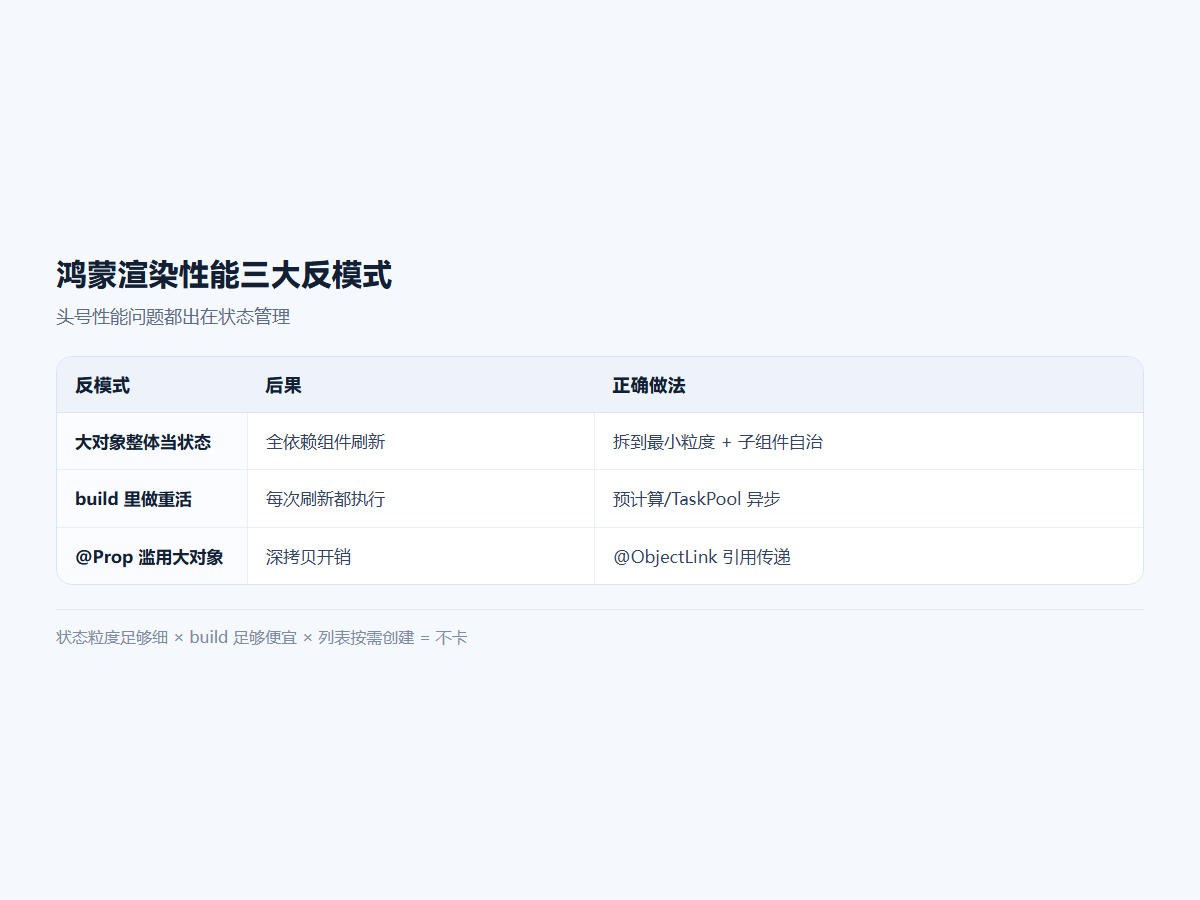
鸿蒙渲染性能三大反模式

二、状态管理与渲染(6 问)

6. 状态更新粒度怎么优化?

状态拆到最小必要粒度:列表项数据各自管理,避免大数组整体 @State;依赖该状态的组件越少越好。回答时给出「大对象 → 拆子组件」的对照例子。

7. @State、@Prop、@Link、@ObjectLink 怎么选?

@Prop 值拷贝(适合简单值,大对象开销大);@Link 双向同步;@ObjectLink + @Observed 引用传递(大对象/嵌套对象首选)。选型错误是渲染性能问题的头号来源。

8. build 里写重逻辑为什么是反模式?

build 每次状态变更都会执行,任何重活(格式化/解析/过滤)都会被放大执行。对策:预计算、TaskPool 异步、缓存结果。

9. 什么情况用 @Watch?要注意什么?

状态变化的旁路监听(联动更新)。注意:回调里再改状态可能触发循环更新,要有终止条件;高频变化的状态不适合 @Watch 逐次响应,应节流。

10. 组件复用(@Reusable)的原理与适用场景?

滑出屏幕的组件实例回收进复用池,滑入时复用并更新数据,省创建销毁开销。适合结构同构的长列表项;结构差异大的组件复用收益低。

11. 一次性大变更怎么减少渲染压力?

批量更新合并(一次事务里改多个状态,框架自动批处理)、避免连环 @Watch 级联、用 @Computed 派生值代替手动同步多份状态。

三、列表与滑动(5 问)

12. LazyForEach 的三个必要条件?

必须配合数据源类(实现 IDataSource 通知机制)、键值生成函数稳定唯一、在 List/Grid/Swiper 容器内使用。普通 ForEach 是全量创建,列表性能的天花板就在这。

13. cachedCount 怎么设置?

屏外预加载条数:太小(滚动白屏)与太大(创建浪费)都不好,默认值基础上按 item 高度与机型调优,配合流畅度实测。

14. 长列表滚动丢帧的排查顺序?

先确认 LazyForEach + 复用生效 → 看 item 绑定逻辑(有没有 IO/解析)→ 图片解码是否异步 + 尺寸匹配 → 最后用 Profiler 帧分析看单帧耗时构成。

15. 嵌套滑动(List 里嵌 Grid)怎么优化?

避免深层嵌套(层级每深一层布局开销乘一次);固定 item 尺寸减少测量;嵌套滚动联动用系统提供的嵌套滚动选项而不是手势自定义。

16. 图片加载的正确姿势?

尺寸匹配显示区域(源头下采样)、异步解码、列表滑动中按需取消不必要加载、合适的内存缓存策略。

四、内存与功耗(4 问)

17. 内存问题的核心指标与工具?

内存水位、GC 频率、泄漏对象增长曲线。工具:DevEco Profiler Memory 模板做时序分析,快照对比找泄漏。

18. 常见内存泄漏场景?

全局单例持有页面级对象、事件订阅未解绑、@Watch 回调闭包持有大对象、native 引用未释放(NAPI 场景)。治理手段同移动端通用:生命周期对齐 + 快照 diff。

19. 功耗优化的关注点?

减少后台活跃:定位/传感器的采集频率按需降级、网络批量合并、动画在不可见时暂停、后台任务用系统调度托管。

20. 高刷屏适配要注意什么?

帧预算从 16.7ms 变 8.3ms,原来「刚好不卡」的代码会现形;按场景申请刷新率(静态页降频省电,滑动时高刷),动画实现走系统属性动画而非定时器。

五、工具链与度量(5 问)

21. DevEco Profiler 的常用模板有哪些?

Launch(启动)、CPU(热点函数)、Memory(水位与泄漏)、Frame(丢帧分析)、Time/HiTrace(跨进程调用链)。答题时按「问题类型 → 模板」对答。

22. 怎么建立性能基线与防回退机制?

核心场景(启动/关键页滑动)定义量化指标 → 每日构建自动化跑真机采集 → 指标进看板,劣化超阈值阻断发版。有这条答案,前面所有优化才是可信的。

23. 真机与模拟器的性能差异怎么处理?

结论一律以真机为准(模拟器渲染管线不同);用中低端真机建立「性能下限」标准,旗舰机数据只作参考。

24. 状态管理的最佳实践总结成几条?

粒度最小、单向数据流、派生用 @Computed、跨层传值避免逐层 @Link(用 Provide/Consume 或事件总线)、大对象引用传递。能背出并解释,说明有实战。

25. 「页面滑动偶尔卡顿」这种模糊反馈,怎么系统性地查?

先复现定场景(机型/操作路径),Profiler 录帧找丢帧时刻 → 定位那一帧的状态变更与组件重建范围 → 归因到状态粒度/布局层级/IO 三类之一 → 修复后同场景回归对比帧率。展示「可复现 → 可定位 → 可验证」的闭环就是满分答案。

标签

#鸿蒙面试#性能优化#状态管理#ArkUI

NAPI 与原生混合开发 20 问:线程安全与跨边界设计

NAPI 与原生混合开发 20 问:线程安全与跨边界设计
关键词NAPI 面试、鸿蒙 NAPI、线程安全函数、ArrayBuffer 零拷贝、napi_wrap、混合开发

NAPI(Node-API / 原生 API)是鸿蒙应用「性能敏感场景」的必经之路:ArkTS 跑不动的计算(音视频编解码、加解密、图像处理、算法推理)都要下沉到 C/C++。面试中它考察两个维度:机制理解(数据怎么跨语言传递)与工程能力(线程、内存、崩溃怎么管)。这份 20 问覆盖两层。

一、机制与基础(7 问)

1. NAPI 是什么?与 Node.js 的 Node-API 什么关系?

鸿蒙 NAPI 基于 Node-API 规范演进,接口形态相似(napi_env/napi_value 等),但运行环境是 ArkTS 运行时而非 Node.js。可以理解为「同源规范、不同宿主」,代码迁移成本低但不能直接假设行为一致。

2. ArkTS 与 C/C++ 之间的数据怎么传递?

跨语言边界一切皆 napi_value。基本类型用 napi_get_value_* 系列提取;对象用属性读写;大块数据用 ArrayBuffer/TypedArray 零拷贝共享——这是性能题的得分点:小数据走值拷贝,大数据必须走共享内存路径。

3. 同步接口与异步接口怎么选?

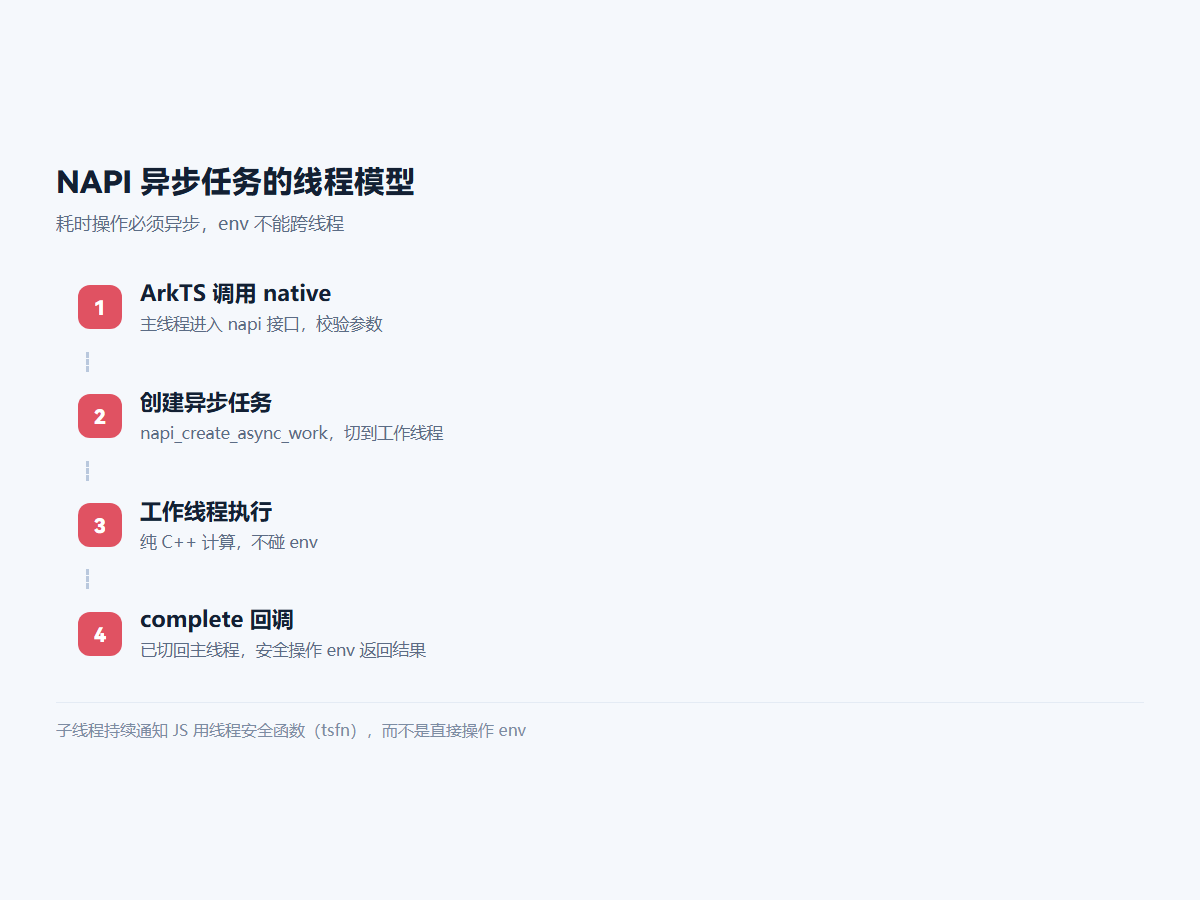
耗时超过几毫秒的操作必须异步:同步调用会阻塞 ArkTS 主线程导致掉帧。异步模式:napi_create_async_work 创建异步任务,工作线程执行,完成后切回主线程回调。

4. Promise 风格的原生接口怎么实现?

napi_create_promise 拿到 deferred,异步任务完成后 napi_resolve_deferred。工程上比 callback 风格更符合 ArkTS 的 async/await 使用习惯。

5. napi_env 能在任意线程用吗?

不能。env 与线程绑定,子线程要用 napi_get_threadsafe_function 创建线程安全函数,或在异步任务的 complete 阶段(已切回主线程)再操作 env。这是 NAPI 面试最高频的坑题。

6. native 层的内存生命周期怎么管?

JS 对象持有的 native 指针用 napi_wrap 绑定,GC 回收时 unwrap finalize 回调释放;跨回调持有的引用必须 napi_create_reference 管理,用完 delete_reference。答出「不要裸 new 不还」即可及格。

7. handle scope 是干什么的?

管理 napi_value 的生命周期作用域(napi_open_handle_scope/close),长循环里不手动管理会内存膨胀;跨 scope 保留值要 escape scope。这类细节题答得出,说明真写过。

NAPI 异步任务的线程模型

二、工程实践(7 问)

8. 什么场景值得下沉 native?判断标准?

计算密集(编解码/加密/压缩)、复用现有 C/C++ 库(OpenCV/FFmpeg/算法库)、需要稳定性能上限。纯业务逻辑下沉是负优化——跨边界开销大于收益。

9. 怎么测量「下沉到底值不值」?

先测 ArkTS 版耗时分解:如果大头在数据跨边界序列化而非计算,下沉反而更慢。用 Profiler 对比「总耗时 = 计算 + 边界开销」,边界开销占比高时考虑批量传输(一次传大块)摊薄成本。

10. 线程安全函数(thread-safe function)的原理?

它是一个「可跨线程调用的 JS 回调代理」:子线程调用 tsfn,内部排队,由 JS 线程按调度策略(每 tick 执行数量)实际执行。用于进度通知、数据流推送等子线程 → JS 的持续通信。

11. native 崩溃怎么排查?

崩溃日志带 native 堆栈(so 偏移地址)→ 用 addr2line/符号表还原 → 结合 addr2line 输出定位到源码行。与移动端崩溃治理同构:符号表归档是生命线

12. C++ 库怎么集成到鸿蒙工程?

CMake 构建,CMakeLists.txt 声明源文件与三方库依赖,产物 so 打进 hap;三so 架构(arm64-v8a 等)按设备分发。预编译库注意 NDK 版本与 libc++_shared 的兼容。

13. NAPI 模块的单元测试怎么做?

纯 C++ 逻辑抽出来用原生测试框架测(不依赖 JS 边界);边界层用 ArkTS 测试驱动真实调用。原则:把可测的逻辑留在 native 内部测,边界层薄到不值得测。

14. 混合开发的模块怎么组织代码结构?

native 模块独立成 har/hso,对外只暴露 NAPI 头文件与 ArkTS 封装层;ArkTS 侧再包一层语义化 API。禁止业务代码直接摸 napi_* ——封装层隔离未来运行时变化。

三、进阶与设计(6 问)

15. 大数据流(如视频帧)持续跨边界的架构?

共享内存 + 通知模式:native 写 ArrayBuffer,用 tsfn 只发「有新帧」的轻量通知,ArkTS 侧按需读取;避免每帧深拷贝 + 每帧回调的双重开销。

16. native 层怎么调用 ArkTS/系统能力?

反向调用走 tsfn 把请求抛回 JS 线程执行,结果经异步任务带回。设计上尽量单向:native 只做计算,系统交互留在 ArkTS 层,避免双向依赖成环。

17. 多个 NAPI 模块之间能共享 native 代码吗?

可以,公共逻辑编译成独立 so,模块间链接共享;注意符号冲突(fvisibility 控制)与 libc++_shared 唯一性。

18. 性能敏感模块怎么防「跨语言频繁小调用」?

批处理接口设计(一次调用处理一批数据)、对象池减少边界分配、将循环整体下沉(在 native 里循环,而不是 ArkTS 循环里每次调 native)。这条是「设计题」的核心答案。

19. NAPI 模块的版本兼容策略?

接口用 napi_get_version 探测能力;新接口提供 ArkTS 侧降级实现;so 按设备架构分发并用 CI 矩阵覆盖多设备真机测试。

20. 给你一个「ArkTS 实现的图像滤镜,性能不达标」的案例,答题框架?

先测量(Profiler 定位热点:像素循环?内存分配?)→ 评估下沉收益(计算占比 vs 边界开销)→ 设计接口(整帧进、整帧出,Uint8Array 零拷贝,异步执行 + 进度通知)→ 建立性能回归基线防退化。有测量、有方案、有验证闭环,就是满分结构。

标签

#鸿蒙面试#NAPI#原生开发#性能优化

跨端开发 20 问:Flutter 三棵树、RN 新架构与选型论证

跨端开发 20 问:Flutter 三棵树、RN 新架构与选型论证
关键词跨端面试、Flutter 三棵树、RN 新架构、KMP、ArkUI-X、跨端选型

跨端开发面试的本质是选型论证:面试官想看的是你有没有「按约束做决策」的能力,而不是背一遍框架列表。这份 20 问覆盖渲染原理、方案对比、工程实践三个层面——先把原理问清楚,再谈怎么选。

一、渲染原理(6 问)

1. Flutter 为什么能跨端保持一致渲染?

自带渲染引擎(Impeller/Skia)完整接管 UI 绘制,不依赖平台控件,用同一个渲染管线在所有平台画一样的像素。代价:包体自带引擎、无障碍/系统字体等平台能力要走桥接。

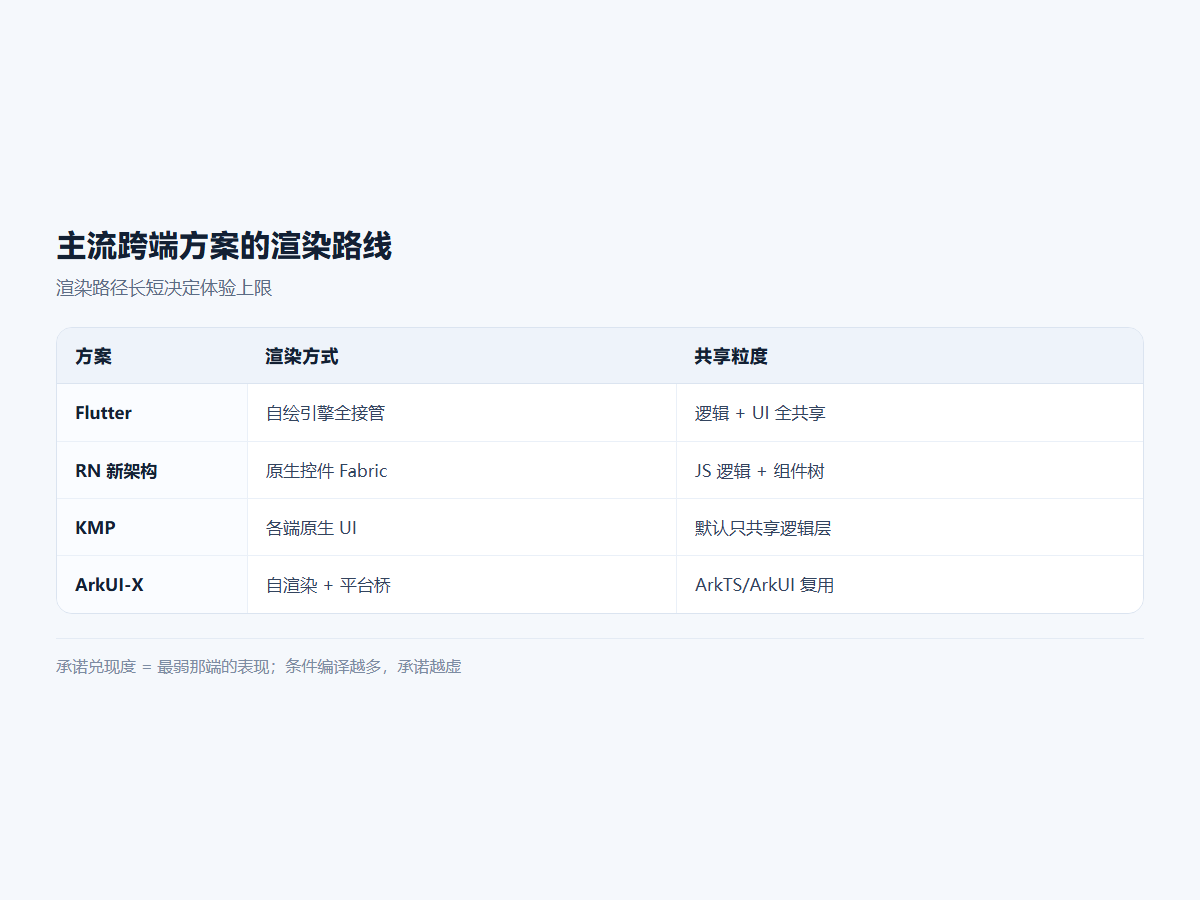
2. Flutter 的三棵树是什么?

Widget(不可变配置)、Element(实例与生命周期,持有复用关系)、RenderObject(布局与绘制)。Widget 重建很廉价(只是配置对象),真正昂贵的是 RenderObject 重建——这是「const 优化」的理论基础。

3. React Native 新架构解决了什么?

旧架构的异步桥序列化开销大;新架构(JSI + Fabric + TurboModules)让 JS 与原生直接同步调用,UI 管理由 Fabric 统一,原生模块按需懒加载。答题要点:JSI 是同步、无序列化的直接调用通道。

4. WebView H5 与原生容器方案的本质差异?

WebView 方案所有渲染走浏览器引擎,桥接是「JS ↔ 原生」的消息通道;原生容器方案渲染与逻辑都在原生/自绘管线里。体验差距的根源在渲染路径长短与线程模型。

5. KMP(Kotlin Multiplatform)的定位与其他方案的差别?

KMP 默认只共享逻辑层(网络、存储、业务规则),UI 各端原生写;配合 Compose Multiplatform 才共享 UI。它不是「一套代码全端跑」,而是「按层选择共享粒度」——这是它面试里最大的加分认知。

6. HarmonyOS ArkUI-X 的跨端机制?

ArkTS/ArkUI 代码复用到 iOS/Android,同样走「框架自渲染 + 平台桥接」路线。对国内团队的意义:鸿蒙优先的应用可以以鸿蒙工程为主干,跨出双端。以官方文档的最新支持矩阵为准。

主流跨端方案的渲染路线

二、方案对比与选型(7 问)

7. Flutter 与 RN 怎么选?

一致性体验与复杂动效优先 → Flutter(自绘一致性最好);团队 React 栈、需要热更新与 Web 生态 → RN。动态更新能力在国内的合规现状是必问的追问点。

8. KMP 与 Flutter 能共存吗?

能:KMP 共享业务逻辑层,Flutter 只做 UI 壳,通过 Kotlin/Native 或 FFI 桥接。适合已有 KMP 基础设施又想要自绘 UI 的团队,但复杂度高,中小团队不建议。

9. 「一套代码跑所有端」的承诺怎么评估?

看三个清单:目标端能力覆盖度(小程序/鸿蒙支持?)、条件编译比例(代码里 if (platform) 越多承诺越虚)、双端体验下限。承诺兑现度 = 最弱那端的表现。

10. 小程序跨端框架(Taro/uni-app)的运行时成本?

编译时方案产物接近原生小程序(体积小、兼容性好);运行时方案(如在小程序里模拟 DOM/BOM 跑 React)灵活但多一层开销。新项目优先编译时。

11. 什么场景坚决不要跨端?

强平台特性(系统级动画、繁重原生 API)、性能极限场景(大型游戏、实时图形)、单端业务却背上跨端复杂度。答出「跨端是成本换覆盖,不覆盖就不该付成本」。

12. 跨端方案的团队技能迁移成本怎么评估?

看语言亲和(React 栈 → RN,移动端 Kotlin 栈 → KMP/Compose MP,Web 全栈 → Flutter 学习曲线最平缓的是 Dart 类 JS 语法)与原生深度需求(需要写多少原生插件)。

13. 多端灰度与发布节奏怎么统一?

跨端不等于同步发布:各端审核节奏不同,需按端独立灰度;业务功能开关下沉到服务端配置,让「代码已发但功能未开」成为常态。

三、工程实践(7 问)

14. 原生插件/桥接的开发要点?

接口最小化(桥上只传数据不传行为)、异步优先(避免阻塞 UI 线程)、错误码规范、版本兼容(原生 API 降级路径)。桥是跨端方案里最容易出事故的层。

15. 跨端状态管理与数据同步?

逻辑层共享时状态放共享层(KMP 的 ViewModel、Flutter 的 Riverpod/Bloc),UI 层各端绑定;禁止 UI 层各自维护一份业务状态副本。

16. 跨端 UI 的一致性怎么验收?

设计 token 统一(颜色/间距/字号集中定义)、截图对比自动化(各端跑同一页面 diff)、设计评审时按端过稿。

17. 跨端项目的 CI/CD 有什么不同?

多端构建矩阵(iOS 签名/Android/小程序/鸿蒙)、产物分发到各自渠道、版本对齐管理(公共层版本 ↔ 各端壳版本)。加分点:提到「壳版本与业务包版本解耦」。

18. 混合栈(原生 + 跨端页面混排)的关键问题?

页面栈统一(跨端容器作为原生路由的叶子)、内存与生命周期对齐、预加载与回收策略(容器预初始化,进退场不白屏)。

19. 跨端的性能监控怎么做?

分端采集(各自的启动/崩溃/帧率)+ 统一业务维度聚合;共享逻辑层的性能问题要在逻辑层埋点才能定位,不能只看端侧指标。

20. 让你为一个「已有双端原生 App 的团队」引入跨端,怎么答?

先问动机(降本?新业务提效?鸿蒙补充?),再给渐进路线:新业务模块用跨端做(风险隔离)→ 建立桥接与发布基建 → 逐步替换低频页面 → 原生保留核心体验页。这问考察「渐进迁移」思维,答「全量重写」基本出局。

标签

#跨端开发#Flutter#React Native#面试题

移动端性能优化 25 问:启动、内存、流畅性与包体积

移动端性能优化 25 问:启动、内存、流畅性与包体积
关键词移动性能面试、启动优化、内存泄漏、掉帧、包体积、弱网优化

移动端性能优化的面试越来越像「开放设计题」:面试官抛出「启动慢怎么办」「掉帧怎么排查」,考察的是方法论与工具链的完整度。这份 25 问按启动、内存、渲染流畅性、包体积与网络五个板块组织,双端(Android 17 / iOS 27 时代)通用思路为主,平台差异单独标注。

一、启动优化(6 问)

1. 启动阶段怎么划分?各阶段优化重点?

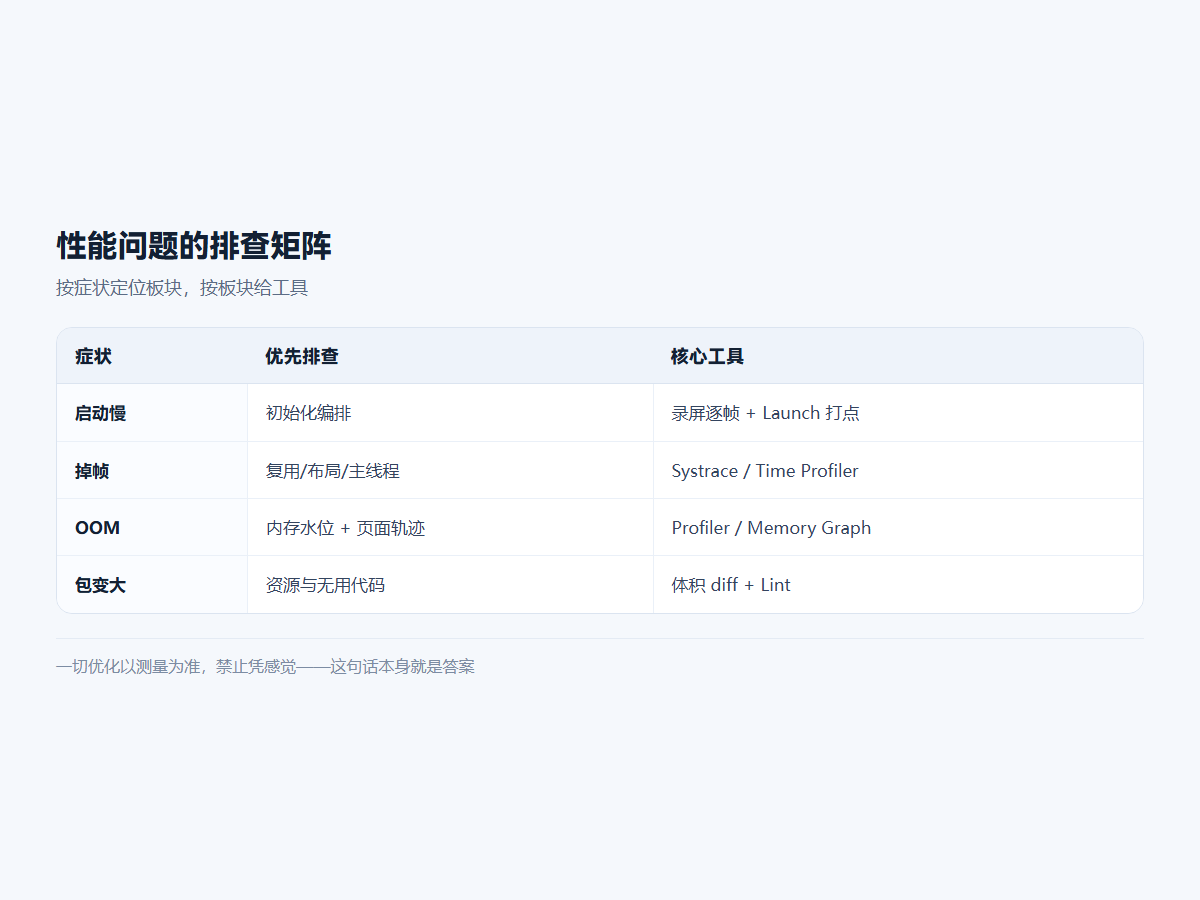
冷启动 = 进程创建 → Application 初始化 → 首帧渲染 → 首屏可交互。重点依次是:延迟非必要初始化(启动任务编排,按依赖分阶段)、首屏布局简化(减少嵌套层级)、数据预取(splash 期间并行请求)。

2. Application 里最容易犯的错?

同步初始化一堆 SDK。答案框架:把初始化拆成「启动必需 / 首帧前 / 异步可延迟」三档,用有向无环图管理依赖,异步档丢到首帧后的空闲期。iOS 对应 +load 与 didFinishLaunching 的瘦身。

3. 怎么测量启动耗时才准确?

双口径:实验室(录屏逐帧分析 / 打点日志)与线上 RUM(首帧时间 p75/p90)。加分点:说明「点击图标到首帧」与「首帧到可交互」要分开看,用户感知的是后者。

4. 首屏数据还没回来怎么办?

缓存兜底(上次数据的快照先渲染)+ 骨架屏 + 增量刷新。「先展示旧数据」比「白等新数据」体验好得多。

5. 启动优化到什么程度算到头?

看收益曲线:优化收益递减时转投入下一阶段。给出基准:冷启动 p75 控制在 1.5–2s 内(中端机型)是当前主流标准。

6. 多进程应用(Android)启动有什么特殊问题?

每个进程都会走一遍 Application 初始化——按进程名区分初始化内容,非主进程只做最小初始化。

性能问题的排查矩阵

二、内存优化(6 问)

7. 内存优化的指标怎么看?

PSS/内存水位(Android)、footprint(iOS);更关键的是「高水位设备占比」与 OOM 率。OOM 不抛常规异常,靠内存曲线 + 页面轨迹归因。

8. 图片内存怎么治理?

按显示尺寸解码(下采样)、合理格式(HEIC/WebP)、列表图片复用与按需取消解码、大图禁止常驻内存。图片通常占 App 内存一半以上。

9. 内存泄漏的高发点与排查工具?

静态持有 Activity/View、监听器未注销、Handler 延迟消息、闭包循环引用(iOS 的 delegate/Block)。工具:Android Profiler + LeakCanary、Xcode Memory Graph + Instruments Leaks。

10. 循环引用什么时候需要弱引用?

两个对象互相强持有即成环。规则:delegate 用 weak;Block 捕获 self 时要么 weak-strong dance,要么确保 Block 生命周期短于 self。

11. 大对象缓存怎么设计?

LRU + 容量上限 + 按内存压力降级(onTrimMemory / didReceiveMemoryWarning 时清缓存)。答出「缓存要有清空策略」即合格。

12. 内存抖动为什么危险?

短生命周期对象高频创建回收 → GC 频繁 → 停顿 → 掉帧。对策:对象池、复用、避免在 onDraw/绘制回调里分配对象。

三、渲染流畅性(6 问)

13. 掉帧的判定标准与测量?

Android:Janky frames 比例 + Choreographer 打点;iOS:CADisplayLink 监测或 MetricKit 的 hang rate。目标 60fps 下每帧 16.7ms、高刷屏 8.3ms。

14. 列表卡顿的排查路径?

复用是否生效 → 单 item 布局层级与过度绘制 → 绑定里是否做 IO/计算 → 图片解码是否在主线程。逐项排除,工具(Systrace/Instruments Time Profiler)验证。

15. 过度绘制是什么?怎么解决?

同一像素被绘制多次。解决:去掉多余背景、merge 布局减少嵌套、ViewStub 延迟加载。Android 开发者选项里可直接可视化。

16. 动画为什么掉帧?怎么保证流畅?

主线程被占 → 帧没画出来。原则:动画属性用 transform/opacity(走合成层不重排),复杂动画交由系统(属性动画/核心动画),JS/逻辑移出主线程。

17. 什么情况需要自绘?自绘的性能代价?

复杂交互组件(图表、编辑器)用自绘绕过布局系统。代价:全部渲染逻辑自己负责,要精细控制脏区与绘制频率。

18. 首帧渲染的布局优化原则?

减少层级(ConstraintLayout/组合优先)、异步 inflate/预渲染、避免首帧触发大范围 measure。

四、包体积与网络(7 问)

19. 包体积优化的系统方法?

三步:资产清理(无用资源/Lint)、代码瘦身(混淆/裁剪无用架构 slice)、资源压缩(图片 WebP、资源着色替代多套图、按需下发动态 feature)。

20. 怎么防体积回涨?

体积预算进 CI:diff 超阈值阻断合并,大文件白名单管理。机制比运动式清理有效。

21. 动态化能力(动态 feature/热修)的取舍?

按需下发减少首包,但增加复杂度与审核风险(iOS 受限)。答题要点:核心路径保持静态,长尾功能动态化。

22. 网络优化的常规手段?

HTTP/2 或 QUIC(HTTP/3)多路复用、连接复用与预建连、DNS 缓存/HTTPDNS、请求合并与缓存、弱网降级策略。

23. 弱网环境怎么保障体验?

超时分级 + 快速失败 + 明确的重试与缓存兜底;关键操作同步、非关键异步排队。加分点:提到网络质量探测(RTT 分档)驱动策略切换。

24. 电量优化的关注点?

批量合并网络请求与定位、WakeLock 用完即放、后台任务用系统调度(WorkManager/BGTaskScheduler)代替自轮询。

25. 性能优化的兜底方法论?

测量 → 归因 → 优化 → 验证 → 门禁防回退。强调「一切优化以测量为准,禁止凭感觉」——这句话本身就是面试官想听的答案。

标签

#移动端面试#性能优化#启动优化#内存优化

微服务 25 问:拆分边界、运行时治理与数据架构

微服务 25 问:拆分边界、运行时治理与数据架构
关键词微服务面试、服务拆分、服务治理、熔断降级、灰度发布、CQRS

微服务面试的陷阱在于:背得出「拆分原则、注册发现、熔断限流」这些名词,却答不好「为什么这么拆、拆错了怎么办」。这份 25 问按治理生命周期组织——从拆分、通信,到运行时治理,最后到数据架构,每问给出答题骨架。

一、拆分与边界(6 问)

1. 微服务拆分的依据是什么?

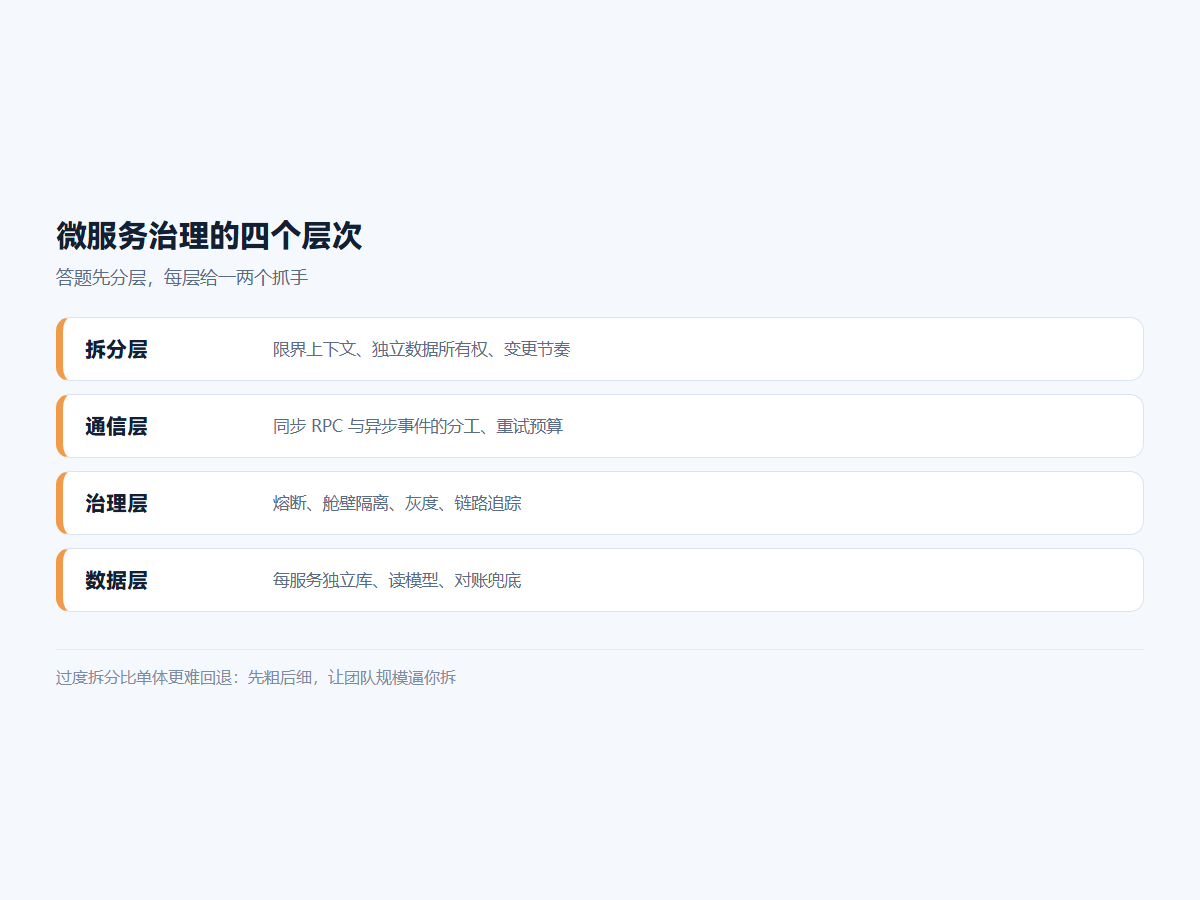
围绕业务能力(限界上下文)拆,而不是按技术层拆。可操作的判据:独立的数据所有权、独立的变更节奏、独立的扩缩容需求。三者满足两条才值得拆。

2. 服务拆太细有什么代价?

分布式事务、网络开销、运维复杂度、排查难度全部上升。面试观点:先拆「粗粒度的服务」,等团队规模和变更节奏逼你再拆——过度拆分比单体更难回退。

3. 什么是康威定律对架构的影响?

系统结构会趋同于组织沟通结构。想拆出清晰的服务边界,先让团队边界清晰(一个服务一个 owner)。这问考察架构的社会学视角。

4. 什么情况下应该回退到单体?

团队小(< 10 人)、业务早期边界不明、运维能力不足。Modular Monolith(模块化单体)+ 后续按模块拆出,是更稳的路径。

5. 服务间怎么避免「隐式耦合」?

共享数据库是最大的反模式;契约先行(OpenAPI/protobuf);只通过接口交互,禁止绕过服务直连它的存储。

6. API 版本化策略?

向后兼容优先(加字段不删字段);破坏性变更走新版本(URL/Header 版本)+ 双跑期 + 下线公告。加分点:提到消费者驱动契约测试。

微服务治理的四个层次

二、通信与发现(6 问)

7. 同步 RPC 与异步消息怎么选?

需要立即得到结果的读操作用 RPC;状态变更、事件广播、削峰用消息。原则:能用事件解耦的不要用同步调用串起来。

8. 服务注册与发现的完整流程?

服务启动注册(心跳续期)→ 注册中心(Nacos/Consul/ETCD)→ 消费方订阅推送变更 → 客户端负载均衡。加分点:说明注册中心挂了服务仍可靠本地缓存运行——注册中心是「最终一致的路由表」不是关键路径。

9. 负载均衡策略有哪些?怎么选?

轮询/加权轮询(静态均衡)、最少连接/最少 RT(动态)、一致性哈希(会话亲和)。有状态或缓存场景用哈希,普通服务用动态策略。

10. 重试的正确姿势?

只重试幂等操作;指数退避 + 抖动;重试预算(如重试不超过总请求 10%)防重试风暴;超时要逐层递减。

11. 网关在微服务架构里的位置与职责?

统一入口:鉴权、限流、路由、灰度、协议转换。原则是「薄网关」——业务逻辑下沉到服务,编排型 BFF 单独成层。

12. 消息丢失与重复怎么处理?

丢失:生产确认 + 持久化 + 消费手动 ack 三段保证;重复:消费端幂等(唯一键/状态机)。「至少一次投递 + 消费幂等」是标准组合拳。

三、运行时治理(7 问)

13. 配置中心解决什么问题?动态配置的边界?

环境隔离、版本回滚、灰度发布、动态调参(限流阈值/开关)。边界:敏感信息走密钥管理,不适合「明文塞配置中心」。

14. 熔断器的三态模型?

关闭(正常)→ 打开(错误率/慢调用超阈值,直接失败)→ 半开(放少量探测流量)→ 恢复关闭。加分点:熔断维度是「依赖 + 方法」级,不是服务级一刀切。

15. 舱壁隔离是什么?

把资源(线程池/信号量/连接池)按依赖隔离,一个下游挂掉不占光全局资源。它是雪崩传导的物理隔断。

16. 灰度发布的完整链路?

流量标记 → 网关按规则路由到灰度实例 → 数据兼容(新旧版本同库共存)→ 监控对比 → 全量。难点在数据结构变更的双写迁移。

17. 分布式链路追踪的关键设计?

TraceID 全链路透传、Span 记录父子关系与耗时、采样策略(头部采样保成本、尾部采样保问题请求)。OpenTelemetry 是当前事实标准。

18. 服务的健康检查怎么做才可靠?

存活探针(进程在不在)与就绪探针(能不能干活)分开;就绪检查要覆盖真实依赖(DB 连接池可用),否则流量会打到「活着但干不了活」的实例。

19. 服务优雅上下线怎么做?

上线:先注册后放流量(预热期低权重);下线:先摘流量 → 等在途请求完成 → 再停进程。MQ 消费者下线要等本地队列消费完。

四、数据架构(6 问)

20. 「每个服务自己的数据库」怎么落地?

物理上独立 schema/实例,跨服务数据获取走 API 或事件同步的本地副本(读模型)。禁止跨库 JOIN——需要 JOIN 说明边界拆错了。

21. 跨服务查询(列表页要聚合多服务数据)怎么办?

CQRS:事件驱动的读模型/物化视图,查询侧冗余聚合;或 BFF 编排聚合(实时但链路长)。高频查询场景选读模型。

22. 分布式事务在微服务里的默认选择?

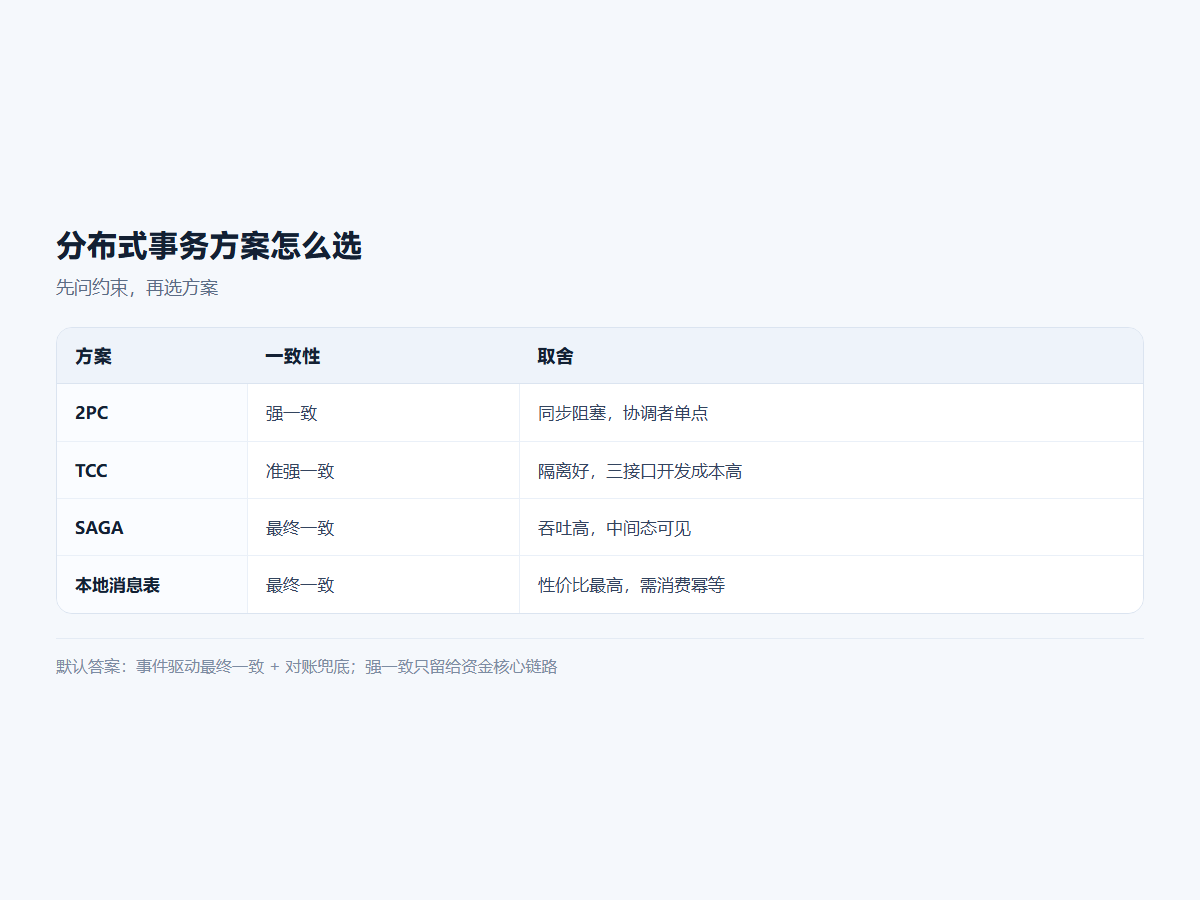
事件驱动的最终一致(本地消息表/事务消息 + 消费幂等 + 对账兜底)。强一致只在资金核心链路用 TCC。参考分布式事务专篇的对比表。

23. 数据库变更怎么跨服务协调?

演进式设计:兼容式变更(加列不删列)→ 双写 → 切读 → 清理,每步可回滚。配合 Flyway/Liquibase 版本化管理 schema。

24. 事件设计的版本化怎么处理?

事件是长期契约:只加字段不改语义;大版本变更发新 topic 双跑迁移;消费方对未知字段必须容忍(向前兼容)。

25. 微服务架构下怎么做容量规划?

按链路模型推每层 QPS → 单服务压测拿单机水位 → 计算实例数与中间件配额 → 全链路压测验证。可展开讲影子库与预案演练,体现完整方法论。

标签

#微服务#后端面试#服务治理#架构设计

分布式系统 25 问:CAP、共识协议与分布式事务选型

分布式系统 25 问:CAP、共识协议与分布式事务选型
关键词分布式面试、CAP 定理、Raft、TCC、SAGA、分布式锁、幂等

分布式系统面试的考察点很明确:你能不能在「理论」与「工程妥协」之间给出有依据的选择。这份 25 问覆盖一致性理论、共识协议、分布式事务、幂等与锁四个板块,每问给出答题骨架与加分点。

一、理论基石(6 问)

1. 用一句话说清 CAP,并说明它在工程上的正确用法。

网络分区发生时,一致性与可用性只能选一个。工程正确用法:P 是必然存在的(不是选项),真正在选择的是「分区时的行为」——计费/库存选 CP(拒绝服务),社交 feed 选 AP(容忍暂时不一致)。加分点:指出同系统不同子系统可以分别取 CP/AP。

2. BASE 是什么?与 ACID 的关系?

基本可用、软状态、最终一致——AP 路线的工程化表达。不是放弃一致性,而是把「强一致」换成「可观测的收敛时间」。

3. 线性一致性与顺序一致性的区别?

线性一致:操作有全局全序且尊重实时顺序(最强,代价最高);顺序一致:保持各客户端的操作序,但不要求实时性。Redis 主从、ETCD 的读语义差异常被拿来追问。

4. 什么是读己之写与单调读?为什么重要?

读己之写:自己写入后自己能读到(会话黏住主副本/读你刚写的节点);单调读:不会出现「读回退」(会话内固定副本)。这是 AP 系统用户体验的底线保障。

5. Quorum 怎么推导?W+R>N 说明了什么?

N 副本、写 W 份、读 R 份,W+R>N 保证读写集合有交集,读能拿到最新写入。加分点:N=3, W=2, R=2 是常见取舍,并说明这不是完整的事务语义。

6. Raft 的核心机制三句话?

领导者选举(任期 + 多数派投票)、日志复制(Leader 追加并同步,多数派确认才提交)、安全性(日志匹配特性保证已提交日志不被覆盖)。能画图讲清「提交边界」就是满分答案。

分布式事务方案怎么选

二、分布式事务(8 问)

7. 2PC 的两个阶段与致命缺陷?

准备(锁资源并投票)+ 提交/回滚。缺陷:协调者单点(它挂了参与者锁死)、同步阻塞、网络分区下可能数据不一致。适合短事务、高可靠的内部场景。

8. 3PC 改进了什么?为什么还是不够?

加 CanCommit 阶段与超时机制,降低阻塞;但网络分区下仍可能两阶段各自推进,出现脑裂不一致——所以生产上很少用 3PC。

9. TCC 的三个阶段?空回滚与悬挂怎么处理?

Try 预留资源、Confirm 确认、Cancel 释放。空回滚:Cancel 先于 Try 到达(事务 ID 查无 Try 记录则直接返回成功并落「回滚标记」);悬挂:Try 在 Cancel 之后到达(看到回滚标记拒绝执行)。这是 TCC 面试的必考细节。

10. SAGA 与 TCC 的取舍?

SAGA 是长事务拆成一串本地事务 + 逆序补偿,不锁资源、吞吐高,但无隔离性(中间态可见);TCC 隔离性好但每个参与方都要写三个接口。资源紧张选 TCC,链路长、吞吐优先选 SAGA。

11. 本地消息表的原理与前提?

业务数据与消息记录在同一个本地事务落库,异步投递 + 对账重试。前提:消费方幂等。它把「分布式事务」降维成「本地事务 + 可靠投递」,是性价比最高的方案。

12. 事务消息(RocketMQ 类)与本地消息表的区别?

半消息机制由 MQ 承担重试与回查,省掉本地表,但强绑特定 MQ;本地消息表通用但多一张表与扫描任务。加分点:两者都需要「消息可查、消费幂等」。

13. 最大努力通知是什么?

适用于对时效不敏感的通知场景(支付结果通知商户):按衰减间隔重试 N 次 + 提供查询对账接口兜底。

14. 给「下单扣库存」设计一致性方案,你怎么答?

先问约束(能不能超卖?能不能少卖?链路多长?),再选型:库存强内聚用 DB 乐观锁/原子扣减;跨服务用「本地消息表 + 补偿」;秒杀场景用「Redis 预扣 + 异步落库 + 对账」。展示「先问约束再选方案」就是加分项。

三、幂等与锁(7 问)

15. 幂等的常用实现?

唯一索引/唯一约束(最硬)、状态机(只允许合法迁移)、token 机制(先取 token 再提交)、乐观锁版本号。答出「按操作类型选择,唯一键兜底」即可。

16. 分布式锁的实现对比?

Redis(SET NX PX + 唯一值 + Lua 释放):性能高,主从切换可能丢锁;RedLock:多数派部署,争议较大;ZooKeeper/ETCD(临时顺序节点 + watch):强一致但吞吐低。观点题:多数业务用 Redis 锁 + 兜底对账即可,资金级用 ETCD/数据库。

17. Redis 锁为什么要带唯一值并用 Lua 释放?

防止释放别人的锁(自己的锁已过期被他人持有)。Lua 保证「判断 + 删除」原子性。加分点:续期看门狗解决「业务没执行完锁先过期」。

18. 缓存与 DB 的一致性策略?

Cache Aside(更新 DB 后删缓存)是默认答案;追问会引到「先删后更的并发窗口」「延迟双删」「订阅 binlog 异步删(Canal 类)」。能画出并发时序图是关键加分。

19. 缓存三兄弟:穿透、击穿、雪崩的定义与对策?

穿透(查不存在的 key):空值缓存/布隆过滤器;击穿(热 key 过期):互斥重建/逻辑过期;雪崩(大量同时过期):过期时间加随机抖动 + 多级缓存。

20. 分布式 ID 方案对比?

UUID(无序,索引不友好)、号段模式(DB 批量取段)、雪花算法(时间戳 + 机器 ID,注意时钟回拨)。答出「趋势递增对 InnoDB 聚簇索引的意义」是加分点。

四、综合设计(5 问)

21. 分布式链路的 TraceID 怎么全链路透传?

入口生成 → Header/Context 透传 → 日志、MQ、线程池(需包装 Runnable)全带上下文。异步场景丢上下文是最常见 bug。

22. 时钟不一致会引发什么问题?怎么缓解?

事件序错乱(下单时间晚于支付时间)。缓解:NTP 消偏 + 业务上用单调递增序列号而非墙钟;跨地域一致性用混合逻辑时钟(HLC)或真时钟(TrueTime 类)。

23. 服务雪崩的传导路径与断路点?

慢调用占满线程池 → 上游超时堆积 → 级联拖垮。断路点:每层独立超时(小于下游超时)、线程池/信号量隔离、熔断降级、重试必须带退避 + 预算。

24. 最终一致的对账系统怎么设计?

定时全量对账 + 实时增量对账,差异记录进「差错池」,自动修复(可重放的操作)与人工审核(资金类)分流。对账是最终一致架构的安全网,面试提它就说明有实战视角。

25. 让你设计一个秒杀系统,答题框架?

分层削峰:前端限流与答题 → 网关令牌桶 → Redis 原子预扣(Lua)→ MQ 异步下单 → DB 兜底幂等消费。强调三个原则:库存不超卖(原子扣)、请求层层递减、失败路径体验友好(排队页/兜底页)。这问考的是分层思维,不是单点技术。

标签

#分布式系统#后端面试#分布式事务#Raft

TypeScript 25 问:从 any/unknown 到类型体操与 TS 7

TypeScript 25 问:从 any/unknown 到类型体操与 TS 7
关键词TypeScript 面试、泛型、条件类型、infer、类型体操、TS7 原生编译器

TypeScript 面试正在从「会不会用」升级为「类型系统理解多深」——尤其在 TypeScript 7 原生编译器(Go 实现,当前 7.0.2)落地的背景下,语言层知识比以往更值钱。这份 25 问覆盖类型基础、类型编程、工程配置三个梯度,每问给出简明答案与加分点。

一、类型基础(8 问)

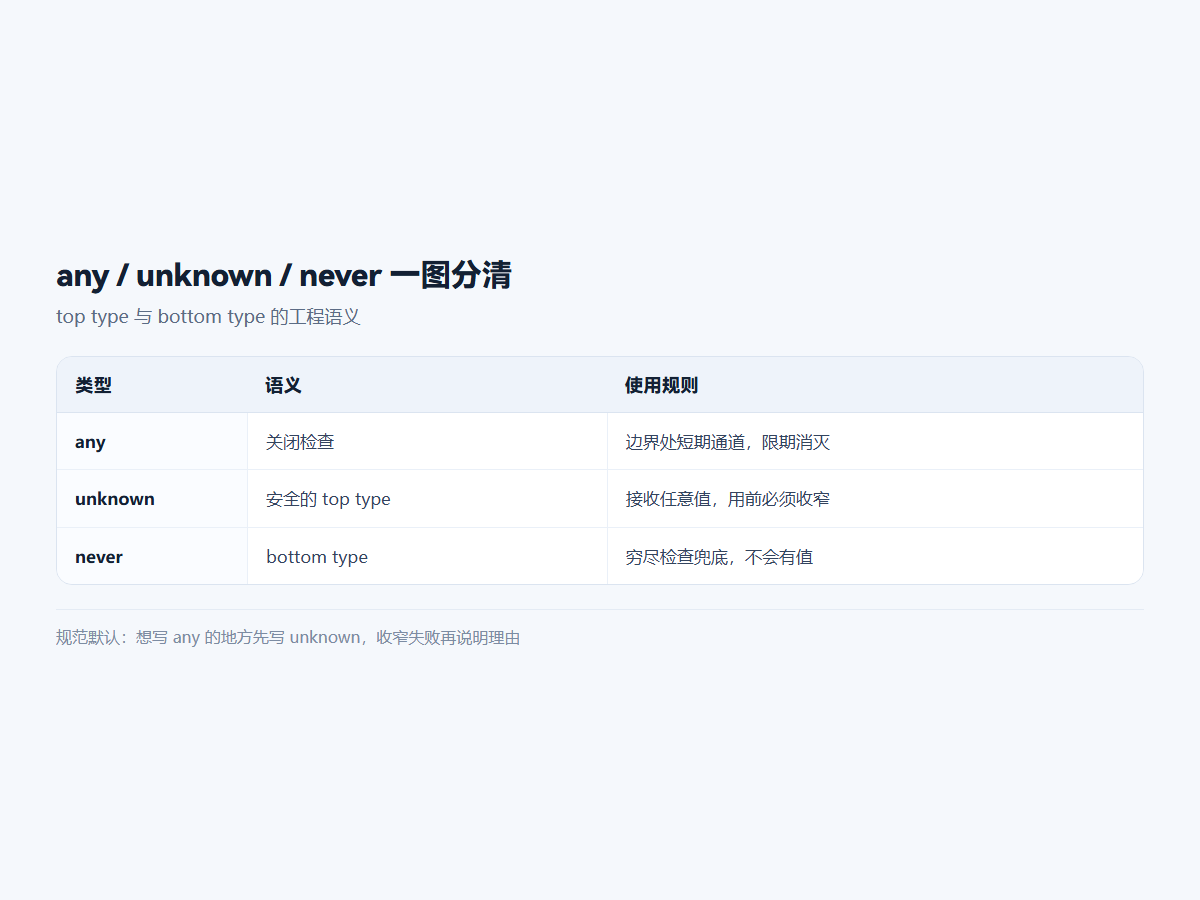
1. any 与 unknown 的区别?

any 关闭类型检查,可以赋给任何类型、调用任何方法;unknown 是「安全的 top type」——可以接收任何值,但使用前必须收窄。工程规范:任何想写 any 的地方先考虑 unknown。

2. never 的用途?

表示「不会有值」:抛错函数的返回值、穷尽检查的兜底分支(const _x: never = value 在联合类型扩展时编译报错,强制处理新分支)。

3. type 与 interface 怎么选?

两者大部分场景可互换。差异:interface 可声明合并、可 extends;type 支持联合、条件类型、映射等类型编程。惯例:对象形状用 interface,其余一律 type。

4. 枚举的问题是什么?替代方案?

运行时对象 + 数字枚举的双向映射有陷阱,const enum 在隔离模块编译下受限。主流替代:as const 对象 + 联合类型推导。

const STATUS = { active: "active", archived: "archived" } as const;
type Status = typeof STATUS[keyof typeof STATUS]; // "active" | "archived"

5. 可辨识联合是什么?为什么推荐?

用字面量成员(如 kind: "circle")区分联合分支,switch 自动收窄。它把「合法状态」编码进类型,配合 never 穷尽检查消灭漏分支。

6. 类型收窄有哪些手段?

typeof/instanceof、in 操作符、相等判断、谓词函数(value is T)、断言函数(asserts value is T)。加分点:说明 TS 的窄化基于控制流分析,跨异步边界会失效(回调里需要重新校验)。

7. 泛型的「分配律」陷阱是什么?

条件类型对裸类型参数是分布式求值:T extends U ? X : Y 作用在联合类型时会逐成员计算。想跳过分布用 [T] extends [U]

8. readonly 数组与 const 的区别?

const 锁绑定(引用不可换),readonly 锁内容(元素不可改)。ReadonlyArray<T> / as const 是构建不可变数据流的基础。

any / unknown / never 一图分清

二、类型编程(10 问)

9. Partial/Required/Pick/Omit 的实现原理?

全是映射类型:Partial<T> = { [K in keyof T]?: T[K] };Omit 借助 Exclude:{ [K in Exclude<keyof T, U>]: T[K] }。能手写这四个是类型编程的入场券。

10. infer 怎么用?举例。

在条件类型中「声明一个待推断变量」:type Unwrap<T> = T extends Promise<infer V> ? V : T。常见于提取数组元素、函数返回值(ReturnType 的实现)。

11. 写一个 DeepPartial。

type DeepPartial<T> = T extends object
  ? { [K in keyof T]?: DeepPartial<T[K]> }
  : T;

加分点:注意数组与函数的处理边界(先排除 function 再递归,或对数组映射为 DeepPartial<元素>[])。

12. Exclude 与 Extract 的原理?

基于分布式条件类型:Exclude<T, U> = T extends U ? never : T。联合类型进、联合类型出。

13. 模板字面量类型能做什么?

字符串级的类型运算:路由模式解析(`/user/${infer Id}`)、事件名推导、CSS 单位约束。配合映射类型可实现「字段名改造」(如 getter 前缀)。

14. satisfies 关键字解决什么问题?

「校验但不拓宽」:const config = {...} satisfies Config 既保证符合 Config,又保留每个字面量的精确类型(as 断言会丢失收窄)。TS 4.9 引入,现代代码里应优先于带类型的 const 声明。

15. 协变与逆变体现在哪?

对象属性协变(子类型可以赋给父类型位置),函数参数逆变(参数要求父类型的位置不能传要求子类型的函数)。strictFunctionTypes 开启后参数才严格逆变。

16. 函数重载怎么写?实现签名为什么不暴露?

多个重载签名 + 一个实现签名;实现签名只用于内部兼容,对外不可见,调用方只能匹配重载签名——这保证了调用侧类型的精确性。

17. 声明合并与模块增强的场景?

给第三方库补类型:declare module "lib" { interface Options { debug?: boolean } }。加分点:提醒声明合并是双刃剑,滥用会让类型「来源不可考」。

18. 装饰器与 TS 7 的关系?

TS 7(原生编译器)以 ECMAScript 标准装饰器为准,旧实验性装饰器语义不保证兼容——存量代码迁移 TS 7 时这是重点检查项之一(详见 TypeScript 官方仓库的迁移说明)。

三、工程配置(7 问)

19. strict 模式包含哪些关键项?

strictNullChecks(可空性)、noImplicitAny(隐式 any 报错)、strictFunctionTypes、strictBindCallApply、alwaysStrict 等。面试观点:新项目全开,存量项目从 strictNullChecks 开始逐项开启。

20. skipLibCheck 为什么建议开?

跳过对 node_modules 内 .d.ts 的检查——第三方声明的错误不该阻塞你的构建,且检查它们耗时巨大。自己代码的检查不受影响。

21. isolatedModules 意味着什么?

每个文件必须能被独立转译(单文件视角类型可判定)。禁止跨文件的纯类型副作用,这也是与 esbuild/swc 类单文件编译器兼容的前提。

22. 项目引用(project references)解决什么?

monorepo 增量构建:拆成多个 tsconfig,依赖方只看被依赖方的 .d.ts,改一个包不必全量类型检查。配合 TS 7 原生编译器的并行能力,收益进一步放大。

23. 类型测试怎么写?

用类型断言「可赋值/不可赋值」测试工具类型:expectTypeOf(x).toEqualTypeOf<Expected>()(vitest)或 @ts-expect-error 标注预期的编译错误。类型也是代码,也要回归测试。

24. public_api 与内部类型的边界怎么管?

导出面最小化:包入口只 export 公共 API,内部类型用 /** @internal */ 标记并由 api-extractor 生成报告做破坏性变更检查。

25. 什么情况下「any 一次」是可接受的?

边界处的三方无类型数据(立即收窄)、原型验证期的临时通道——但必须集中、注释原因、限期消灭。这问实际考察的是对「类型系统是渐进的」这一设计哲学的理解。

标签

#TypeScript#前端面试#类型系统#面试题

前端性能优化 30 问:从指标口径到权衡决策

前端性能优化 30 问:从指标口径到权衡决策
关键词前端性能面试、性能优化 30 问、INP、LCP、虚拟列表、性能预算

性能优化是前端面试的必考题,但多数回答停留在「懒加载、压缩、CDN」的背诵层面。这份 30 问按面试官的真实追问路径组织:从指标口径,到加载/渲染/执行三个层面,再到权衡决策——每一问都给出「合格回答」与「加分回答」的差别。

一、指标与口径(6 问)

1. Core Web Vitals 是哪三个指标,阈值分别是多少?

LCP ≤ 2.5s、INP ≤ 200ms、CLS ≤ 0.1(p75 口径,见 web.dev)。加分点:主动说明 INP 于 2024 年 3 月取代 FID,且衡量的是所有交互的最差响应而非首个交互。

2. LCP 候选元素可能是哪些?

首屏最大的图片、背景图、video 首帧、文本块。加分点:知道 LCP 可能变化(更大元素出现会更新),以及 element.getBoundingClientRect 不可靠、要用 PerformanceObserver。

3. 为什么 INP 比 FID 严格?

FID 只测首个交互的输入延迟,INP 测整个生命周期内所有交互的最差情况,覆盖输入延迟 + 事件处理 + 渲染提交的完整链路。 hydrate 未完成时绑定的交互会在 INP 上现形。

4. TTFB 高说明什么?

服务端慢、网络链路差或 CDN 未命中。它是 LCP 的前置瓶颈——TTFB 占掉 1s,前端优化空间就被压缩一半。

5. 实验室数据与真实用户(RUM)数据的差异?

实验室可控可回归但设备/网络理想化;RUM 反映真实分布(看 p75 而不是均值)。生产决策以 RUM 为准,发布门禁用实验室。

6. 采样率怎么定?

头部页面高采样、长尾低采样;错误类全量、性能类按流量分级。关键是保证 p75 统计的样本量充足。
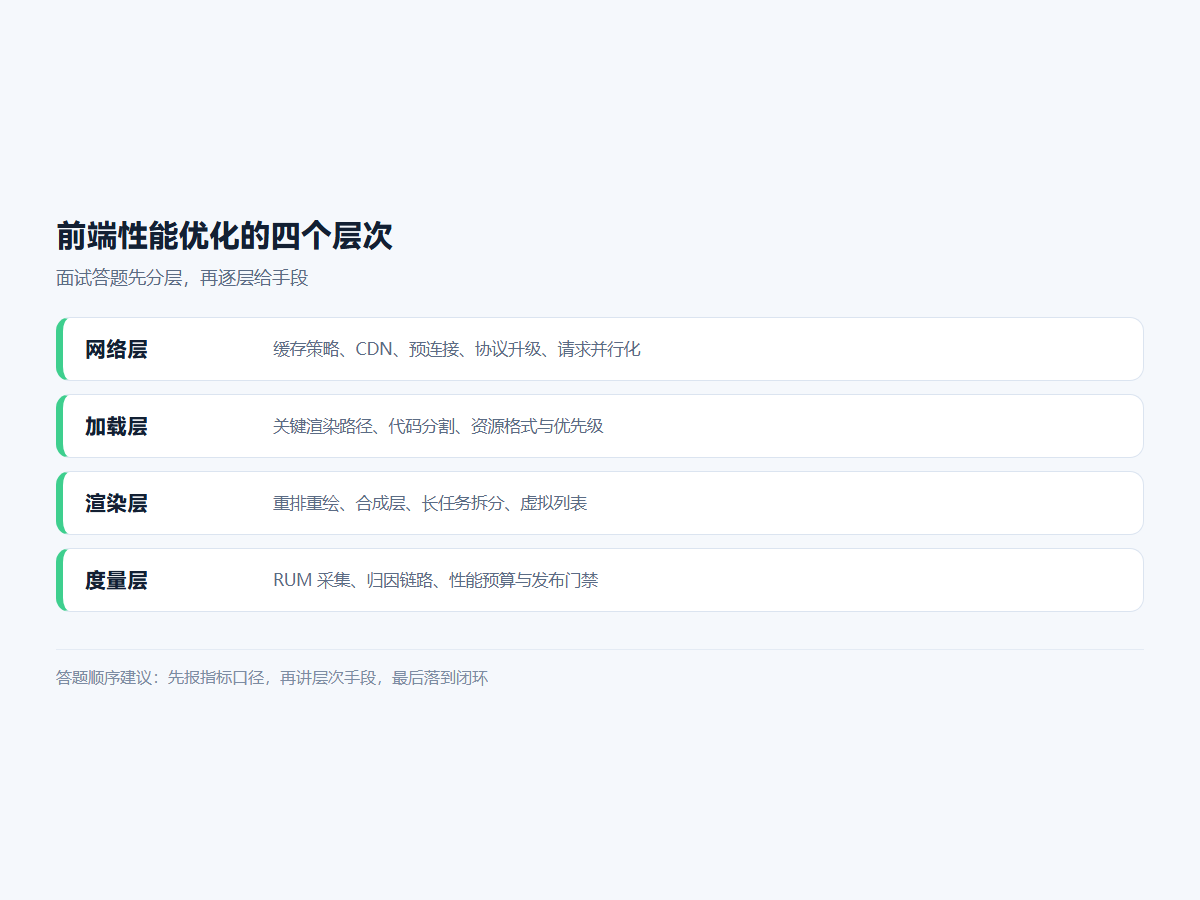
前端性能优化的四个层次

二、加载优化(9 问)

7. 关键渲染路径是什么?怎么压缩?

HTML → CSSOM → DOM → 渲染树 → 布局 → 绘制。压缩手段:CSS 内联关键样式、非关键 CSS 异步加载、JS 加 defer/async、减少阻塞资源。

8. script 的 defer 与 async 区别?

都不阻塞解析;defer 按序在 DOMContentLoaded 前执行,async 下载完立即执行顺序不定。有依赖用 defer,独立脚本用 async。

9. 图片优化的完整清单?

WebP/AVIF 格式、响应式 srcset + sizes、懒加载(loading="lazy")、首屏图 preload + fetchpriority=”high”、尺寸约束防 CLS。

10. 预加载家族怎么用?

dns-prefetch 提前解析、preconnect 建连、preload 当前页关键资源、prefetch 下一页资源、modulepreload 模块。加分点:说明 preload 滥用会浪费带宽并触发控制台告警。

11. 缓存策略怎么设计?

带 hash 的静态资源 Cache-Control: max-age=31536000, immutable;HTML 用 no-cache 协商缓存;接口按业务定(私有数据 no-store)。

12. 强缓存与协商缓存的触发条件?

强缓存命中不发请求(Expires/Cache-Control);协商缓存发请求验证(ETag/If-None-Match 或 Last-Modified/If-Modified-Since),304 返回空体。

13. CDN 命中率怎么优化?

URL 稳定化(hash 变化只影响变化的文件)、合理设置源站缓存头、预热热门资源、回源合并(coalescing)。

14. 首屏接口多且相互依赖怎么办?

服务端聚合(BFF 一次下发)、无依赖接口并行、下游数据 SSR 直出。核心思路:把「浏览器视角的瀑布」变成「服务端内网的并行」。

15. 骨架屏的价值与陷阱?

降低感知延迟、约束布局防 CLS;陷阱是骨架与真实内容布局不一致时反而增加跳动感。

三、渲染与执行优化(10 问)

16. 重排(reflow)与重绘(repaint)的区别与优化?

重排涉及几何计算,代价远高于重绘。批量修改(DocumentFragment、class 切换)、读写分离(避免交替读写布局属性)、transform/opacity 走合成层。

17. 什么是长任务?怎么处理?

> 50ms 的任务。拆分(切片 + scheduler.yield/setTimeout)、移入 Web Worker、延迟非关键逻辑。

18. requestIdleCallback 与 requestAnimationFrame 的分工?

rAF 在下一帧绘制前执行,适合动画;rIC 在空闲期执行,适合低优先级任务(有 timeout 兜底)。加分点:知道 Safari 长期不支持 rIC,可用 scheduler API 替代。

19. 虚拟列表的原理与边界情况?

只渲染可视区 + 缓冲区,用总高度占位 + transform 偏移。边界:不定高(需测量或预估校正)、快速滚动白屏(加大缓冲)、搜索定位(要索引)。

20. 防抖与节流的选择?

防抖合并停止后的最后一次(搜索输入),节流固定频率执行(滚动、拖拽)。加分点:能说出两者在「首触立即执行」变体上的实现差异。

21. JS 内存泄漏的常见来源与排查?

未清理的定时器/监听器、闭包持有大对象、脱离 DOM 的引用、无限增长的缓存。排查用 DevTools Memory 的堆快照对比。

22. Web Worker 的适用与不适用?

适用:纯计算(解析、加解密、大数据处理)。不适用:DOM 操作、需要频繁与主线程同步小数据的场景(通信开销反噬收益)。

23. 如何优化 INP?

定位最差交互 → 看事件处理器是否同步做重活 → 拆分/延迟非关键更新 → 输入后先做视觉反馈(如 optimism UI)再异步完成。

24. 字体加载闪烁(FOUT/FOIT)怎么处理?

font-display: swap + 字体子集化 + preload;对品牌字体可接受 swap,正文用系统字体栈兜底。

25. CSS 怎么防 CLS?

媒体元素预设宽高(aspect-ratio)、动态内容预留空间、避免在首屏上方插入内容、字体用 size-adjust 匹配。

四、工程与权衡(5 问)

26. 代码分割的粒度怎么定?

路由级必拆,组件级按「共享度 × 体积」拆:共享高体积大的拆,私有小组件不拆(避免请求碎片化)。

27. tree shaking 失效的常见原因?

sideEffects 未配置、CommonJS 混用、动态访问属性、babel 转译破坏 ESM 语法。

28. 性能预算怎么落地?

量化为硬指标(JS ≤ 200KB gzip、LCP ≤ 2.5s),写进 CI 门禁与 bundle 分析比对,超预算阻断合并。

29. 首屏优化已到极限,还差 300ms,去哪找?

按链路排查:TTFB(边缘缓存/SSR 流式)、关键资源数(内联合并)、渲染阻塞(CSS 拆分)、接口瀑布(预取并行)。加分点:先看 p75 分布定位是「普遍慢」还是「尾部慢」,策略完全不同。

30. 优化与可维护性冲突时怎么决策?

用数据说话:预估收益(影响多少 p75 用户)× 实现成本 × 维护成本,收益大的先做;「感觉会快」的优化默认不做。这一问考察的是工程判断力,没有标准答案。

标签

#前端面试#性能优化#Web Vitals#面试题

  • 1
  • 2
  • 7