如果问鸿蒙和其他移动系统最大的区别,答案只有一个:分布式。本文把软总线、应用流转、分布式 KV Store、安全等级、分布式硬件讲清楚,并给出跨设备应用的架构注意事项与调用失败的排查顺序。
关键词鸿蒙分布式、软总线、应用流转、分布式数据库、跨设备协同
如果问”鸿蒙和其他移动操作系统最大的区别是什么”,标准答案只有一个:分布式。Android 和 iOS 的生态是”设备各自为战”,鸿蒙从内核层就把”多设备协同”当成一等公民来设计。
这也是鸿蒙面试里最容易被问懵的一块——很多开发者只做过单设备应用,一遇到”分布式软总线””应用流转””跨设备数据同步”就答不上来。本文把这块的核心概念、实现方式和典型追问梳理清楚。
一、分布式软总线:理解一切的基础
Q1:什么是分布式软总线?
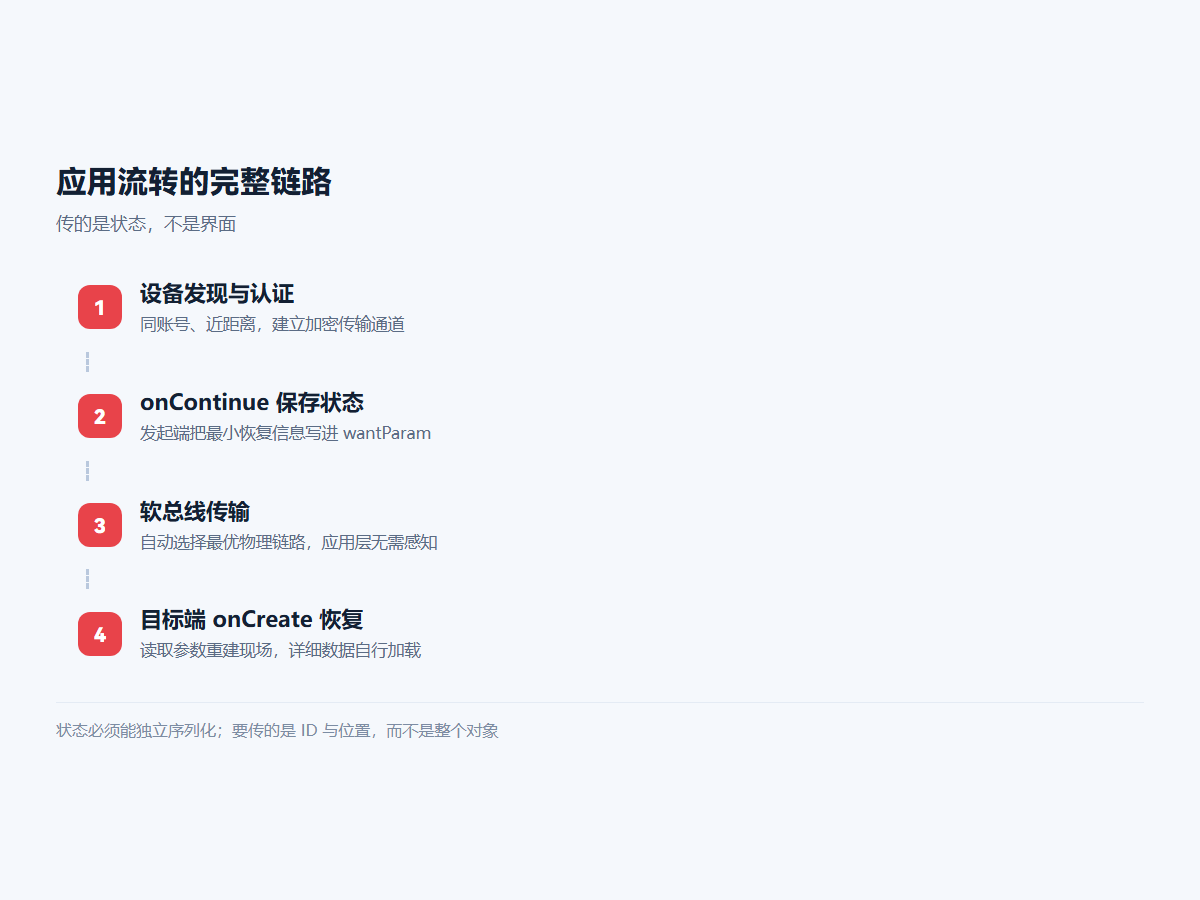
可以理解为把同一账号下、相互可信的多台设备,虚拟成一台”超级终端”。应用开发时不需要关心设备之间用的是 Wi-Fi、蓝牙还是 USB,软总线会自动完成设备发现、连接、组网和传输通道选择。
它解决的是三个具体问题:
- 发现:附近的设备如何互相感知(基于 Wi-Fi P2P、蓝牙等物理通道)。
- 连接:如何建立认证过的、安全的传输链路(设备间互信认证)。
- 通信:如何屏蔽底层链路差异,向上提供统一的传输接口。
高分表述:“软总线对应用层屏蔽了物理链路的差异,开发者调用的是’设备 A 到设备 B 的通信’,而不是’通过蓝牙还是 Wi-Fi 通信’。”类比的话,它有点像局域网里的”服务发现 + RPC”的组合,但下沉到了系统层。
Q2:设备发现与认证是怎么做的?
需要满足几个前提条件:
- 设备登录同一个华为账号(同一账号体系是信任基础)。
- 处于同一局域网或近距离范围内(蓝牙/Wi-Fi 可及)。
- 开启蓝牙与 Wi-Fi(底层发现机制依赖它们)。
认证通过后设备间建立加密传输通道。这一步由系统完成,应用只需要申请分布式设备发现与协同相关的权限,并调用系统提供的能力。
Q3:需要申请哪些权限?
// module.json5 中声明
{
  "requestPermissions": [
    { "name": "ohos.permission.DISTRIBUTED_DATASYNC" },        // 分布式数据同步
    { "name": "ohos.permission.DISTRIBUTED_SOFTBUS_CENTER" },  // 软总线中心
    { "name": "ohos.permission.GET_DISTRIBUTED_DEVICE_INFO" }  // 获取设备信息
  ]
}要点:分布式相关权限属于较高级别的权限,需要在应用市场申请,且必须在代码中做动态申请与用户授权,声明了不代表直接生效。
二、应用流转:跨设备迁移
Q4:什么是应用流转(Continuation)?
指把一个正在运行的应用(连同它的界面状态),从设备 A 迁移到设备 B 上继续运行。典型场景:手机上看着的视频,一碰平板就切换到平板上继续播。
核心 API 是 UIAbility 的两个回调:
import { UIAbility } from '@kit.AbilityKit'
import { BusinessError } from '@kit.BasicServicesKit'

export default class EntryAbility extends UIAbility {
  // 1. 发起端:保存状态,系统把它带到目标设备
  onContinue(wantParam: Record<string, Object>): AbilityConstant.OnContinueResult {
    wantParam['videoId'] = this.currentVideoId
    wantParam['playPosition'] = this.player.currentTime
    return AbilityConstant.OnContinueResult.AGREE   // 同意流转
  }

  // 2. 目标端:恢复状态
  onCreate(want: Want, launchParam: AbilityConstant.LaunchParam): void {
    if (want.parameters?.['videoId']) {
      this.currentVideoId = want.parameters['videoId'] as string
      this.startPosition = want.parameters['playPosition'] as number
    }
  }
}关键点:onContinue 里返回 AGREE 表示允许流转;返回 REJECT 则拒绝(比如当前正处于支付等不适合迁移的界面)。状态通过 wantParam 传递,数据量应控制在较小范围。
Q5:流转时状态保存有什么限制?
- 只能传可序列化的数据,不能传对象实例、函数、闭包。
- 数据量有上限,通常建议控制在几十 KB 以内,只传”恢复现场所需的最小信息”(ID + 位置 + 少量上下文),详细数据由目标端自行从网络或分布式数据库加载。
- 耗时操作不要在
onContinue里做,它必须快速返回,否则流转会卡顿。
Q6:流转和”跨设备启动”有什么区别?
- 流转(Continue):强调连续性——原设备上通常会退出,状态被带走。
- 跨设备启动(StartAbility):只是在另一台设备上新开一个界面,原设备状态不受影响,更像”遥控器”式的协同。
// 跨设备启动:指定目标设备的 deviceId
const want: Want = {
  deviceId: targetDeviceId,        // 目标设备 ID
  bundleName: 'com.example.app',
  abilityName: 'EntryAbility',
  parameters: { docId: '123' }
}
context.startAbility(want).catch((err: BusinessError) => {
  console.error(`跨设备启动失败:${err.code}`)
})
三、分布式数据:跨设备状态同步
Q7:分布式数据库(KV Store)怎么用?
import { distributedKVStore } from '@kit.ArkData'

// 1. 创建 KVManager
const kvManager = distributedKVStore.createKVManager({
  bundleName: 'com.example.app',
  context: this.context
})

// 2. 获取分布式数据库(指定 multiUser 与 securityLevel)
const options: distributedKVStore.Options = {
  createIfMissing: true,
  encrypt: true,
  backup: false,
  kvStoreType: distributedKVStore.KVStoreType.SINGLE_VERSION,
  securityLevel: distributedKVStore.SecurityLevel.S2
}
const kvStore = await kvManager.getKVStore<string>('notes', options)

// 3. 写入会自动同步到同组网下的其他设备
await kvStore.put('note-1', JSON.stringify({ title: '购物清单', items: [...] }))

// 4. 订阅数据变更(包括其他设备改的)
kvStore.on('dataChange', distributedKVStore.SubscribeType.SUBSCRIBE_TYPE_ALL,
  (data) => {
    for (const entry of data.insertEntries) {
      console.info(`新增/变更:${entry.key}`)
      // 更新 UI
    }
    for (const entry of data.deleteEntries) {
      console.info(`删除:${entry.key}`)
    }
  })

// 5. 手动指定同步到哪些设备
const deviceIds = ['device-xxx', 'device-yyy']
await kvStore.sync(deviceIds, distributedKVStore.SyncMode.PUSH_PULL)要点:SINGLE_VERSION 是单版本数据库(同一个 key 只保留最新值,适合状态同步);DEVICE_COLLABORATION 是设备协同数据库(按设备维度组织数据,适合多设备各写各的)。选错类型会导致数据被意外覆盖。
Q8:数据冲突怎么解决?
这是分布式场景最核心的问题。鸿蒙的 KV Store 默认策略是最后写入胜出(Last Write Wins)——以时间戳较新的修改为准。
如果业务上不能接受这种粗粒度策略,需要在应用层做冲突处理:
- 按设备分区:用
DEVICE_COLLABORATION类型,每个设备写自己的 key 空间(如{deviceId}:{noteId}),从根本上避免写冲突。 - 业务版本号:value 里带上版本号与更新时间,读取时比较并做合并。
- CRDT 思路:把数据结构设计成天然可合并的(如带逻辑时钟的增量操作日志)。
- 明确业务语义:某些场景下”谁最后操作听谁的”本来就是合理语义,那就接受默认策略,不必过度设计。
加分点:主动说明”离线修改 + 重新联网后的合并”这个场景。两台设备各自离线编辑了同一条记录,重新组网后必然冲突。能想到这一层,说明真的理解分布式数据的难点在哪。
Q9:安全等级(SecurityLevel)是什么?
分布式数据同步涉及跨设备传输,鸿蒙用安全等级来约束”什么样的数据可以在什么样的设备之间流动”。
- 等级从
S0(最低)到S4(最高,需硬件级安全能力)。 - 设备安全等级必须达到数据库的等级要求,才能参与该数据库的同步。
- 实践中常用
S2(需要设备具备基本的完整性保护能力)。
意义:防止敏感数据(如支付信息)同步到安全性不足的设备上。这是个常见的加分点,很多人完全不知道这个机制的存在。
四、分布式能力进阶
Q10:除了数据同步,还有哪些分布式能力?
- 分布式文件:跨设备访问文件,用统一的 URI 访问远端设备上的文件。
- 分布式硬件:调用其他设备的硬件能力——用平板的摄像头、用手表的传感器、用电视的扬声器。这是”超级终端”体验的核心。
- 分布式任务调度:把计算任务调度到算力更强的设备上执行。
- 跨设备剪贴板 / 拖拽:在一台设备复制、另一台设备粘贴;把文件从手机拖到平板。
Q11:分布式硬件(Device Virtualization)的原理?
把远端设备的硬件能力虚拟成本地硬件注册到硬件资源池里。应用调用 Camera 相关 API 时,系统返回的是”当前最优的摄像头”——可能是本机的后置摄像头,也可能是平板上画质更好的那颗。
关键点:应用代码不需要改,还是调用标准的相机 API,只是系统把硬件选择权接管了。这是软总线之上的一层抽象。
Q12:跨设备调用失败怎么排查?
给一套排查顺序:
- 设备侧:是否登录同一账号?蓝牙/Wi-Fi 是否开启?是否在同一局域网?设备是否解锁且亮屏?
- 权限侧:权限是否已在 module.json5 声明?是否完成了动态申请并获用户授权?是否通过了应用市场的权限审核?
- 安全等级:数据库的安全等级是否超过了目标设备的能力等级?
- API 侧:
deviceId是否正确且未过期(设备 ID 会变化,不要硬编码或长期缓存)? - 日志侧:看
BusinessError.code,对照官方错误码表定位;用hilog打点跟踪调用链。
五、设计层面的追问
Q13:做一个跨设备应用,架构上要注意什么?
- 状态与 UI 分离:跨设备迁移本质是”状态迁移 + UI 重建”,状态必须能被完整、独立地序列化出来。把状态耦合在 UI 组件里,流转必然出问题。
- 设备能力适配:手机竖屏、平板横屏、车机大字体、手表圆形屏——布局必须是响应式的。推荐用自适应布局 + 响应式布局能力(断点、栅格、媒体查询),而不是为每种设备写一套代码。
- 输入方式差异:手机是触摸,车机要考虑语音,手表要考虑表冠。交互设计要跟着设备走。
- 降级策略:必须假设”只有一台设备”也能用。分布式能力是增强,不是前提——否则用户在没有第二台设备时完全无法使用。
- 数据量控制:跨设备传输有成本和延迟,只同步必要的增量,不要什么都往分布式数据库里塞。
Q14:分布式带来的性能开销怎么控制?
- 减少同步频率:高频变更的数据不该走分布式同步(比如播放进度每秒更新一次,会持续触发跨设备传输)。只在关键节点同步(暂停、切集、退出)。
- 数据分片:大文档不要存成一个大 value,拆成小单元,只同步改动的部分。
- 订阅粒度收敛:订阅范围过大会收到大量无关变更通知,浪费 CPU 和电量。
- 传输量预估:跨设备传输经由无线链路,延迟和带宽都远不如本地内存,设计时要按”网络调用”的心态来对待,而不是按”本地读写”。
六、小结
鸿蒙分布式这一块的答题主线是“屏蔽差异 + 状态可迁移”:软总线屏蔽了物理链路的差异,分布式数据对象屏蔽了”数据在哪台设备上”的差异,而应用流转要求把状态从 UI 里彻底剥离出来——因为跨设备迁移传的永远是状态,不是界面。
准备策略:亲手做一次”手机 → 平板”的流转,把 onContinue 和 onCreate 的配对、分布式 KV Store 的订阅回调走通一遍。这块内容看文档很难建立直觉,跑通一次胜过背十道题。
参考:HarmonyOS 分布式开发指南、应用接续(流转)文档、分布式 KV 存储文档。API 与安全等级要求随版本演进,请以所用 SDK 版本的官方文档为准。
标签
#鸿蒙面试题#分布式#软总线#面试