loader

Nerio News Magazine brings you trusted, timely and thought-provoking stories from around the globe.

Follow Us

前端安全与网络面试 25 问:XSS、CSRF、CORS、HTTPS 与鉴权

前端安全与网络面试 25 问:XSS、CSRF、CORS、HTTPS 与鉴权
关键词前端面试题、XSS、CSRF、CORS、HTTPS、JWT、前端安全

安全和网络是前端面试里最容易被低估、也最容易失分的一块。原因是它横跨浏览器、协议、服务端三个层面,很多人只记得几个名词缩写,一追问”那具体怎么防”就答不上来。

本文按同源策略 → XSS → CSRF → CORS → HTTPS → 鉴权 → 传输协议七段组织,每段给出可直接口述的答案框架。这部分内容稳定,不随框架版本变动,性价比很高。
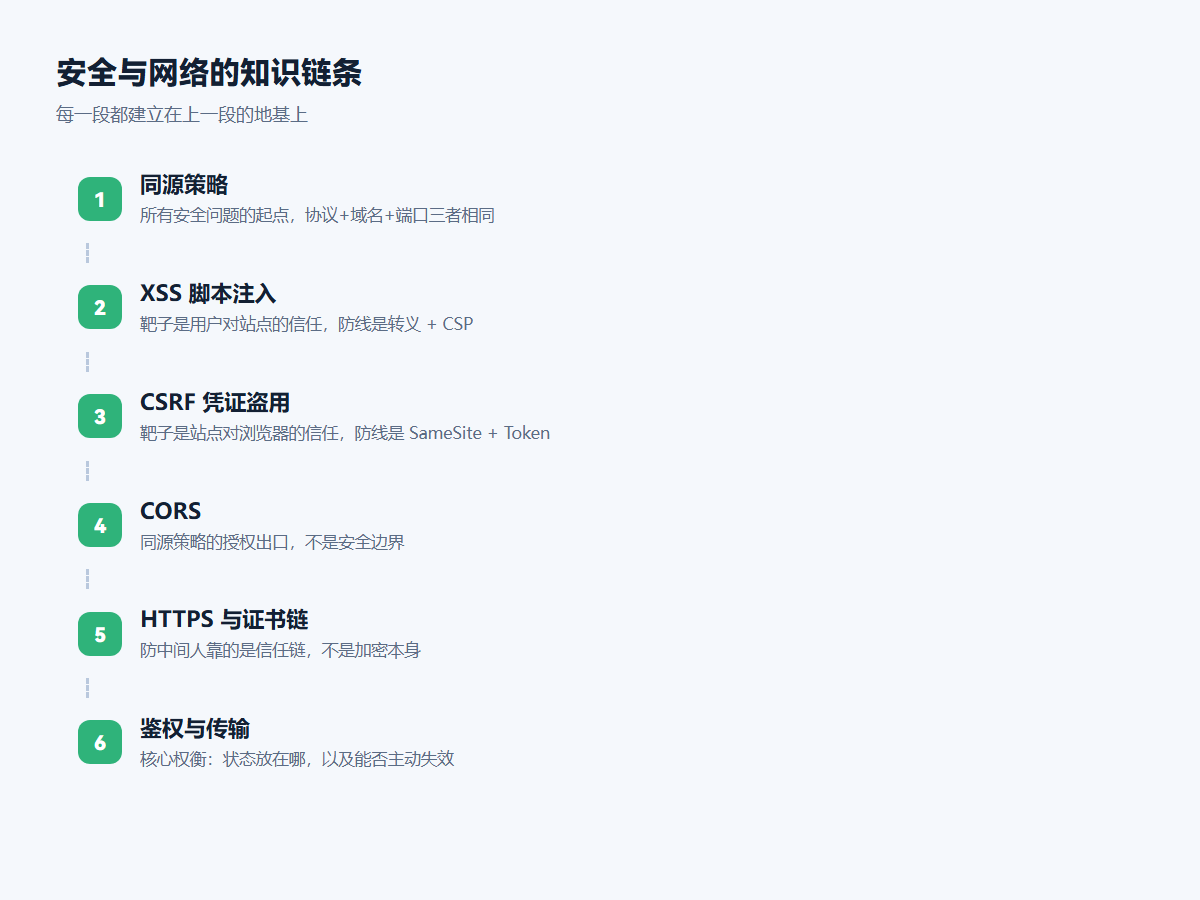
安全与网络的知识链条
前端安全知识链:同源策略 → XSS → CSRF → CORS → HTTPS → 鉴权

一、同源策略:所有安全问题的起点

Q1:什么是同源?同源限制了什么?

同源 = 协议 + 域名 + 端口 三者完全相同。注意端口是参与比较的,example.comexample.com:8080 不同源。

同源策略限制三类行为:

  1. DOM 访问:不同源的 iframe 之间不能互相读 DOM(contentWindow.document 会抛错)。
  2. 数据读取:不能读取不同源下的 Cookie、LocalStorage、IndexedDB。
  3. 网络响应XMLHttpRequest/fetch 发出的跨域请求,响应会被浏览器拦截(请求实际已发出、服务端也收到了,只是拿不到结果)。

高频追问:”跨域请求到底有没有发到服务器?”——发了。简单请求会完整发出并被服务端处理,只是响应被浏览器扣下;非简单请求会先发 OPTIONS 预检,预检不通过才不会发真实请求。这个区别在排查”服务端日志里有请求但前端报错”时很关键。

Q2:有哪些合法的跨域方案?

  • CORS:服务端在响应头里声明允许的源,标准方案。
  • 反向代理:开发环境的标配(Vite server.proxy、Nginx)。本质是让浏览器以为同源。
  • JSONP:利用 <script> 不受同源限制,只支持 GET、已淘汰,知道原理即可。
  • postMessage:iframe / 弹窗之间跨域通信的标准 API。
  • WebSocket:本身不受同源策略限制(但服务端应校验 Origin)。

二、XSS:把别人的脚本执行在你的页面上

Q3:XSS 分哪几类?

类型 注入路径 是否经过服务端 典型场景
存储型 恶意内容存进数据库 评论、昵称、富文本
反射型 恶意内容在 URL 参数里 是(原样返回) 搜索页回显、错误页
DOM 型 前端 JS 直接把不可信数据写进 DOM innerHTML = location.hash

Q4:怎么防?说出三层防线

第一层:输出编码 / 转义。这是最根本的。把用户数据当成”文本”而不是”HTML”插入:

// 危险:把字符串当作 HTML 解析
el.innerHTML = userInput
document.write(userInput)

// 安全:作为纯文本插入
el.textContent = userInput

// Vue / React 的插值默认就是安全的
<div>{{ userInput }}</div>        // 会转义
<div v-html="userInput"></div>   // 危险,等同于 innerHTML
<div dangerouslySetInnerHTML={{__html: x}} />  // React 中的危险写法

第二层:CSP(内容安全策略)。通过响应头限定页面能加载和执行的资源来源,即使发生了注入,脚本也跑不起来:

Content-Security-Policy:
  default-src 'self';
  script-src 'self' https://cdn.example.com;
  object-src 'none';
  base-uri 'self';
  frame-ancestors 'none'

要点:避免用 unsafe-inlineunsafe-eval,否则 CSP 形同虚设。实际落地时先上 Content-Security-Policy-Report-Only 观察一段时间再切正式。

第三层:富文本白名单。业务上确实需要渲染 HTML 时(比如文章正文),必须用 DOMPurify 这类库做白名单清洗,不要自己写正则过滤——正则做 HTML 过滤几乎一定会被绕过。

三、CSRF:借你的身份发请求

Q5:CSRF 的原理是什么?和 XSS 有什么区别?

核心区别一句话:XSS 是”在你的页面里执行我的脚本”,CSRF 是”借你的 Cookie 发我不想发的请求”。

  • XSS 利用了你对用户的信任(用户信任这个网站)。
  • CSRF 利用了网站对用户浏览器的信任(服务端看到 Cookie 就认为是本人)。

攻击流程:用户登录了银行站点 A,Cookie 还在;然后访问了恶意站点 B,B 的页面里有一个自动提交的表单或 <img src="https://a.com/transfer?to=evil&amount=1000">;浏览器发请求时会自动带上 A 的 Cookie,于是转账成功。

Q6:CSRF 怎么防?

  1. SameSite Cookie(首选,最省事):给 Cookie 加 SameSite=Lax(或 Strict),浏览器就不会在跨站请求里自动带上它。
  2. CSRF Token:服务端下发一个随机 token 埋在页面里,请求时带上,服务端校验。攻击者拿不到这个 token,因为它在别的域下读不到你的页面内容。
  3. 校验 Origin / Referer:服务端检查请求来源是否在白名单内。作为辅助手段,别单独依赖(Referer 可能被隐私策略剥离)。
  4. 关键操作二次确认:短信验证码、密码确认、人机验证。
Set-Cookie: session=xxx; HttpOnly; Secure; SameSite=Lax; Path=/

面试高频追问:”用了 Token 存 LocalStorage 是不是就没有 CSRF 问题了?“——是的,CSRF 的前提是浏览器自动携带凭证,手动在 Authorization 头里塞 token 不会自动带上,因此天然免疫 CSRF。但代价是它暴露给了 JS,XSS 一打就全没了。这是两个风险之间的取舍,不是白拿。

四、CORS:把跨域说清楚

Q7:简单请求和预检请求的区别?

同时满足以下条件的才是简单请求(不触发预检):

  • 方法是 GETHEADPOST 之一
  • 请求头只包含 AcceptAccept-LanguageContent-LanguageContent-Type(且值仅为 application/x-www-form-urlencodedmultipart/form-datatext/plain)、Range

所以 Content-Type: application/json 会触发预检——这是实际开发中最常见的”为什么多了个 OPTIONS 请求”的原因。

Q8:带 Cookie 的跨域请求要注意什么?

// 前端
fetch('https://api.example.com/data', {
  credentials: 'include'    // axios 对应 withCredentials: true
})

// 服务端响应头
Access-Control-Allow-Origin: https://app.example.com   // 不能是 *
Access-Control-Allow-Credentials: true
Access-Control-Allow-Headers: Content-Type, Authorization
Access-Control-Allow-Methods: GET, POST, PUT, DELETE
Access-Control-Max-Age: 86400        // 预检结果缓存 24h,减少 OPTIONS

三个必考点:① Allow-Origin 不能是通配符 *;② 必须带 Allow-Credentials: true;③ 配合 SameSite=None 时,Cookie 必须同时带 Secure,也就是必须走 HTTPS

五、HTTPS 与传输安全

Q9:HTTPS 握手过程能讲一遍吗?

抓住主线,不用背到每个字节:

  1. 客户端发 ClientHello:支持的 TLS 版本、密码套件列表、随机数。
  2. 服务端回 ServerHello:选定的套件、随机数、数字证书
  3. 客户端校验证书:是否由可信 CA 签发、域名是否匹配、是否在有效期内、是否被吊销(OCSP / CRL)。
  4. 密钥交换:TLS 1.3 下用 ECDHE 交换临时密钥,双方算出相同的会话密钥。因为临时密钥不参与长期存储,所以具备前向安全性
  5. 切换到对称加密(如 AES-GCM)传输应用数据。

加分点:TLS 1.3 把握手从 2-RTT 压缩到 1-RTT,会话复用时是 0-RTT,并且砍掉了一批不安全的套件(静态 RSA 密钥交换、RC4、SHA-1 等)。

Q10:中间人攻击是怎么防住的?

证书链 + 签名验证而不是加密本身。中间人确实可以拦下流量、伪造一个证书,但他拿不到受信任 CA 的私钥,签不出能通过浏览器校验的证书。浏览器内置了根 CA 列表,逐级验证签名,任何一级对不上就拦下来。

这也是为什么公司抓包工具需要你手动安装并信任它的根证书——一旦你信任了,它就能签出合法证书,HTTPS 的防护就被你主动绕过了。

Q11:Cookie 的四个安全属性分别管什么?

  • Secure:只在 HTTPS 下发送。
  • HttpOnly禁止 JS 读取document.cookie 拿不到),是防 XSS 窃取会话的关键。
  • SameSiteStrict 完全禁止跨站携带;Lax 允许导航类 GET 请求携带(当前主流默认值);None 允许跨站携带(需配合 Secure)。
  • __Host- 前缀:强制该 Cookie 必须 SecurePath=/、不带 Domain,防止子域覆盖。

六、鉴权方案怎么选

Q12:Session-Cookie 和 JWT 各自的取舍?

维度 Session + Cookie JWT
状态存储 服务端存(Redis 等) 无状态,服务端不存
扩展性 需要共享存储 / 粘性会话 天然适合多节点
主动失效 容易,删掉 session 即可 ,签发后无法单方面收回
载荷大小 只有一个 sessionId 每次请求都带上完整载荷
适合的场景 需要即时踢人、权限变更频繁 短时效、跨域调用、一次性令牌

关键判断句:JWT 的”无状态”既是优点也是代价——它换来的扩展性,是以”无法主动失效”为代价的。实践中常用的折中是短时效 Access Token + 可刷新的 Refresh Token,并在服务端维护一份轻量的黑名单来兜底。

Q13:JWT 存在哪里?

  • localStorage:方便,但 XSS 可直接读取。不推荐放长期凭证。
  • Cookie(HttpOnly + Secure + SameSite):JS 读不到,XSS 拿不走,但需要防 CSRF。生产环境更稳的选择。
  • 内存(变量 / 状态管理):最安全,刷新即失效,配合 Refresh Token 使用。

高分答法:没有银弹,只有取舍。Cookie 方案怕 CSRF(可用 SameSite 缓解),localStorage 方案怕 XSS(无解,只能靠 CSP 和输出编码去降低 XSS 发生的概率)。所以问题的落点是”你更怕哪一个,以及你的 XSS 防线有多厚“。

七、HTTP 版本与传输

Q14:HTTP/1.1、2、3 的核心差异?

  • HTTP/1.1:文本协议,长连接,但存在队头阻塞(同一连接上请求必须排队)。浏览器靠开 6 个连接缓解。
  • HTTP/2:二进制分帧 + 多路复用,一个连接上并发多个流,解决了应用层的队头阻塞;附带 HPACK 头部压缩、服务端推送(实践中效果不佳,已基本弃用)。
  • HTTP/3:传输层从 TCP 换成 QUIC(基于 UDP),解决了 TCP 层的队头阻塞——丢包时不再阻塞所有流;握手合并进 TLS,连接建立更快;支持连接迁移(切换网络不断线)。

追问”那 HTTP/2 还有队头阻塞吗”——。它只在应用层解决了,TCP 层丢包时,所有流仍然要等重传。这就是为什么需要 HTTP/3。

Q15:强缓存和协商缓存怎么配合?

// 强缓存:命中则完全不发请求
Cache-Control: max-age=31536000, immutable    // 带 hash 的静态资源
Cache-Control: no-cache                        // 允许缓存但每次必须校验

// 协商缓存:发请求问服务端,没变则返回 304
Etag: "abc123"           // 请求时带 If-None-Match
Last-Modified:     // 请求时带 If-Modified-Since

标准策略:带内容 hash 的静态资源用 max-age=1年, immutable;HTML 入口用 no-cache。这样发版时 HTML 会重新校验,一旦内容变了就引用新的 hash 文件名,旧资源自然失效。

八、小结

这一块的答题方法论是先分层、再讲权衡:同源策略是地基,XSS 是”脚本注入”、CSRF 是”凭证盗用”,两者靶子不同;CORS 是同源策略的授权出口而不是安全边界;HTTPS 靠的是证书信任链;鉴权方案的核心权衡在”状态放哪”和”能否主动失效”。

能把这五句讲清楚,并且每个防护手段都说得出”它防的是什么、代价是什么”,这一块基本稳了。


参考:MDN · CSPMDN · CORSOWASP Top 10。安全建议随标准演进,落地前请以官方最新文档为准。

标签

#前端面试题#网络安全#HTTPS#面试

前端框架原理面试 30 问:虚拟 DOM、Diff、响应式与调度器

前端框架原理面试 30 问:虚拟 DOM、Diff、响应式与调度器
关键词前端面试题、虚拟 DOM、Diff 算法、Fiber、响应式原理、React Compiler

框架原理是前端面试里最能拉开差距的一块。背 API 谁都会,但”为什么 React 要引入 Fiber”、”Vue 的响应式为什么要用 WeakMap”、”虚拟 DOM 一定更快吗”这类问题,考察的是你能不能从设计约束反推出技术选型

本文按虚拟 DOM → Diff → 响应式 → 调度 → 编译期优化五层组织,每层给出高频问题、标准答案要点,以及面试官真正想听到的那句话。版本坐标截至 2026 年 9 月:React 19.2.8、Vue 3.5.42(3.6.0-rc.7 在 RC)、Svelte 5.57.0、Solid 1.9.15。

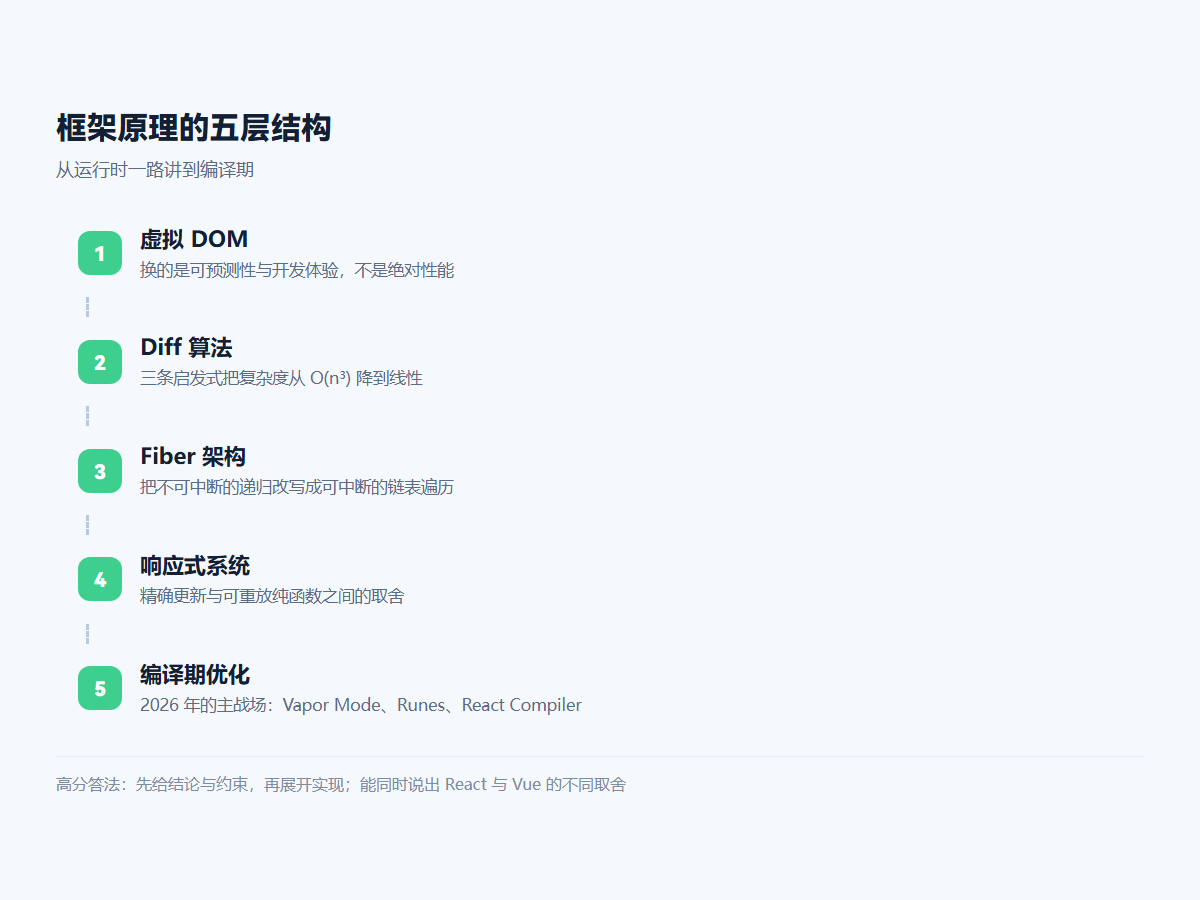
框架原理的五层结构
框架原理五层:虚拟 DOM → Diff → Fiber → 响应式 → 编译期优化

一、虚拟 DOM:先把它请下神坛

Q1:虚拟 DOM 一定比直接操作 DOM 快吗?

不一定,而且这个说法本身就是错的。虚拟 DOM 的价值不是”更快”,而是把”什么变了”这件事从人脑转移到运行时,从而让你能用声明式的方式写 UI,同时保证一个可接受的性能下限。

精确的对比应该是:

  • 首次渲染:虚拟 DOM 一定更慢——它多了一步构建 VNode 树和 render 的开销。
  • 小范围精准更新:手写 el.textContent = x 一定更快,没有 diff 成本。
  • 复杂视图的中大范围更新:虚拟 DOM 通常更快,因为它能批量计算出最小变更集,避免大量无谓的读写交错导致的重排。

面试高分答法:把”快不快”改成”在什么约束下换取了什么“——牺牲首次渲染性能和一点内存,换取声明式写法 + 可预测的性能下限 + 跨平台渲染能力(同一棵 VNode 树可以渲染到 DOM、Canvas、Native)。

Q2:为什么需要 key?用 index 当 key 会出什么问题?

key 是 diff 算法用来判断”新旧两个节点是不是同一个东西”的身份证。没有 key 时,框架只能按位置一一对应(就地复用),这在某些场景下会错误地复用了带有内部状态的节点

// 反例:用 index 当 key
// 列表 [A, B, C],删除 A 后变成 [B, C]
// index 复用后:原位置0 的 A 节点被复用成 B,组件内部 state 错位
{list.map((item, i) => <Row key={i} data={item} />)}

// 正例:用稳定业务 ID
{list.map(item => <Row key={item.id} data={item} />)}

典型翻车场景:列表项里有输入框、勾选状态、动画状态。删除第一项后,第二项的输入框内容会”跑”到第一项上。如果列表只是纯展示、无内部状态、无顺序变更,用 index 不会出问题——但这是个不该赌的假设。

二、Diff 算法:从 O(n³) 到 O(n) 的那一步

Q3:为什么树的最小编辑距离是 O(n³),而框架能做到 O(n)?

因为框架放弃了”最优解”,只求”在真实场景下足够好的解”。它引入了三个启发式约束:

  1. 只做同层比较,不做跨层级的节点移动。一旦发现节点跑到了别的层级,直接删掉重建。
  2. 同层比较时按 key 匹配,通过哈希表把”找对应节点”从 O(n²) 降到 O(n)。
  3. 类型不同直接整棵替换,不再往下比。<div> 变成 <span>,整棵子树重建。

这三条把问题从”通用树编辑距离”降到了”同层序列的匹配”,复杂度随之降为线性。

Q4:React 的 Fiber 到底解决了什么问题?

在 Fiber 之前(React 15 的 Stack Reconciler),递归遍历组件树是不可中断的——一次更新从根一路递归到叶子,中间不能停。组件树深了(比如几千个节点),这一次递归可能占住主线程几十到几百毫秒,期间用户输入、动画全部卡住。

Fiber 的核心改动是把递归改写成链表上的循环

// Fiber 节点之间用三个指针连起来,形成可遍历、可中断的链表
fiberNode.child     // 第一个子节点
fiberNode.sibling   // 下一个兄弟节点
fiberNode.return    // 父节点

// 于是 workLoop 可以随时停下来
function workLoop(deadline) {
  while (nextUnitOfWork && deadline.timeRemaining() > 1) {
    nextUnitOfWork = performUnitOfWork(nextUnitOfWork)
  }
  // 时间片用完了,把控制权还给浏览器,下一帧继续
  requestIdleCallback(workLoop)
}

这里要区分两个概念,很多人答混:

  • Fiber 架构:数据结构 + 可中断的遍历机制(React 16 引入)。
  • Concurrent 并发特性:基于 Fiber 的可中断能力,实现的优先级调度(React 18 引入)。useTransitionSuspense、自动批处理都建立在这上面。

Q5:useTransition 和防抖节流有什么区别?

这是 2026 年很常见的追问,两者解决的其实是不同层面的问题

维度 防抖 / 节流 useTransition
作用层面 减少触发次数 降低单次渲染的优先级
实现机制 定时器延后执行 把更新标记为低优先级,可被高优先级打断
能否中断 不能,一旦执行就走完 能,用户输入可打断进行中的低优先级渲染
典型场景 搜索框请求、resize 大列表筛选、路由切换的 loading 态

关键判断句:防抖是”少做几次”,useTransition 是”做是可以做,但别挡着用户”。前者减少了工作量,后者改变了工作安排的顺序。

三、响应式:两大阵营的根本分歧

Q6:Vue 3 的响应式是怎么实现的?为什么用 WeakMap?

核心是 Proxy 拦截 + 依赖收集。三层数据结构要能画出来:

// targetMap: WeakMap<object, Map<key, Set<effect>>>
const targetMap = new WeakMap()

function track(target, key) {
  if (!activeEffect) return
  let depsMap = targetMap.get(target)
  if (!depsMap) targetMap.set(target, depsMap = new Map())
  let dep = depsMap.get(key)
  if (!dep) depsMap.set(key, dep = new Set())
  dep.add(activeEffect)      // 收集依赖
}

function trigger(target, key) {
  const dep = targetMap.get(target)?.get(key)
  dep?.forEach(effect => effect())   // 触发更新
}

为什么最外层用 WeakMap?因为键是对象引用。WeakMap 持有弱引用,当响应式对象被销毁、没有任何其他引用时,垃圾回收可以正常回收它,对应的依赖集合也会自动消失。用 Map 会造成内存泄漏——对象已经不用了,但因为被 Map 的键强引用着,永远无法回收。

顺带一提,Vue 3.6 把内部响应式实现换成了 alien-signals,采用基于版本号的双向链表而非 Set 来组织依赖,内存占用和更新传播开销进一步下降。这是对外的实现替换,ref/reactive 的 API 行为保持一致。

Q7:React 为什么不做”自动依赖收集”?

不是不能,而是选择了不同的取舍。React 的模型是不可变数据 + 显式重渲染:状态变了,组件函数重新执行,生成新的元素树,再由 diff 找出真实变更。

代价是会产生”无谓的重渲染”(所以才需要 memouseMemouseCallback);收益是数据流可预测、可重放、可并发中断——因为组件必须是纯函数,才能在并发渲染里被安全地打断和重做。

而 Vue 的细粒度响应式,更新是”精确命中”的,天然不需要 memo,但组件的执行时机是隐式的,与并发渲染这套机制的兼容性成本更高。React Compiler 1.0 已 GA,它做的事正是在编译期自动插入等价的 memo 逻辑,把”手动优化”这一层负担收掉,而不改变底层模型。

Q8:Vue 的 refreactive 怎么选?

回答要点:

  • reactive 只能代理对象,解构或返回时会丢失响应性(因为 Proxy 是绑在对象上的,解构出来的是普通值)。
  • ref 包了一层 { value },靠引用来承载响应性,可以承载任意类型,传递和解构都不丢。
  • 实践上:优先用 ref,除非明确需要一组强关联的字段。团队统一比追求”语法更干净”重要。
  • 陷阱:reactive 对象整体替换(obj = {...})不会触发更新,必须改属性或用 Object.assign

四、调度与时间切片

Q9:setState 到底是同步还是异步?

这个问题本身问得不准确,标准答法是分版本、分场景

  • React 18 之前:在 React 事件处理函数里是批处理的(表现为”异步”);在 setTimeout、原生事件、Promise 回调里是同步的,每次调用立即触发渲染。
  • React 18 之后:自动批处理(Automatic Batching)覆盖了所有场景,包括 timeout 和原生事件。所以在 React 18+ 里,它总是批处理的
// React 18+:以下两次 setState 只会触发一次渲染
setTimeout(() => {
  setCount(c => c + 1)
  setFlag(f => !f)
}, 1000)

// 如果需要"立刻读到更新后的 DOM",用 flushSync
import { flushSync } from 'react-dom'
flushSync(() => setCount(1))   // 同步刷新,跳出批处理

加分点:批处理依赖的是”更新被调度到同一个批次”,而 flushSync 是显式的逃生舱,代价是同步渲染阻塞主线程,别滥用。

Q10:React 的渲染分哪几个阶段?哪些能被打断?

两个阶段必须分清:

  1. Render 阶段(可中断):构建 Fiber 树、diff 出变更、收集副作用。这个阶段是纯计算,可以随时中断、重做、丢弃。对应的生命周期/computed 逻辑必须是纯的——这也是为什么 componentWillMount 这类被废弃。
  2. Commit 阶段(不可中断):把变更一次性刷到真实 DOM,执行 layout effect 和 passive effect。必须一口气做完,否则用户会看到撕裂的界面。

一句话总结:Render 阶段可以重来,Commit 阶段必须一次成功。理解了这点,就能理解为什么副作用要写在 useEffect 而不是渲染逻辑里。

五、2026 年的新考点:编译期优化

Q11:什么是”编译期优化”?Signal 和虚拟 DOM 是对立的吗?

趋势是:把运行时的 diff 工作尽量挪到编译期。几个代表:

  • Svelte 5 runes:编译时就分析出状态依赖关系,生成直接操作 DOM 的更新代码,运行时根本没有虚拟 DOM。
  • Solid:细粒度 Signal,更新时直接定位到具体的 DOM 绑定,不经过组件重渲染。
  • Vue Vapor Mode(3.6):对标注了 <script setup vapor> 的组件,跳过虚拟 DOM,编译成直接操作 DOM 的代码,与虚拟 DOM 组件可以混用。

关键认知:Signal 和虚拟 DOM 不是非此即彼。Vue 3.6 的做法就是同一套响应式 + 两套渲染策略共存,按组件粒度选择。面试时说出”这是渲染策略的可选项,不是框架路线之争”,会显得认知比较新。

Q12:为什么 React Compiler 能自动做 memo?

因为它在编译期做了数据流分析:分析出哪些值的依赖没变,就把对应的计算结果缓存下来,等价于手写的 useMemo/useCallback/memo,但粒度更细(可以精确到 JSX 内部的某个表达式)。

它的前提是组件必须遵守 React 的规则:纯函数、不在渲染中修改外部变量、Hooks 调用顺序稳定。这也是为什么配套的 eslint-plugin-react-hooks(当前 7.1.1)成了必需项——编译器只能优化它”敢确定”的部分,规则违规的地方会保守地跳过优化

六、怎么把这一块答出彩

框架原理题的评分标准,通常不是”答对”,而是有没有分层和取舍意识。给三条实操建议:

  1. 先给结论,再给约束。不要从实现细节讲起。比如被问 Fiber,先说”它解决的是不可中断的递归导致的长任务阻塞”,再展开数据结构。
  2. 主动做对比。能同时说出 React 和 Vue 的不同取舍,说明你理解的是设计空间而不是某个框架的 API。
  3. 准备一个真实的踩坑案例。”我们列表用了 index 做 key,导致筛选后勾选状态错位,排查了半天”——这类例子比背十条回答都有说服力。

七、小结

框架原理这一块可以收敛成五句话:虚拟 DOM 换的是开发体验和可预测性而非绝对性能;Diff 靠三条启发式把复杂度降到线性;Fiber 把递归改写成可中断的链表遍历;响应式两大阵营的分歧在”精确更新”与”可重放纯函数”之间取舍;2026 年的主战场已经挪到了编译期。


参考:React 官方文档Vue 响应式深入Svelte Runes 文档。版本号以 npm dist-tags 为准,引用前建议再核一次。

标签

#前端面试题#React#Vue#面试

为什么 MySQL 用 B+Tree 而分布式 KV 用 LSM-Tree:从写入方式讲起

为什么 MySQL 用 B+Tree 而分布式 KV 用 LSM-Tree:从写入方式讲起
关键词B+Tree、LSM-Tree、存储引擎、写放大、读放大、Compaction

为什么 MySQL 用 B+Tree,而很多分布式 KV 存储用 LSM-Tree?答案不是”哪个更先进”,而是它们对磁盘的写入方式根本不同,进而决定了各自适合什么负载

理解这个差异,很多数据库的”奇怪行为”就都能解释了:为什么 LSM 系的库写入快但读延迟抖动,为什么 B+Tree 系的表在大量随机写入后会变慢。

一、根本分歧:原地更新 vs 追加写入

这是两条路线的分水岭。

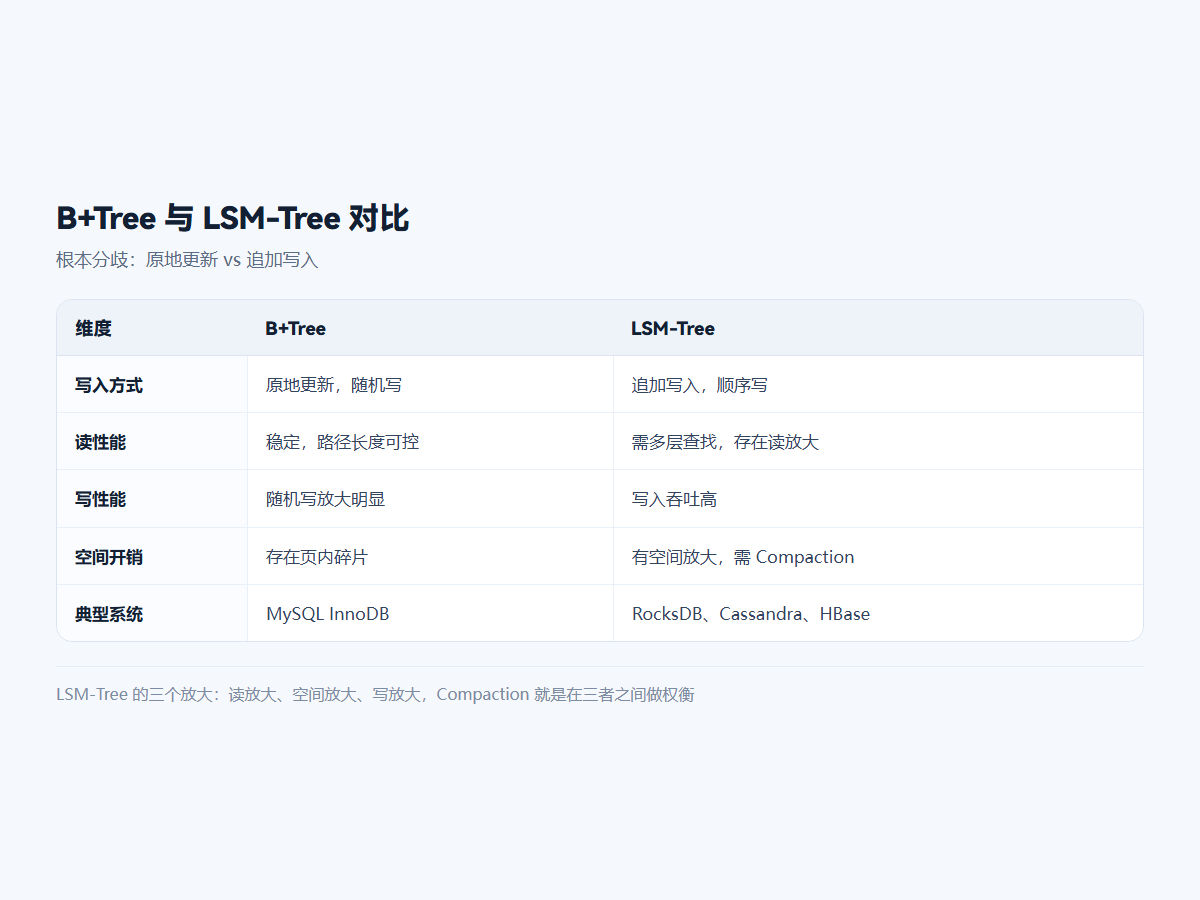
B+Tree 与 LSM-Tree 对比
两种索引结构在写入方式、读写性能与典型系统上的差异

B+Tree:原地更新

B+Tree 是一棵多路平衡搜索树,数据主要存在叶子节点,叶子之间用链表串起来。它的更新方式是找到那条记录在磁盘上的位置,直接改掉

这个模型很符合直觉,也带来几个直接优势:读路径短且稳定——从根到叶子最多三四层,且因为有缓存,实际 IO 次数更少;范围查询极快——叶子节点本身有序且相连,扫一段区间就是顺序读。

代价在写入。随机主键写入意味着每次修改都可能落在磁盘的不同位置,产生随机 IO。更麻烦的是页分裂:当一个数据页写满,要分裂成两个页并调整父节点,这是相当昂贵的操作。

LSM-Tree:追加写入

LSM-Tree 的思路完全不同:所有写入都是追加。新数据先写 WAL(保证持久性),再进内存里的 MemTable;MemTable 满了就整体刷成一个不可变的 SSTable 文件落到磁盘。磁盘上的文件从不原地修改。

这个设计把随机写变成了顺序写——对机械盘是数量级的性能差异,对 SSD 也显著减少写放大。写入吞吐因此远高于 B+Tree。

代价被转移到了三个地方:读放大、空间放大、写放大(由 compaction 引起)

二、LSM-Tree 的三个”放大”

这是理解 LSM 行为特征的关键,也是面试和线上调优的高频考点。

1. 读放大

一条记录可能存在多个 SSTable 文件里(每次更新都产生新版本)。查询时要从最新的 MemTable 开始,逐层往老的文件找,直到找到为止。层数越多,读一次可能要碰的文件数就越多。

两个标准缓解手段:Bloom Filter(快速判断”这个文件肯定没有这个 key”,直接跳过)和块缓存。这两个组件做得好不好,直接决定了一个 LSM 引擎的实际读性能。以 RocksDB 为例,这两个旋钮通常是调优的第一站:

// RocksDB:读放大治理的两个关键配置
options.optimize_filters_for_hits = true;  // 热点数据优先命中 Bloom Filter
options.bloom_locality = 1;                // 提高 filter 的缓存局部性

// BlockBasedTable 层面:缓存命中决定点查延迟
BlockBasedTableOptions table;
table.block_cache = NewLRUCache(4ULL * 1024 * 1024 * 1024); // 4GB 块缓存
table.filter_policy.reset(NewBloomFilterPolicy(10));        // 10 位/键
options.table_factory.reset(NewBlockBasedTableFactory(table));

2. 空间放大

同一条记录的多个版本、以及被删除记录留下的墓碑标记,都要等到 compaction(后台合并)时才被清理。这意味着实际占用的磁盘空间可以远大于有效数据量

规划容量时必须把这个系数算进去。写多读少、且更新频繁的业务,空间放大可能非常可观。

3. 写放大

compaction 要把多个 SSTable 读出来、合并排序、再写回去。同一条数据可能被反复读写多轮——这就是写放大:业务写了一份,磁盘上实际写了好几份。

这也是 LSM 系数据库延迟抖动的根源:compaction 是后台跑的,但它抢占 IO 和 CPU 资源。表现就是平时响应很快,每隔一段时间突然出现一批慢请求。对 SSD 来说,写放大还直接影响盘的使用寿命。

三、对比表

  • 写入吞吐:LSM-Tree 明显更高(顺序写);B+Tree 在随机写场景下受页分裂拖累。
  • 点查延迟:B+Tree 更稳定且可预测;LSM-Tree 平均更低但长尾明显(受层数与 compaction 影响)。
  • 范围查询:B+Tree 原生占优;LSM-Tree 需要跨多个文件归并,代价更高。
  • 空间占用:B+Tree 更紧凑;LSM-Tree 存在空间放大。
  • 读取一致性:B+Tree 读到的一定是最新值;LSM-Tree 要按层查找,依赖版本顺序。
  • 运维复杂度:B+Tree 相对”省心”;LSM-Tree 需要调 compaction 策略,是持续的调优工作。

四、对应到实际系统

理解了这个框架,再看具体产品就清楚了:

  • MySQL InnoDB 的聚簇索引是典型 B+Tree,因此它在读多写少、需要大量范围扫描和事务的 OLTP 场景下表现稳健。它的瓶颈在大量随机写入时的页分裂与刷盘压力。
  • RocksDB 是 LSM-Tree 的代表实现,被大量分布式系统用作存储引擎,适合写吞吐要求高、读以点查为主的场景。使用时绕不开 compaction 调优。
  • PostgreSQL 的堆表 + B+Tree 索引是另一种组合:数据存在堆里,索引是独立的 B+Tree。这个设计在更新频繁时会产生表膨胀(需要 VACUUM 清理),本质上也是一种”版本堆积”问题。

五、选型建议

不要问”哪个更好”,问下面三个问题:

1. 读写比例和访问模式是什么?

读多、范围查询多、要求延迟稳定→ B+Tree 系更省心。
写吞吐极高、以点查为主、能接受延迟抖动→ LSM-Tree 系更合适。

2. 有没有能力做持续调优?

这是最现实的一个问题。LSM-Tree 的性能高度依赖 compaction 策略与硬件匹配,需要有人持续看指标、调参数。没有这个人力,选 B+Tree 系会更稳。

3. 存储成本敏感吗?

如果数据量很大且预算敏感,LSM 的空间放大是实打实的成本,要按放大系数规划容量,不能按有效数据量算。

六、两个常见误解

误解一:LSM-Tree 写入快,所以什么都快

LSM 优化的是写吞吐,代价是读路径变长和后台 compaction 的资源占用。把它用在读密集、且对延迟稳定性要求高的场景,会得到比 B+Tree 更差的结果。

误解二:B+Tree 一定比 LSM 更占空间

通常 B+Tree 更紧凑,但B+Tree 也有碎片问题:大量删除和更新后,页内会出现空洞,需要重建表来回收空间。两类结构只是”放大”的表现形式不同——一个是版本堆积,一个是页内碎片。

七、小结

B+Tree 和 LSM-Tree 的分野,本质是把复杂度放在读路径还是写路径:B+Tree 保持了读的简单,把代价留给了随机写;LSM-Tree 把写变成顺序,把代价转移给读放大和后台合并。

近年也出现了不少混合结构的尝试(在 LSM 的某些层引入 B+Tree,或反过来),目的都是在两者之间找平衡点。但底层权衡没有变——复杂度不会消失,只会被搬走。理解它被搬到了哪里,就是理解一个存储引擎的开始。

标签

#存储引擎#B+Tree#LSM-Tree#计算机基础

进程、线程、虚拟线程、协程:四种并发模型的真实差异与选型表

进程、线程、虚拟线程、协程:四种并发模型的真实差异与选型表
关键词并发模型、虚拟线程、协程、线程池、上下文切换、计算机基础

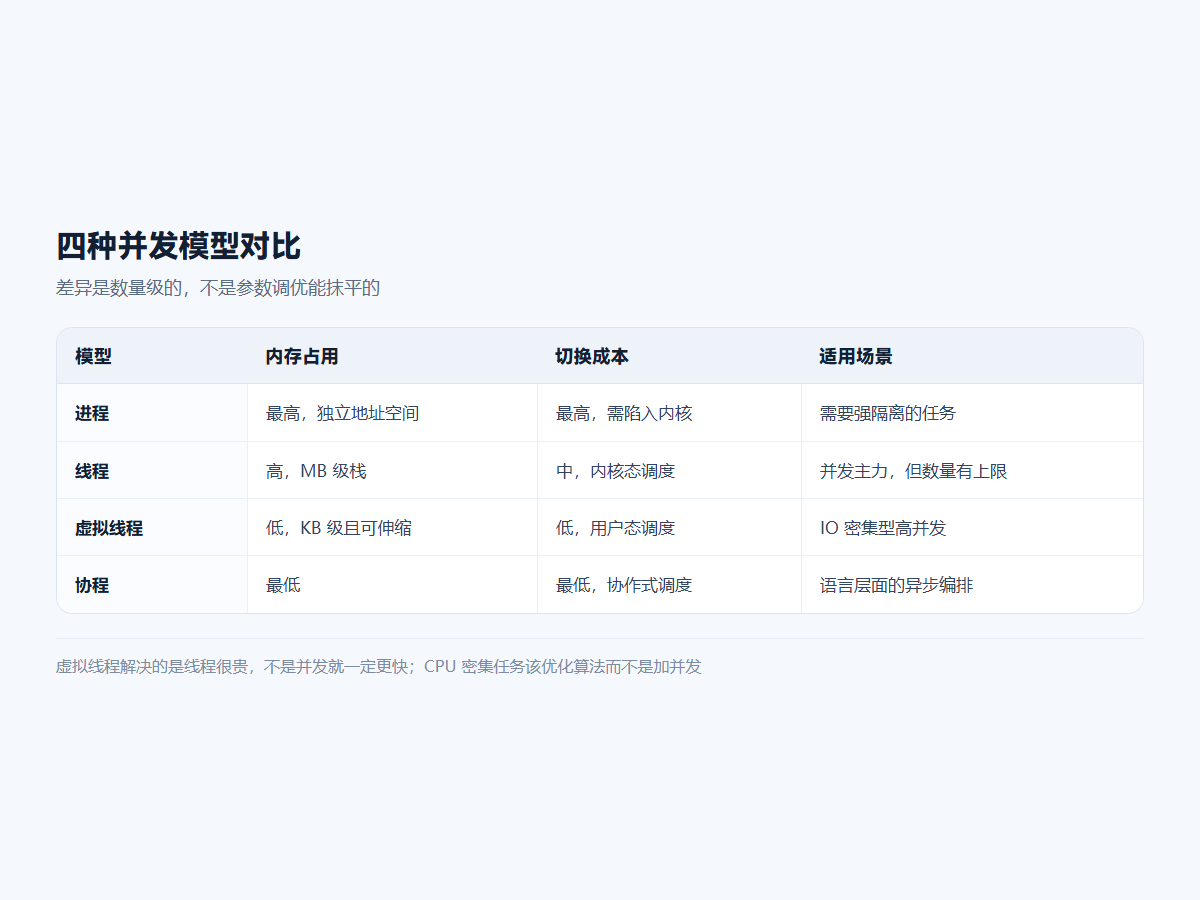
“并发”这个词底下至少藏着四套完全不同的模型:进程、线程、协程、虚拟线程。它们经常被混着讨论,但在内存占用、切换成本、适用场景上的差异是数量级的。

本文把这四层讲清楚,并给出一张可以按图索骥的选型表。

一、从最重的一层说起:进程

进程是操作系统分配资源的基本单位,拥有独立的虚拟地址空间。这意味着进程之间天然隔离——一个崩了不会带崩另一个,但也意味着:

  • 创建与销毁成本高:要分配独立的地址空间、页表、文件描述符表;
  • 上下文切换最贵:切换时要换页表基址,TLB 大概率全部失效,缓存命中率断崖下跌;
  • 通信必须走 IPC:管道、共享内存、Socket,没有共享变量这一说。

什么时候该用进程?答案是当你需要隔离性而不是并发度时:浏览器给每个标签页开独立进程、容器化部署里一个容器一个进程、数据库用多进程架构避免一个连接的 bug 拖垮整个实例。用进程换的是”故障隔离”和”安全边界”,不是性能。

二、线程:并发的主力,但有天花板

线程是CPU 调度的基本单位,同一进程的线程共享地址空间,因此创建成本比进程低得多,通信可以直接读写共享变量——代价是必须面对数据竞争

但线程有两个真实存在的天花板:

1. 内存占用

每个线程要预留独立的栈空间(典型值在几百 KB 到数 MB 量级)。这意味着开一万条线程,光栈就要吃掉几个 GB——还没跑业务逻辑。

2. 调度开销

线程是抢占式调度,由操作系统内核决定什么时候切走。线程数远超 CPU 核数时,大量时间花在上下文切换上:保存恢复寄存器、内核态与用户态往返、缓存污染。到了某个点,加线程反而会降低吞吐。

这也就是”万级并发连接”在传统线程模型下很难做的原因——不是写不出来,是每个连接一条线程的模型撑不住。

三、虚拟线程:把”线程很贵”这件事解决掉

虚拟线程(JDK 21 引入,在最新的 LTS 版本中已是成熟能力)的核心思路是:让大量虚拟线程复用少量操作系统线程

四种并发模型对比
进程、线程、虚拟线程、协程在内存占用、切换成本与适用场景上的对比

关键机制在于阻塞时的自动让出:虚拟线程执行到阻塞操作(等 IO、等锁、sleep)时,运行时会把它从载体线程上卸载下来,让载体线程去跑别的虚拟线程;等 IO 就绪了再挂回去继续。对写代码的人来说,这就是普通的同步代码。

这个设计的价值是:你可以用最简单的同步写法,获得接近异步框架的并发能力。不用回调、不用 CompletableFuture 链式编排、不用把业务逻辑撕成两半。

// 一万并发请求,写法和单线程一样直白
try (var executor = Executors.newVirtualThreadPerTaskExecutor()) {
    for (String url : urls) {
        executor.submit(() -> fetchAndProcess(url));
    }
}

但虚拟线程不是万能的,有两个明确的坑

  • CPU 密集任务没有收益:虚拟线程的收益来自”阻塞时让出”。如果任务一直在算,它就会一直占着载体线程,开多少虚拟线程都没用;
  • 下游资源池才是真瓶颈:把 Web 层换成虚拟线程后,并发请求全都压到数据库连接池上。池大小没变,等待只是从线程池搬到了连接池——这类”优化”经常查不出效果,原因就在这。

还有个容易被忽略的点:虚拟线程适合的是”阻塞式 IO 多的场景”,但它不会让 IO 本身变快。

四、协程:语言层面的协作式调度

协程和虚拟线程很像——都是”用户态的轻量级执行单元,复用少量系统线程”。核心区别在调度方式:协程是协作式的,需要代码显式让出执行权(比如 Kotlin 的 suspend、Go 的调度点在特定操作上)。

这带来两个实际差异:

  • 可控性更强:结构化并发(Kotlin 的 coroutineScope)让”一组并发任务的生命周期”可以被明确管理——父任务取消,子任务自动取消。这在写复杂异步流程时是很大的优势;
  • 需要显式配合:在协程里调用阻塞式 API 会占住底层线程,把协程的收益抵消掉。因此生态上要求配套的非阻塞库。

五、一张表选型

  • 进程:需要故障隔离、安全边界、或利用多机扩展。成本高,并发度低,换的是可靠性。
  • 线程(平台线程):CPU 密集计算的默认选择。数量应控制在与核数同量级,配线程池使用。
  • 虚拟线程:IO 密集、希望保持同步写法的服务端应用。改造成本极低,但要先确认下游资源池跟得上。
  • 协程:需要精细控制异步任务生命周期、或已在 Kotlin/Go 生态内。灵活但需要配套的异步库与团队共识。

六、三个常见误解

误解一:并发数越多越好

超过某个点之后,增加并发只会增加等待。正确的并发度应该由瓶颈资源决定:CPU 密集看核数,IO 密集看下游能承受多少并发。盲目加大并发数,是压测时把系统压垮的最快方式。

误解二:虚拟线程 / 协程能解决所有性能问题

它们解决的是”线程数量不再是并发上限“这一个问题。慢 SQL、不合理的数据结构、串行调用链、锁竞争——这些它一个都解决不了。先定位瓶颈,再选模型。

误解三:用了并发模型就不用管锁了

恰恰相反:共享可变状态的问题在虚拟线程和协程下依然存在,而且因为并发度上去了,竞争可能更激烈,低概率的竞态 bug 会从”偶尔出现”变成”经常出现”。要么用不可变数据,要么老老实实加锁或用并发容器。

七、小结

四层模型的本质差异,在于用什么代价换取什么能力:进程换隔离、线程换简单、虚拟线程换并发度、协程换可控性。

实际工程中,最常见的正确组合是:用多进程做部署级隔离,进程内用虚拟线程或协程处理 IO 并发,CPU 密集任务交给固定大小的线程池。搞清楚瓶颈在哪一层,比选哪个模型重要得多。

标签

#并发#操作系统#虚拟线程#计算机基础

零停机数据库迁移:expand-contract 模式与那些会锁表的操作

零停机数据库迁移:expand-contract 模式与那些会锁表的操作
关键词零停机迁移、数据库迁移、expand-contract、在线 DDL、锁表

数据库迁移是发布流程里最不可撤销的一环。代码发错了可以回滚,数据表改错了——尤其是删列、改类型这类操作——回滚意味着停机和数据抢救。

本文讲清零停机迁移的核心模式(expand-contract)、各类变更的安全步骤,以及那些”看起来无害但实际会锁表”的操作。

一、核心模式:expand → migrate → contract

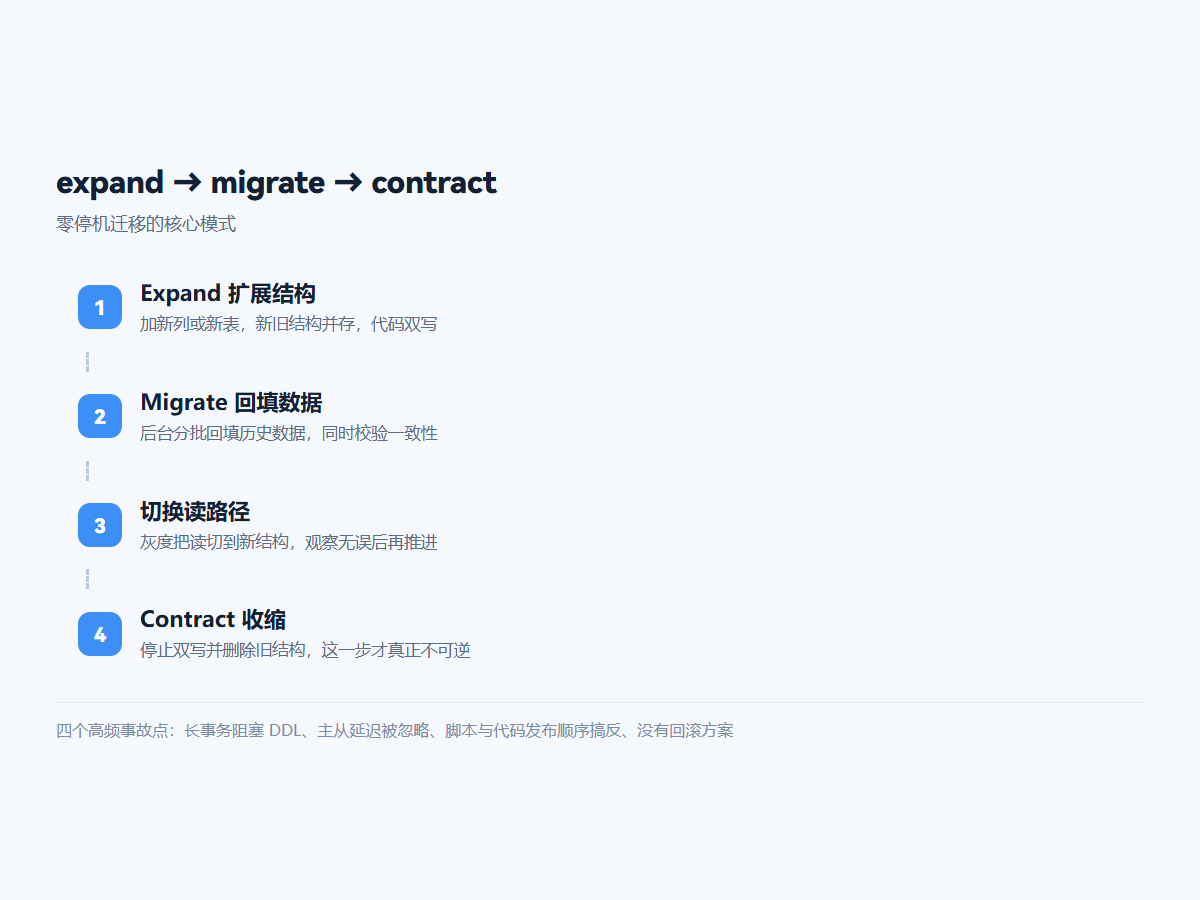
所有安全的数据库迁移,底层都是同一个模式:先把结构扩展成新旧兼容,再迁移数据,最后才收缩掉旧结构。

expand → migrate → contract
零停机迁移四步:扩展 → 回填 → 切读 → 收缩

关键在于每个阶段都可以独立部署和回滚,且中间态下新旧版本代码能同时正常工作。这就是为什么它必须拆成多次发布,而不是一次搞定。

二、逐类变更的安全步骤

1. 加字段:默认安全,但有两个例外

加一个可为空、有默认值的列,在主流数据库上通常很快。但下面两种情况会出事:

  • 加了 NOT NULL 且没有默认值:已有数据无法满足约束,直接失败;
  • 老版本数据库上给大表加带默认值的列:某些版本会触发整表重写,表越大锁得越久。

安全做法分两步走:

-- 第一步:先加可为空的列(快速,不锁表)
ALTER TABLE orders ADD COLUMN channel VARCHAR(32) NULL;

-- 第二步:回填历史数据,分批进行,控制单次影响行数
UPDATE orders SET channel = 'web' WHERE channel IS NULL LIMIT 5000;

-- 第三步:确认无 NULL 后,再加约束(按需,注意仍可能触发校验扫描)

注意第二步的分批回填:一次性更新几千万行会撑爆事务日志、拖垮主从同步。分批 + 每批之间留出间隔,是标准做法。

2. 改字段:几乎都要走”加新列”路线

不要想着直接 MODIFYALTER COLUMN TYPE。正确路径是:

  1. 加一个新列(新类型);
  2. 代码改成双写——同时写旧列和新列;
  3. 后台任务回填历史数据;
  4. 校验新旧列数据一致;
  5. 代码切到只读新列,观察一段时间;
  6. 代码停止写旧列
  7. 最后才删除旧列。

七步听起来繁琐,但每一步都可回退——这正是它值得的原因。合并成一步的结果是:出问题只能停机。

3. 删字段:先停写,再删

删除列的致命风险在于旧版本代码还在读它。发布期间新旧版本必然共存(滚动发布、灰度、多实例),因此顺序必须是:

  1. 代码完全移除对该列的所有读写引用,并发布;
  2. 确认所有实例都跑在新版本上,且监控中该列无任何查询;
  3. 等待一个足够长的观察期(覆盖最长可能的旧实例存活时间);
  4. 才执行 DROP COLUMN

一个实用技巧:删除前先把列改名而不是直接删掉(如 old_colold_col_deprecated_202609)。万一有遗漏的引用,改名会立刻报错暴露出来,而删除则会导致数据永久丢失。

4. 加索引:必须用在线方式

在大表上直接 CREATE INDEX阻塞写入,时间与表大小成正比。这是生产事故的高频来源。

-- PostgreSQL:并发建索引(不阻塞写入,但耗时更长且可能失败残留)
CREATE INDEX CONCURRENTLY idx_orders_channel ON orders(channel);

-- MySQL:InnoDB 的多数场景下在线 DDL 已较成熟,但仍需确认版本与算法
ALTER TABLE orders ADD INDEX idx_channel(channel), ALGORITHM=INPLACE, LOCK=NONE;

两个注意点:并发建索引失败会留下无效索引,需要清理后重试;另外它耗时更长,别在超时时间短的迁移脚本里跑。

5. 改表名 / 拆分表:用视图做过渡层

最稳妥的做法是建新表 → 双写 → 回填 → 切读 → 用视图兼容旧表名 → 最后下线。视图的作用是给还没来得及改造的旧查询留一个兼容层,把一次性切换变成可分批推进。

三、四个高频事故点

1. 长事务阻塞 DDL

一个跑了十分钟未提交的查询,就能让 DDL 等十分钟,进而阻塞后续所有对该表的请求。执行迁移前必须检查并清理长事务,同时给 DDL 设置合理的锁等待超时,避免它自己变成阻塞源头。

2. 主从延迟被忽略

在主库上分批回填,会造成大量 binlog/WAL,从库追不上。而很多读流量在从库上,用户会看到”数据一会儿有一会儿没有”。回填必须限速并监控主从延迟,超阈值就暂停。

3. 迁移脚本和代码发布顺序搞反

经典错误:先发代码(读写新列),再跑迁移(加新列)——中间那段时间全部报错。正确顺序永远是结构变更先行,代码变更随后,且结构变更必须是向后兼容的。

4. 没有回滚方案

每次迁移都要提前想清楚:这一步失败了怎么办?加列可以删列,回填可以清数据,但删列、改类型就很难回退。回滚难度高的操作,一定要先备份,且放在整个流程的最后一步。

四、执行清单

建议把下面这些固化成发布模板:

  1. 确认本次变更属于哪一类,套用对应步骤;
  2. 检查目标表大小、当前长事务、主从延迟基线;
  3. DDL 设置锁等待超时,避免阻塞扩散;
  4. 数据回填分批 + 限速,全程监控主从延迟;
  5. 按”结构 → 代码 → 数据 → 清理”的顺序推进,不合并步骤;
  6. 每步之间留出观察期,确认无异常再进下一步;
  7. 高危操作(删列、改类型)前置备份,放在最后执行;
  8. 全部完成后,清理废弃列、临时索引和兼容视图。

五、小结

零停机迁移的核心不是某个工具或命令,而是把不可逆操作拆成一串可逆的小步骤。这个思路的代价是发布周期变长——一次字段类型变更可能要跨两三个发布窗口。

但相比”一次上线导致半小时全站不可用”,这点时间成本几乎总是值得的。记住一句话:能加的先加,能晚删的晚删,中间态要能同时服务新旧代码。

标签

#数据库#迁移#DDL#工程实践

CI/CD 成本优化:把账单拆开,找到杠杆最大的四个动作

CI/CD 成本优化:把账单拆开,找到杠杆最大的四个动作
关键词CI/CD 成本、Runner 选型、构建缓存、Monorepo、工程效能

CI/CD 的问题很少出在”跑不起来”,而是出在跑得太贵、太慢,且没人说得清贵在哪。账单逐月上涨,构建队列越排越长,但每个改动看起来都很合理。

本文从成本结构出发,讲清托管 Runner 与自建 Runner 的真实账怎么算,以及几个杠杆最大的优化动作。

一、先把成本结构拆开

讨论”哪家便宜”之前,得先知道钱花在哪。CI 的成本基本由三块构成:

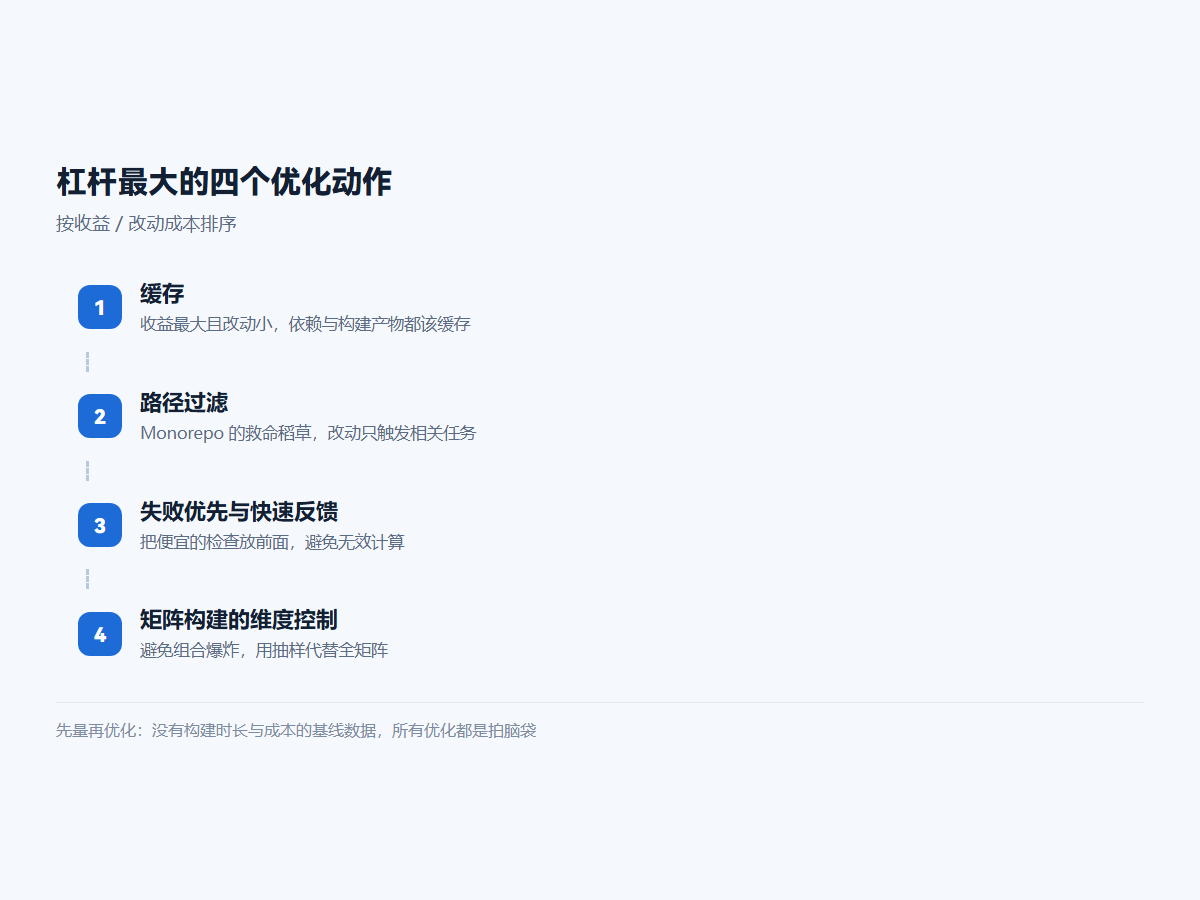
杠杆最大的四个优化动作
CI/CD 优化动作:缓存 → 路径过滤 → 失败优先 → 矩阵维度控制

1. 计算时间:最直观的一块

托管 Runner 按构建分钟数计费,且不同规格的机器系数不同(高核大内存机器通常是标准机的数倍系数)。这意味着把一个任务从 4 核挪到 16 核,价格不是线性增长,很容易在无意中把账单推高。

2. 并发数:最容易被忽略的隐性成本

很多人只盯着单价,忽略了并发额度。团队规模上来之后,真正卡住交付的不是单任务价格,而是队列等待——开发者提交后等 20 分钟才开始跑,这个成本远高于账单上多出的那点钱。

3. 存储与流量:缓存、制品、镜像

缓存、构建产物、容器镜像的存储与跨区流量,在规模上来之后会变成一笔可观的固定支出。尤其容器镜像仓库,如果没有清理策略,几个月就能堆到需要专门治理。

二、托管 Runner 还是自建?

这个问题没有普适答案,但有清晰的判断框架。

托管 Runner 划算的场景

  • 团队规模小、构建量波动大:按需付费天然适配波峰波谷,不用为闲置付费;
  • 没有专职运维:机器维护、镜像更新、安全补丁都不用管;
  • 构建环境标准化:依赖官方提供的运行环境,不需要特殊的系统级依赖。

自建 Runner 划算的场景

  • 构建量大且稳定:当月度分钟数超过某个阈值后,自建的边际成本优势会迅速显现;
  • 需要特殊硬件或内网资源:要连内网数据库做集成测试、需要 GPU、需要特定的操作系统;
  • 构建极重:大型 C++ / 移动端项目单次构建几十分钟,托管方案的性价比会明显下降;
  • 合规要求:代码与制品不能离开自有基础设施。

一个务实的判断方法

不要凭感觉决策。先导出过去三个月的构建分钟数、并发峰值、存储用量,按自建方案的机器成本 + 运维人力折算成月度总成本,再和托管账单对比。多数团队算完会发现:临界点在”每月几千到上万构建分钟”这个量级,低于它托管更省心,高于它自建更划算。

还有一条常见的最优路径是混合模式:常规任务跑托管,重任务(移动端打包、全量编译)跑自建。既控制运维面,又掐掉账单上最贵的那部分。

三、杠杆最大的四个优化动作

按投入产出比排序,前两项几乎总是值得做。

1. 缓存:收益最大,且改动小

CI 里最典型的浪费是每次都重新下载全部依赖。正确配置缓存后,很多项目的构建时间能砍掉一大半。

# 思路示例:以依赖清单的哈希作为缓存键
- uses: actions/cache@v4
  with:
    path: |
      ~/.npm
      node_modules
    key: deps-${{ runner.os }}-${{ hashFiles('**/package-lock.json') }}
    restore-keys: |
      deps-${{ runner.os }}-

关键点有两个:缓存键要绑定依赖清单的哈希(依赖变了缓存自动失效),以及配置 restore-keys 做前缀回退(依赖小改时仍能命中大部分缓存)。

2. 路径过滤:Monorepo 的救命稻草

Monorepo 里”改了前端却触发后端全量测试”是巨大的浪费。用路径过滤把变更范围和任务集关联起来

# 只有 packages/web 下有变更时才跑前端任务
- uses: dorny/paths-filter@v3
  id: changes
  with:
    filters: |
      web:
        - 'packages/web/**'
- if: steps.changes.outputs.web == 'true'
  run: npm run test:web

在大仓库上,这一项的收益经常超过所有其他优化的总和。

3. 失败优先与快速反馈

快且高失败率的任务放在最前面(lint、类型检查、单元测试),慢任务(端到端测试、打包)放后面。这样大部分错误能在几分钟内反馈,而不是让人等半小时才发现少了个分号。

# 取消同一分支上已被新提交取代的旧构建
concurrency:
  group: ci-${{ github.ref }}
  cancel-in-progress: true

4. 矩阵构建的维度控制

多版本 × 多平台的矩阵很容易膨胀。实用的做法是主流程只跑代表性组合(比如最新稳定版 + 最低支持版),完整矩阵放到定时构建里跑,而不是每次提交都跑全。

四、安全:三条必须守住的线

CI 是供应链攻击的高价值目标,这三条不能省:

  • 第三方 Action 固定到具体 commit SHA,而不是 tag。tag 可以被移动,SHA 不能;
  • 密钥通过平台的加密机制注入,绝不写进配置文件或代码。同时按环境拆分权限,生产环境的凭证不要对所有分支可见;
  • 限制 fork PR 的Runner权限,避免外部提交触发的构建拿到写权限或生产密钥。

五、可观测性:先量再优化

优化的前提是知道时间花在哪。最低要求是让流水线自己产出每个步骤的耗时统计,并跟踪几个趋势指标:P50/P95 构建时长、月度构建分钟数、缓存命中率、队列等待时长。

其中缓存命中率最值得盯——它一旦下滑,通常意味着依赖清单在无意识地频繁变动,或者有任务的缓存键写错了。

六、小结

CI/CD 的成本问题,本质上很少是”选错了平台”,而多是没有缓存、没有路径过滤、没有并发控制这三件事没做。把这三件做对,账单和构建时长通常都能有数量级的改善。

至于托管还是自建,拿三个月的历史数据算一遍再决定——这个计算本身花不了半小时,但能避免长期在错误的方向上省钱。

标签

#CI/CD#工程效能#成本优化#DevOps

鸿蒙应用上架前的四道坎:启动速度、包体积、功耗与审核合规

鸿蒙应用上架前的四道坎:启动速度、包体积、功耗与审核合规
关键词鸿蒙性能优化、启动速度、包体积优化、功耗优化、鸿蒙上架审核

把鸿蒙应用从”能跑”打磨到”能上架、且用户愿意留下来”,中间隔着四道坎:启动速度、包体积、功耗、审核合规。前三项决定体验,最后一项决定能不能上线。

本文按这四块给出可执行的优化动作与检查清单,偏实战,不讲规范条文。

一、启动速度:先量清楚,再动手

启动优化最容易犯的错是凭感觉改代码。第一步永远是拆分阶段并埋点:从用户点击图标,到首屏内容可见,中间经历的每一段都要能量化。

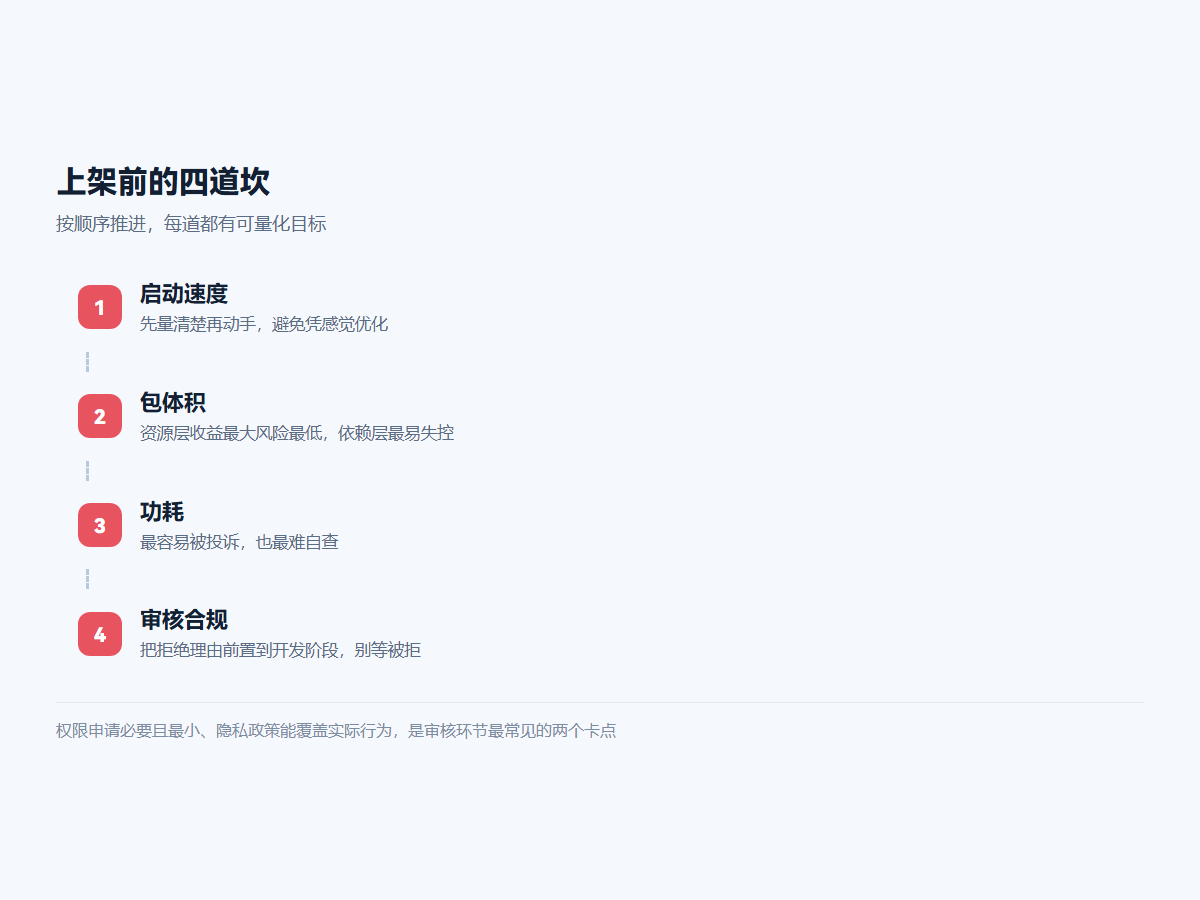
上架前的四道坎
鸿蒙应用优化四道坎:启动 → 包体积 → 功耗 → 审核合规

三个必须避开的坑

  • Ability 生命周期里做重活:把数据初始化、配置拉取、SDK 初始化全塞进启动回调,是最常见的启动变慢原因。正确做法是只初始化首屏必需的东西,其余的延迟到首屏渲染完成后的空闲时机;
  • 主线程做同步 IO:读本地大文件、同步查询数据库、同步网络请求——任何一项都能轻松吃掉几百毫秒。能异步的一律异步,首屏可以先展示缓存数据再做刷新;
  • 启动时集中初始化一堆 SDK:统计、推送、支付、广告……每个都不慢,加起来就很慢。建议做分级初始化:首屏必需 → 首屏后 → 按需触发。
// EntryAbility.onCreate:只做首屏必需的事
onCreate(want: Want, launchParam: AbilityStage.LaunchParam): void {
  this.parseRoute(want);          // 路由参数解析
  this.loadCriticalConfig();      // 首屏必需配置
  // 其余 SDK 分级延后:首帧后再跑,互不阻塞
  setTimeout(() => {
    initAnalytics();
    initPush();
    initPayment();
  }, 0);
}

可量化的目标

不要定”越快越好”这种目标。实用的做法是定 P95 而不是平均值:比如”冷启动到首屏可见 P95 < 1.5 秒”。平均值会把长尾问题藏起来,而长尾恰恰是留下差评的那批用户。

二、包体积:每减少 10MB 都有意义

包体积直接影响下载转化率,尤其是在移动网络下。优化动作按性价比排序:

1. 资源层:收益最大、风险最低

  • 图片压缩与格式替换:这是最立竿见影的一项。检查有没有未压缩的 PNG、有没有可以换成 WebP 的大图;
  • 清理无用资源:历史迭代留下的废弃图片、多套重复图标、没用上的多语言资源,往往能清出可观的体积;
  • 按分辨率分发:不要把所有分辨率的资源都打进同一个包。

2. 代码层:开启混淆与压缩

发布构建务必开启代码混淆与无用代码裁剪。这一步除了减小体积,还有额外的安全收益。要注意的是混淆规则清单要维护好——被反射调用的类、序列化用的模型类,都要加进保留列表,否则线上会出现难以定位的崩溃。

3. 依赖层:最容易失控的地方

每引入一个三方库,都要问一句”它带进来多少传递依赖“。建议定期做一次依赖审计:列出体积贡献 Top 10 的依赖,逐个评估是否真的需要、有没有更轻的替代品、或者能不能只引入需要的模块。

三、功耗:最容易被投诉,也最难自查

耗电问题通常在用户发现手机发烫、掉电变快后才被反馈到开发侧,而此时已经很难复现。因此功耗需要在开发阶段主动防范。

四大耗电源头

  • 后台频繁定位:能用一次性定位就不要持续定位,能降低精度就不要用高精度;
  • 高频定时任务:轮询改成推送,或者把多个定时任务合并对齐,减少系统被反复唤醒的次数;
  • 长连接保活策略过激:心跳间隔要在”及时性”和”唤醒次数”之间取平衡,不要为了秒级到达把心跳压到十几秒;
  • 动画与渲染失控:页面不可见时仍在跑的动画、没有正确释放的定时器,是很容易漏掉的耗电点。

自查方法

用 IDE 自带的性能分析工具看一段时间内的 CPU 占用与唤醒次数,重点看两个场景:应用退到后台后,以及页面长时间静置时。这两个场景下的异常占用,几乎都对应着真实的耗电投诉。

四、审核:把拒绝理由前置到开发阶段

上架被拒最浪费时间的地方在于反馈周期长。把这些高频拒绝原因在提审前自查一遍,能省下大量来回。

1. 权限申请必须”必要且最小”

申请了与功能无关的权限,是最常见的拒审原因。自查方法:逐个权限问”去掉它,核心功能还成立吗”,不成立才保留。同时,敏感权限必须在实际使用时动态申请,并说清楚用途,而不是一启动就全量索要。

2. 隐私政策要能覆盖实际行为

三个高频问题:隐私政策链接不可访问声明与实际收集行为不符第三方 SDK 的数据收集未在政策中说明。建议把接入的所有三方 SDK 列个清单,逐一核对它们是否收集数据、政策里有没有提到。

3. 功能完整性与稳定性

占位页面、点击无响应的按钮、明显的崩溃、以及测试账号无法登录——这些都会导致拒审。提审前用全新的真机环境完整走一遍主流程,尤其是登录和支付这类关键路径。

4. 内容与版权

使用了未授权的字体、图片、影音内容,或者应用内存在用户生成内容但缺少举报/审核机制,都会卡审核。字体是特别容易踩的一项——确认商用授权范围。

五、提审检查清单

建议固化成发布流程的一部分,每次提审前逐项打勾:

  1. 冷启动 P95 达标,且已在真机(非模拟器)上验证;
  2. 发布构建已开启混淆,混淆保留规则清单已归档;
  3. 无用资源与重复依赖已清理,依赖体积 Top 10 已审计;
  4. 后台 30 分钟内无异常 CPU 占用与频繁唤醒;
  5. 权限清单逐项核对”必要性”,敏感权限为运行时动态申请;
  6. 隐私政策可访问,且覆盖所有三方 SDK 的实际行为;
  7. 全新真机环境完整走通登录、支付、分享等主流程;
  8. 字体、图片、音视频素材的商用授权已确认;
  9. 提审材料(截图、描述、测试账号)与实际功能一致。

六、小结

这四块工作的共同点是:都能在开发阶段提前解决,拖到上线后再处理代价会成倍放大。启动速度和包体积影响用户愿不愿意留下,功耗影响用户会不会卸载,审核则决定能不能上线。

最值得投入的不是某项具体技巧,而是把上面那份检查清单固化进发布流程——让每次发版都机械地过一遍,比依赖某次专项优化靠谱得多。

标签

#鸿蒙#性能优化#HarmonyOS#上架

鸿蒙端侧 AI 能力拆解:三层边界、三条接入路径与四个约束

鸿蒙端侧 AI 能力拆解:三层边界、三条接入路径与四个约束
关键词鸿蒙端侧 AI、HarmonyOS AI、端云协同、ArkTS、AI 接入

“端侧 AI”在鸿蒙生态里是个被反复提及、但边界模糊的词。厂商演示里它能做很多事,落到具体项目上,开发者真正想知道的是:我能在 App 里用上哪部分?要用哪些能力?代价是什么?

本文把鸿蒙的 AI 能力拆成三层,讲清每层能做什么、不能做什么,并给出三条可落地的接入路径。

一、版本坐标

先对齐版本号,鸿蒙的版本体系比想象中更容易搞混。根据华为开发者联盟官方的开发套件版本总览(2026 年 8 月 29 日更新):

  • 26.0.0 —— 配套 DevEco Studio 26.0.0 Release,2026 年 8 月 28 日发布,官方标注为新开发应用推荐使用、已开发应用推荐升级
  • 6.1.1(24) —— DevEco Studio 6.1.1 Release,2026 年 5 月 26 日;
  • 6.1.0(23) —— 2026 年 4 月 20 日;
  • 6.0.0(20) —— 2025 年 9 月 25 日,官方同样标注为推荐版本。

格式上括号里的是 API 版本,前面是 HarmonyOS 版本。选型时的经验法则:以官方标注”推荐使用”的版本作为新项目的基线,不要为了尝鲜特性而把生产项目压在某个中间版本上。

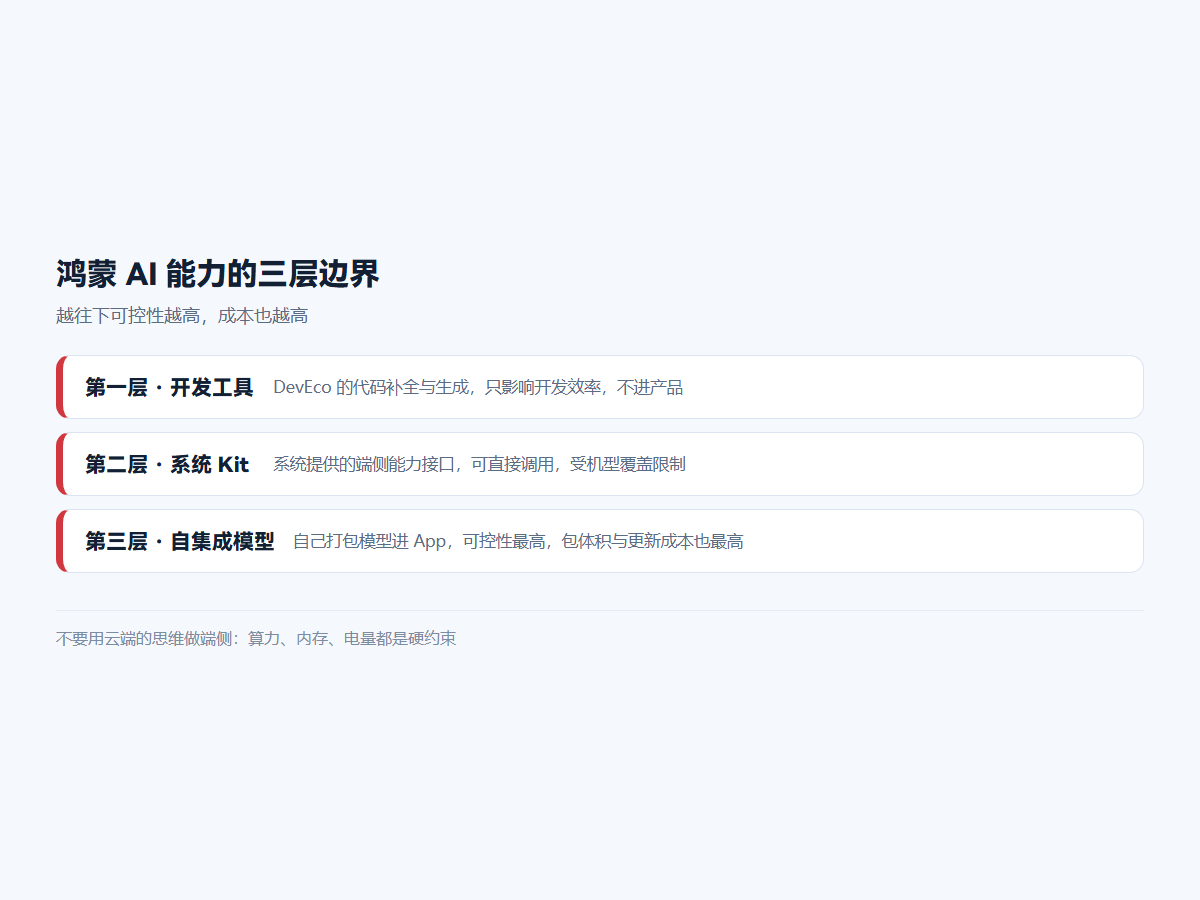
二、鸿蒙的 AI 能力分三层,别混为一谈

这是理解全局的关键。很多讨论把三层混在一起说,导致期待和实际对不上。

鸿蒙 AI 能力的三层边界
鸿蒙 AI 能力三层:开发工具层、系统 Kit 层、应用自集成层

第一层:开发工具层的 AI

这一层最成熟、也最容易被忽略——它提升的是开发者的效率,不是应用的能力

DevEco Studio 近几个版本在这块投入很大:自定义智能体(Agent)配置与调用、通过自然语言描述测试步骤自动在设备上执行 UI 操作并验证结果的 UI Verification(26.0.0 Beta 起)、以及动态效果分析等。IDE 内还支持切换不同模型来驱动代码生成与智能问答。

实际价值:把重复性的 UI 回归测试和样板代码生成交给工具。这一层对任何鸿蒙项目都适用,且没有兼容性负担——它不改变你的产物。

第二层:系统 Kit 能力

这是”系统已经做好、应用直接调用”的部分,比如语音、视觉、文本理解相关的系统级 Kit。好处是无需自带模型、包体积不涨、功耗由系统统一优化;限制是能力边界由系统定义,你只能用它提供的那些。

接入前要做的功课是核对能力清单与覆盖机型——系统能力的可用性和设备硬件、系统版本强相关,必须在真机上验证,不能只看文档。

第三层:应用自集成模型

自由度最高、成本也最高的一层:自己把模型打进应用,在端侧跑推理。适合有定制需求、或不能把数据送出设备的场景。

这一层要自己解决三件事:模型体积与包体积的平衡、推理性能与功耗、以及模型更新机制。这三个问题都不是”接个 SDK”能解决的,需要实际的工程投入。

三、三条可落地的接入路径

按投入从低到高排列,建议依次评估,能用低成本方案满足就不要上高成本方案。

路径一:只用来提效,不进产品

先用 DevEco Studio 的智能体与自动化验证能力,把开发流程里的重复劳动砍掉:样板代码生成、UI 自动化回归、代码解读。

适合:所有团队,尤其是刚切到鸿蒙、还在熟悉 ArkTS 的团队。零风险,投入产出比最高。

路径二:调用系统 Kit 做能力增强

在应用里接入系统提供的 AI 能力,做诸如智能识别、语音交互、文本处理这类功能。关键点是把降级路径设计好:能力不可用时(老机型、系统版本低)必须有非 AI 的兜底流程,否则会变成大面积功能不可用。

适合:希望”有 AI 功能”但不愿承担模型成本的大多数业务应用。

import { brainInterface } from "@kit.NaturalLanguageKit";

// 系统能力调用的标准形态:先探测能力,再使用,最后留兜底
async function summarize(text: string): Promise<string> {
  if (!brainInterface.canIUse()) {
    return ruleBasedSummary(text);   // 老机型/低版本:非 AI 兜底
  }
  const session = await brainInterface.createSession();
  try {
    return await session.processText(text, { task: "summarize" });
  } finally {
    session.release();               // 会话及时释放,避免占用推理资源
  }
}

路径三:自集成端侧模型

只有在这几种情况才该走这条路:数据不能出设备(隐私或合规要求)、需要离线可用、或系统 Kit 覆盖不了你的定制需求

工程上必须提前规划:

  • 模型量化与裁剪:原始模型直接塞进 App 通常不可接受,量化后的精度损失要在业务上可容忍;
  • 按需下载:把模型放在首次使用时下载,而不是打进安装包;
  • 推理放在非主线程:主线程跑推理会直接卡 UI,这是新手最常犯的错;
  • 功耗与发热:持续的端侧推理是耗电大户,要有明确的触发时机和频次控制。

四、四个必须提前想清楚的约束

1. 机型覆盖是硬约束

端侧 AI 能力(尤其是依赖 NPU 加速的部分)与设备硬件强绑定。旗舰机型能跑的能力,中低端机型可能直接不可用或慢到无法接受。做功能设计时必须先确认目标用户群的设备分布。

2. 不要用云端的思维做端侧

从云端 API 切到端侧推理,最大的思维转变是延迟模型完全不同:云端是”网络往返 + 排队”,端侧是”稳定的本地计算但受算力限制”。很多在云端合理的交互设计(比如逐字流式输出),在端侧可能因为首字延迟过高而体验崩坏。

3. 模型更新比想象中麻烦

云端模型改一版,所有用户立刻生效;端侧模型改一版,要面对版本碎片化——总有一部分用户停留在旧模型上。设计时必须让后端能感知客户端的模型版本,并做兼容处理。

4. 合规与隐私声明

端侧处理是隐私优势,但不等于没有合规义务。数据如何在设备本地处理、是否上传、模型本身是否涉及第三方授权,这些都要在隐私政策和上架材料中说清楚。

五、小结

鸿蒙的 AI 能力不是单一功能,而是从开发工具到系统能力再到自集成模型的三层结构。绝大多数项目应该止步于前两层——用 IDE 的 AI 提效、用系统 Kit 做功能增强——因为第三层的工程成本是数量级上的跃升。

真正需要自集成模型的,只有那些数据不能出设备、或必须离线可用的场景。把边界划清楚,能省下大量不必要的投入。

标签

#鸿蒙#端侧 AI#HarmonyOS#AI 应用

Android 17 与 iOS 27 适配指南:破坏性变更与一份可执行的检查清单

Android 17 与 iOS 27 适配指南:破坏性变更与一份可执行的检查清单
关键词Android 17、iOS 27、target SDK、Compose、SwiftUI、移动适配

2026 年下半年对原生开发者来说是个忙碌的窗口:Android 17 已经 GA,iOS 27 即将发布,两端的 target SDK 硬性截止日期同时生效。这不只是”升个版本号”,而是一批会真正改变 App 行为的破坏性变更。

本文把两端的现状、必须处理的破坏性变更,以及一份可执行的适配清单整理出来。

一、版本坐标与截止日期

Android 侧

  • Android 17(API 37,代号 Cinnamon Bun)已于 2026 年 6 月 16 日发布正式版并推送 AOSP;
  • Google Play 要求新应用和应用更新将 targetSdk 提升到 36 及以上(2026 年 8 月 31 日起);
  • Android 16(API 36)仍是当前覆盖面最广的版本,占比领先。

iOS 侧

  • iOS 26.6.1 是当前绝大多数用户在跑的版本;
  • iOS 27 已完成多轮开发者与公开测试,正式版预计 2026 年 9 月中旬随新机发布;
  • App Store Connect 自 2026 年 4 月 28 日起,已拒绝非 iOS 26 SDK / Xcode 26 及以上构建的上传——这条已经生效,不是预告;
  • Xcode 27 目前处于 beta 阶段,且要求 Apple 芯片。

换句话说:Android 这边的 target 36 是刚生效的硬门槛,iOS 那边的 SDK 门槛也已经落地。还在旧版本上拖着的团队,上传时间窗口已经很紧了。Gradle 侧的一行核对:

// app/build.gradle.kts —— targetSdk 36 是 2026-08-31 起的商店硬门槛
android {
    compileSdk = 37          // 用 Android 17 SDK 编译,提前暴露行为变更
    defaultConfig {
        targetSdk = 36       // 商店要求;升 37 前先过完行为变更回归
    }
}

二、Android 17:最需要注意的破坏性变更

Android 17 的变更清单很长,下面这几项是最容易在生产上出事故的。

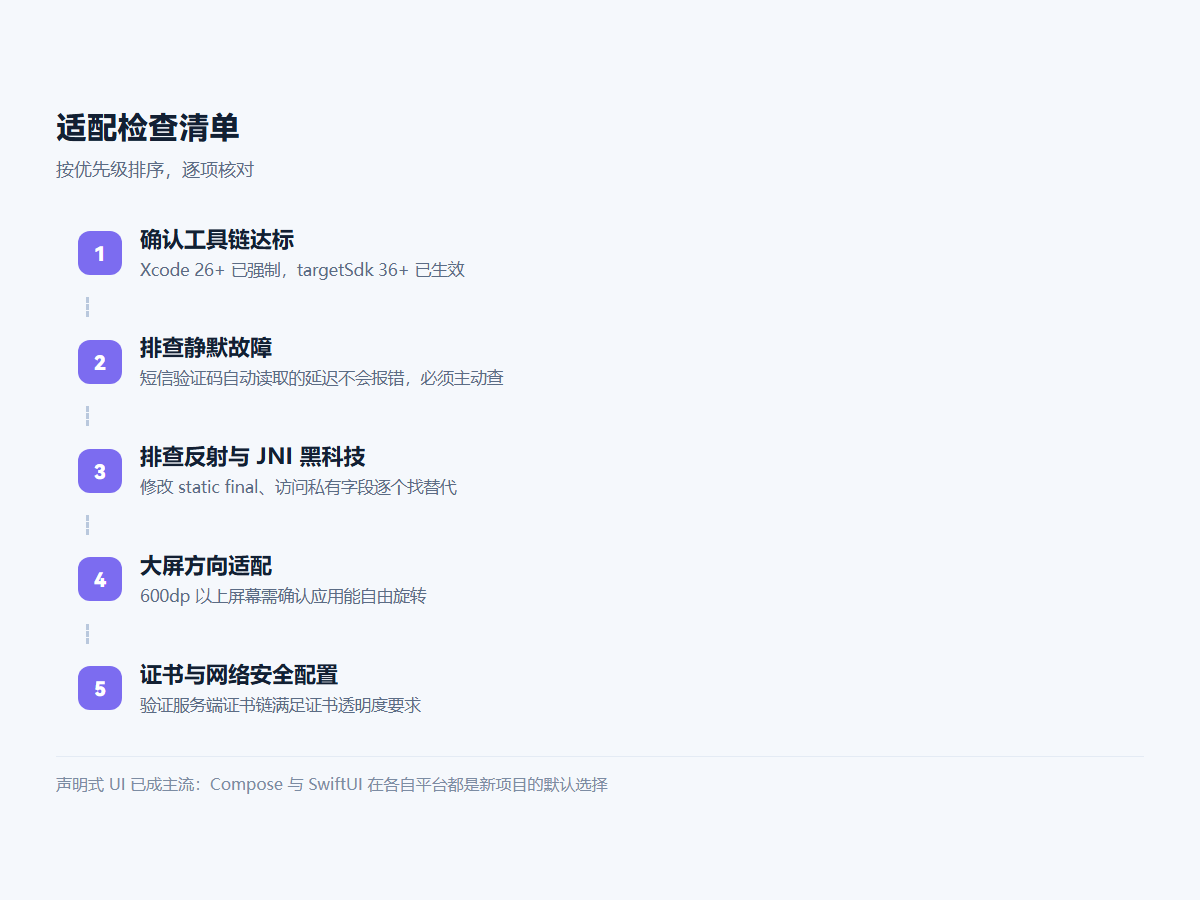
适配检查清单
原生适配清单:工具链 → 静默故障 → 反射黑科技 → 大屏 → 证书

1. 大屏方向锁定被移除

在 API 36 上还可以选择退出大屏适配,API 37 起这个 opt-out 被移除:面向 API 37 的应用在 600dp 及以上的屏幕上必须支持自由方向调整。

影响面:POS、自助终端、数字标牌这类硬编码横竖屏的应用,必须先改成自适应布局才能升 target。这不是配置项,是实际的开发工作量。

2. 短信验证码延迟约 3 小时

面向 API 37 的应用,读取标准短信 OTP 会有约 3 小时的延迟(SMS Retriever API 豁免,WebOTP 对所有应用生效)。

这条杀伤力极大:凡是自动读取短信验证码完成登录/激活的流程,都会静默失效。这类功能往往没有埋点,等客服收到投诉才发现。排查建议:全局搜索验证码自动填充相关代码,优先迁到 SMS Retriever API 或其他验证方式。

3. 证书透明度默认开启

面向 API 37 的应用默认启用证书透明度校验,要求证书带有足够的 Signed Certificate Timestamp。自建证书体系、企业内网代理、部分老旧的支付/认证 SDK 都可能受影响。

4. 反射与 JNI 的限制收紧

static final 字段不能再通过反射或 JNI 修改。这条会精准打击一批”黑科技”库——热修复、某些插件化框架、以及部分通过反射改系统行为的兼容库。升级前务必把这类依赖排查一遍。

5. 其他值得登记的项

  • MessageQueue 改为无锁实现,反射其私有字段的代码会失效
  • 蓝牙 RFCOMM socket 断开时返回 -1,不再抛 IOException依赖异常捕获的读取逻辑要改判返回码
  • 本地网络权限从可选变为强制
  • 应用内存上限对所有应用生效,不再区分 targetSdk;
  • 面向 API 37 的应用 Keystore 密钥上限收紧到 5 万(其他为 20 万)。

三、iOS 27:适配重点

1. Liquid Glass 的延续

iOS 26 引入的 Liquid Glass translucent 设计语言在 27 上延续并细化。用新 SDK 构建的应用会自动继承这套观感,除非显式退出。这意味着:

  • 自定义 UI 组件需要重新审一遍,避免和系统半透明控件摆在一起显得突兀;
  • 图标和截图建议在新系统上重新核对, translucent 背景下的问题在截图上是看不出来的。

2. Siri 的上下文感知

新的 Siri 能够理解当前屏幕上在做什么、并触发应用内动作。这让 App Intents 从”锦上添花”变成了”分发入口”——用户通过 Siri 触达你的功能,不再需要先找到 App 再点进去。

3. 其他需要回归的点

  • RCS 消息支持内联回复与更可靠的投递,跨平台的会话线程要重测;
  • Wallet Insights 提供消费摘要,涉及钱包集成的应用要看新数据类型;
  • 家长控制颗粒度更细,儿童类和家庭类应用面临新的审核标准

四、声明式 UI 现状:Compose 与 SwiftUI

两端的主流都已经彻底转向声明式,但成熟度曲线不同。

Jetpack Compose

已经完全稳定且是官方推荐路径,新建项目默认就是它。Material 3 Expressive 在 Android 17 上成为新的视觉默认。对老项目,Compose 与 View 系统可以互操作,支持逐个界面渐进替换,这一点做得很友好。

SwiftUI

能力逐年补齐,但在复杂列表性能、精细动画控制、以及某些系统控件的深度定制上,很多团队仍会退回 UIKit。现实的主流做法是混合开发:新界面用 SwiftUI,复杂或性能敏感的模块保留 UIKit,两端通过 UIViewRepresentable 之类的桥接互相嵌入。

一个实用建议:不要为了”纯 SwiftUI”而重写已经稳定的 UIKit 模块。迁移的收益应该来自新界面的开发效率,而不是架构洁癖。

五、适配清单

按优先级排序,前四项是硬门槛:

  1. 确认构建工具链达标:Xcode 26+ 已强制,Android 侧 targetSdk 36+ 已生效。工具链不达标的直接卡在上传环节;
  2. 全局搜索短信验证码自动读取:Android 17 的 3 小时延迟是静默故障,必须主动排查;
  3. 排查反射与 JNI 黑科技static final 修改、MessageQueue 私有字段访问,逐个列出替代方案;
  4. 大屏方向适配:如果目标设备包含 600dp 以上屏幕,确认应用能自由旋转;
  5. 证书与网络安全配置:验证服务端证书链满足证书透明度要求;
  6. 蓝牙读取逻辑改判-1 返回码优先于异常捕获;
  7. Liquid Glass 视觉回归:iOS 侧在真机上过一遍主要界面;
  8. App Intents 补齐:至少覆盖核心功能,为 Siri 分发留出入口。

六、小结

这一轮平台更新的共同特点是:破坏性变更集中在”以前能偷偷绕过”的地方——反射改字段、静默读短信、锁定屏幕方向、绕过证书校验。这些做法在过去能跑,现在要么被禁止,要么被默认安全策略拦下。

因此适配工作的重点不是”学新 API”,而是把项目里那些依赖历史宽松行为的角落翻出来。建议尽早开一个适配分支,用新 target 跑完整回归,把问题列成清单逐项清——这类问题几乎不可能靠”升完再说”侥幸躲过。

标签

#Android#iOS#适配#移动端

Kotlin Multiplatform 2026:被低估的第三条跨端路线

Kotlin Multiplatform 2026:被低估的第三条跨端路线
关键词Kotlin Multiplatform、Compose Multiplatform、跨端方案、KMP、移动端架构

跨端方案的讨论长期被 Flutter 和 React Native 占据,但 2026 年真正值得重新评估的,是第三条路:Kotlin Multiplatform(KMP)+ Compose Multiplatform

它和前两者的根本区别在于:不接管 UI,而是共享逻辑。这个看似保守的定位,恰恰让它在很多场景下比”全栈跨端”更容易落地。

一、版本坐标

截至 2026 年 9 月:

  • Kotlin2.4.10 为当前正式版(2.4.20 已进入 RC 阶段);
  • Compose Multiplatform:Gradle 插件 1.12.0 为当前正式版;
  • Android:Android 17(API 37)已于 2026 年 6 月发布;
  • iOS:iOS 26.6.1 为当前在跑版本,iOS 27 预计 9 月中旬发布。

Kotlin 版本可在 JetBrains/kotlin 的 Release 页面核对,注意 RC / Beta 版本不要进生产。

二、KMP 到底共享了什么

这是最容易被误解的地方,先讲清楚边界。

三种跨端路线对比
Flutter / React Native / KMP 在共享范围、渲染方式与迁移成本上的差异

共享层:业务逻辑,不是 UI

KMP 的核心思路是:把不依赖平台 API 的部分抽到 commonMain,包括数据模型、网络请求、缓存、业务规则、状态机、校验逻辑。这些代码编译到各平台:JVM 字节码(Android)、原生二进制(iOS)、JS/Wasm(Web)。源集结构一目了然:

shared/
├── src/
│   ├── commonMain/kotlin/      // 平台无关:模型、仓库、业务规则
│   │   └── com/app/core/
│   │       ├── OrderRepository.kt   // 期望声明 expect
│   │       └── Pricing.kt           // 纯 Kotlin,两端直接复用
│   ├── androidMain/kotlin/     // actual 实现:Room、Android SDK
│   └── iosMain/kotlin/         // actual 实现:NSData、Keychain
└── build.gradle.kts            // 目标:androidTarget() + iosArm64()/iosSimulatorArm64()

// commonMain 中声明平台差异点,各端提供 actual 实现
expect fun persistToken(token: String)

UI 部分各平台各写各的——Android 用 Compose,iOS 用 SwiftUI 或 UIKit。这是刻意的取舍:牺牲一部分代码复用率,换取完全原生的观感和平台能力接入。

Compose Multiplatform:可选的 UI 共享

如果你愿意连 UI 一起共享,Compose Multiplatform 允许用同一套 Compose 代码渲染到 Android、iOS、桌面和 Web。但要注意:

  • Android 端是原生 Compose,观感和性能没有问题;
  • iOS 端走的是自绘,本质上是把 Compose 的渲染树画到 Canvas 上,与 SwiftUI 的观感差异需要设计和测试双重确认;
  • 与原生 UI 混排是可行的(在 SwiftUI 里嵌入 Compose 视图,或反过来),这也是很多团队采用的渐进路线。

三、和 Flutter / RN 的真实对比

不比”谁更快”,比的是三条不同的取舍路径

Flutter:自绘一切

优点是各端观感高度一致、性能上限高;代价是与原生 UI 混排成本高,且任何平台新特性都要等框架适配。适合”全新应用、UI 高度定制、追求多端一致”的场景。

React Native:桥接原生控件

优点是有 Web 团队就能上手、生态庞大;代价是桥接层的性能与调试复杂度,深度原生能力接入时仍要写 Native Module。适合”团队以 JS 为主、应用以常规 UI 为主”的场景。

KMP:共享逻辑,UI 原生

优点是UI 完全原生、与既有原生代码零摩擦、可渐进接入;代价是需要同时具备 Android 和 iOS 两端的 UI 开发能力,代码复用率低于前两者。适合”已有成熟原生应用、想消除逻辑层重复实现”的团队。

四、什么场景最适合 KMP

说实话,KMP 不是”全新小应用”的最优解——那种场景 Flutter 更快。它真正发光的场景是下面三个。

1. 已有成熟原生应用,想收敛逻辑重复

典型的痛点是:同一套业务规则在 Android 和 iOS 各实现一遍,然后bug 也各出一遍,且两边行为微妙不一致。把规则层抽到 KMP,UI 保持原生,是收益最高、风险最低的切法。

2. 需要深度平台能力

如果应用重度依赖相机、蓝牙、后台定位、系统级小组件这类能力,保持原生 UI + 共享逻辑远比”用跨端框架再写一堆桥接”省事。

3. 渐进式改造,不能推倒重来

KMP 可以只引入一个模块——先把网络层或数据层换掉,跑顺了再逐步扩散。这个特性决定了它可以被塞进任何既有工程,不需要”全有或全无”的赌注。

五、落地前必须想清楚的三件事

1. iOS 端的集成与调试体验

KMP 编译产物以 Framework 形式接入 Xcode 工程。调试跨语言栈时体验不如纯原生顺滑,断点跳转、崩溃符号化都需要额外配置。团队里如果没人熟悉 Xcode 工程配置,这一步会卡很久。

2. 并发模型差异

Kotlin 协程与 Swift Concurrency 是两套模型,跨边界传递异步结果时要格外小心。常见坑是在共享层暴露挂起函数,Swift 侧回调处理不当导致线程错乱或内存泄漏。建议在边界上定义清晰的同步接口,把并发复杂度留在各自平台内。

3. 团队技能结构

KMP 要求团队同时有 Kotlin 能力和两端原生 UI 能力。如果 iOS 侧无人,这条路走不通——共享出来的逻辑没人接,等于白做。

六、小结

KMP 的价值主张不是”写一次到处跑”,而是”把该共享的共享掉,该原生的保持原生“。它的复用率数字不如 Flutter 好看,但落地摩擦也小得多。

如果你的现状是”两个成熟原生应用,逻辑重复实现,bug 双倍”,那 KMP 大概率是 2026 年最值得评估的方案。如果是全新小应用,那还是先看看 Flutter。

标签

#Kotlin#KMP#跨端开发#移动端