loader

Nerio News Magazine brings you trusted, timely and thought-provoking stories from around the globe.

Follow Us

消息队列怎么选:四种架构范式的根本差异与一棵决策树

消息队列怎么选:四种架构范式的根本差异与一棵决策树
关键词消息队列选型、Kafka、RocketMQ、Pulsar、Redis Streams、架构设计

“我们该用哪个 MQ?”这个问题在 2026 年并没有变得更容易——因为可选方案变多了,而它们的架构差异是根本性的,不是参数调优能抹平的

本文不打算给出”XX 最好”的结论,而是把四个主流方案的底层取舍讲清楚,再给一棵可以直接用的决策树。

一、版本坐标

截至 2026 年 9 月,从 Maven Central 元数据核对到的正式版本:

  • Apache Kafkakafka-clients 4.3.1
  • Apache Pulsarpulsar-client 4.2.4
  • Apache RocketMQrocketmq-client-java 5.2.2
  • Redis(Streams):服务端最新稳定为 8.10.1

注意客户端版本和服务端版本是两回事,跨大版本的客户端/服务端混用要查兼容矩阵,别只看客户端版本号。

二、先分清两类根本不同的架构

很多人把 MQ 选型理解成”比吞吐量”,这是个误区。真正的分水岭在第一层:
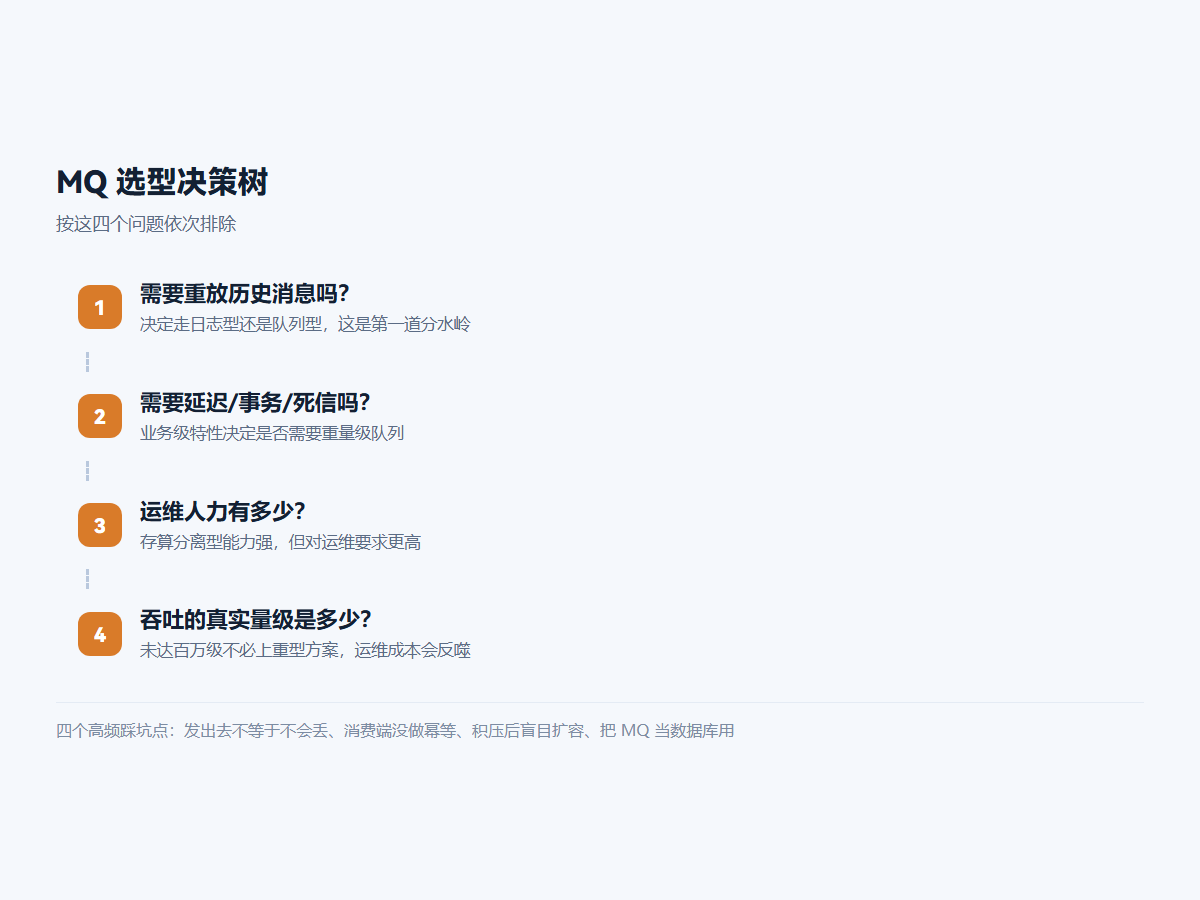
MQ 选型决策树
消息队列决策树:重放 → 高级特性 → 运维人力 → 真实吞吐

1. 日志型(Kafka 为代表)

本质是append-only 的分布式日志。消息写入后按偏移量顺序堆积,消费端自己维护读到哪儿。这个设计带来三个直接后果:

  • 消息可重放:出问题可以回到任意偏移量重跑,这是流式处理和事件溯源的基石;
  • 多消费者互不影响:不同消费组各读各的,新增一个消费者不会影响已有的;
  • 吞吐量极高:顺序写盘 + 零拷贝,硬件能跑多快它就能接近多快。

代价是:单条消息的确认、重试、延迟投递这些”业务友好”的能力,都要自己在应用层搭

2. 队列型(RocketMQ、RabbitMQ 为代表)

本质是带状态的消息服务。服务端维护每条消息的状态(已发送/已消费/需重试),提供延迟消息、事务消息、消费重试、死信队列这些开箱即用的语义。

代价是:服务端要维护状态,横向扩展和重放能力就不如纯日志型灵活,重放一条历史消息通常没那么顺手。

3. 计算存储分离型(Pulsar)

Pulsar 的架构是Broker 无状态 + 存储独立(BookKeeper)。它想同时拿到日志型的重放能力和队列型的扩展弹性:扩 Broker 不用搬数据,扩存储不用动 Broker。

代价是运维复杂度上升——你要同时理解并维护两套组件。团队规模不够时,这个复杂度会变成负担。

4. 轻量型(Redis Streams)

如果消息量不大、允许一定丢失、且已经重度使用 Redis,Streams 是成本最低的选择——不引入新组件,运维成本几乎为零。

但它不是为”关键业务消息”设计的:持久化策略、容量规划、积压处理都要自己兜底,数据量一大就会跟主 Redis 抢资源。适合通知、轻量级异步任务这类场景。

三、决策树:按这四个问题依次排除

按顺序问自己,前一个问题往往就能直接排除掉一半选项。

问题 1:需要重放历史消息吗?

需要(事件溯源、流处理、下游重建缓存)→ 排除 Redis Streams,Kafka / Pulsar 优先。
不需要(纯任务分发)→ 四个都能选,继续下一问。

问题 2:需要延迟消息 / 事务消息 / 死信队列吗?

需要,且希望开箱即用→ RocketMQ 是这一层的强项,Kafka 需要自己在应用层搭延迟队列(通常靠时间轮 + 分级 topic)。
不需要,或愿意自己实现→ 继续。

问题 3:运维人力有多少?

这是最诚实的一个问题。没有专职运维、团队规模小→ 优先考虑云厂商托管版,或直接用 Redis Streams。自建 Kafka 集群能跑起来和能稳定跑三年,是两件完全不同的事。
有专职 SRE→ Kafka、Pulsar 都能考虑。

问题 4:吞吐量的真实量级是多少?

很多团队高估了自己的量级。日均百万级以下的,四个方案在性能上都不构成瓶颈,选型应该完全由”语义需求 + 运维成本”决定。
日均亿级以上,或者需要对接 Flink 等流计算生态 → Kafka 的生态优势难以替代。

四、四个高频踩坑点

1. 以为”消息发出去了”就等于”不会丢”

默认配置下,生产者发送成功只代表消息到了 Broker 内存,未必落盘。要真的不丢,生产端要配 acks 策略、服务端要配多副本同步、消费端要先处理业务再提交位点——三处都得对:

# Kafka 生产端:all 表示等所有 ISR 副本确认才算发送成功
acks=all
enable.idempotence=true          # 幂等生产者,防重试导致的乱序重复
retries=2147483647

# 服务端:topic 副本与最小同步副本
replication.factor=3
min.insync.replicas=2            # 与 acks=all 配合,容忍一台副本故障

// 消费端:先落库再提交位点,配合幂等键防重复
while (records := consumer.poll()) {
    db.tx { saveAll(records) }   // 业务与幂等键同一事务
    consumer.commitSync()        // 处理完才提交
}

2. 消费端没有做幂等

分布式消息系统提供的是”至少一次“语义,重复投递是常态而非异常。消费端必须能容忍重复:唯一键去重、状态机校验、或者业务本身幂等。这一条几乎是所有线上消息事故的根源。

3. 积压后盲目扩容消费者

Kafka 这类分区模型下,消费者数量超过分区数就不会再提升并行度。扩容前先看分区数,否则加多少实例都是白加。

4. 把 MQ 当数据库用

消息堆积几千万条还指望快速回溯查询、或者把业务状态只存在消息里——这类用法会在某个凌晨反噬。MQ 是传输通道,不是存储系统。

五、一张表总结

  • Kafka:吞吐与生态最强,重放能力原生;业务语义要自己搭,运维门槛高。适合日志、埋点、流处理、事件溯源。
  • Pulsar:计算存储分离,弹性最好,多租户原生;组件多、运维复杂。适合多租户平台、需要弹性的中大型场景。
  • RocketMQ:业务语义最全(事务、延迟、死信),Java 生态亲和;国际生态相对弱。适合交易、订单等强语义业务。
  • Redis Streams:零新增组件,成本最低;可靠性与容量有限。适合轻量级异步、通知、已有 Redis 的小团队。

六、小结

选型的本质不是比参数,而是匹配架构假设:你需要重放吗?需要服务端维护消息状态吗?运维能扛几套组件?真实量级是多少?

对大多数团队,我的实际建议是:先用云厂商托管版跑起来,把业务语义和幂等做对,等量和复杂度真的上来了,再考虑自建和迁移。过早为”未来可能的量级”付出架构复杂度,是这一领域最常见也最贵的浪费。

标签

#消息队列#Kafka#RocketMQ#后端架构
Spring Boot 4 与 Spring AI 2:三层同时换代时的升级顺序与避坑清单

Spring Boot 4 与 Spring AI 2:三层同时换代时的升级顺序与避坑清单
关键词Spring Boot 4、Spring AI 2、JDK 25、虚拟线程、Java 升级、后端架构

2026 年的 Java 后端正处在一个少见的”三层同时换代”的窗口:JDK 25 LTS 落地、Spring Boot 4 主线推进、Spring AI 2 进入 GA。三层各自都在动,叠加起来就是一次需要认真规划的技术栈迁移。

本文把这三层的现状、相互关系和可执行的升级顺序讲清楚,并给出一份避坑清单。

一、版本坐标

截至 2026 年 9 月,从 Maven Central 元数据核对到的正式版本如下(里程碑版本未计入):

  • Spring Boot4.1.1(4.2.0 系列已有里程碑版本在推进);
  • Spring Framework7.0.9
  • Spring AI2.0.1
  • JDK:最新 LTS 为 25,最新特性版本为 26。

版本信息建议以 Maven Central 上的 maven-metadata.xml 为准——注意别把里程碑版本(-M1-RC1)误当成正式版,检索工具返回的”最新版”经常是里程碑。

二、Spring Boot 4:改动集中在”基线”,不在写法

好消息是,Spring Boot 4 对日常业务代码的破坏性不大。注解、配置方式、自动装配的心智模型都没有翻天覆地的变化。真正需要提前确认的是下面几件事。

1. JDK 与 Jakarta EE 基线

Spring Boot 4 建立在 Spring Framework 7 之上,对 最低 JDK 版本和 Jakarta EE 版本的要求都随大版本提升。这是升级前必须第一项核实的硬门槛——如果生产环境还停在很旧的 JDK 上,那么真正的成本不在 Spring,而在先把运行时拉上来。

建议做法是:先单独把 JDK 升到 LTS 版本并稳定跑一段时间,再动 Spring。两个变量一起变,出问题时的归因会非常痛苦。

2. 被移除的废弃 API

大版本是清理历史包袱的窗口。升级时最先报错的通常是这些:

  • 早已标记 @Deprecated 且在大版本被移除的类与方法;
  • 自动装配配置方式的调整(spring.factories 相关的历史写法);
  • 第三方 starter 尚未适配新版本——这是最常见的卡点,往往是某个不起眼的 starter 拖住整条升级链路。

排查建议:先把 dependency-management 里的版本统一交给 Spring Boot 的 BOM 管理,别手写版本号,能避开大半依赖冲突。

3. 与虚拟线程的关系

JDK 25 的虚拟线程已经是成熟能力,Spring Boot 4 对它的支持路径比早期清晰得多。但有个常见误解要澄清:开了虚拟线程不等于吞吐量自动翻倍

# 启用虚拟线程处理请求
spring.threads.virtual.enabled=true

虚拟线程解决的是”线程数量不再是并发上限“,它让你可以用同步的写法处理大量并发连接。但如果下游是数据库连接池——池大小依然是真的瓶颈,那么并发压到池上只会把等待时间从线程池搬到了连接池。用之前先想清楚瓶颈在哪一层。

三、Spring AI 2:从”能调模型”到”能进生产”

Spring AI 2.0.1 是正式 GA 版本,定位是把 AI 能力按 Spring 的习惯封装成可注入、可配置、可替换的组件。

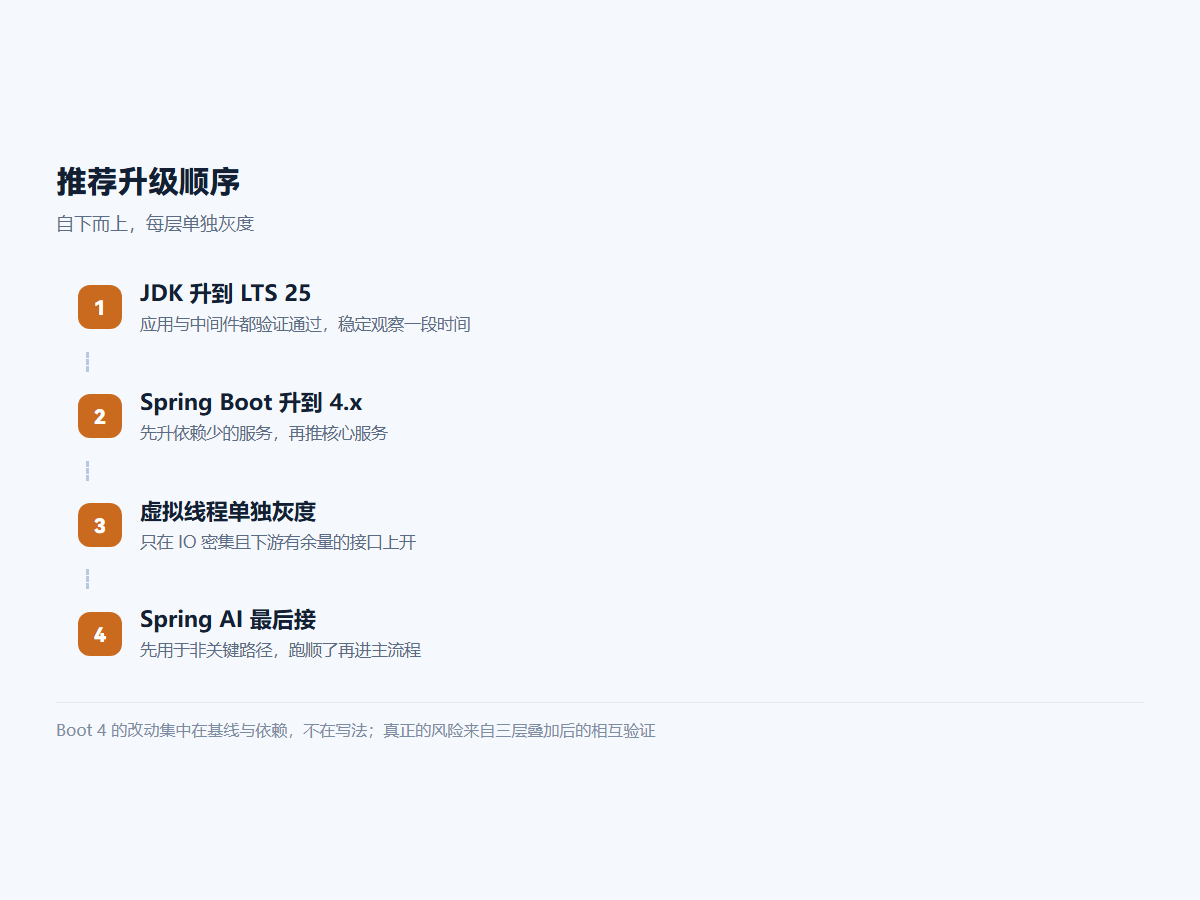
推荐升级顺序
Java 技术栈升级顺序:JDK → Spring Boot → 虚拟线程 → Spring AI

1. 关键抽象

它提供的核心不是”调一次大模型”,而是几层可替换的抽象:

  • ChatClient / 模型适配层:切换模型供应商时业务代码基本不动;
  • 结构化输出:把模型返回直接映射成 Java 对象,省掉脆弱的正则解析;
  • 向量存储抽象:RAG 场景下换向量库不改业务代码;
  • 工具调用(Function Calling):让模型触发业务方法,把 AI 接进真实系统;
  • 可观测性衔接:调用链路、token 消耗能进现有的监控体系。
// 结构化输出:直接拿 Java 对象,不用解析字符串
record ProductReview(String sentiment, List<String> aspects) {}

ProductReview review = chatClient.prompt()
    .user("分析这条评论:" + text)
    .call()
    .entity(ProductReview.class);

2. 生产落地必须自己补的三件事

框架解决的是”接得上”,下面这些框架不替你做

  • 超时与降级:模型调用是慢 IO,必须有超时、重试上限和兜底文案,否则一次上游抖动会拖垮整条链路;
  • 成本控制:token 消耗要能按业务维度归因,否则月底账单会是黑盒;
  • 输出校验:结构化输出不等于正确输出,关键业务仍要在落库前做业务规则校验。

四、推荐升级顺序

三层同时换代时,顺序比速度重要。建议按下面的步骤推进,每一步都可独立回退:

  1. JDK 先升到 LTS 25,应用与中间件都验证通过,稳定观察一段时间;
  2. Spring Framework / Boot 升到 4.x,先升依赖少的服务,再推核心服务;
  3. 虚拟线程单独灰度,只在对 IO 密集且下游有余量的接口上开,观察线程池与连接池指标;
  4. Spring AI 最后接,且先用在非关键路径(如内部工具、运营后台),跑顺了再进主流程。

五、什么情况下应该暂缓

  • 核心服务依赖的第三方 starter 还没适配:自研 fork 一个的长期成本远高于等待;
  • 处于大促/发布冻结期:基线变更的风险不值得在冻结期承担;
  • 缺少回归测试:大版本升级没有测试兜底,等于闭眼过马路。

六、小结

这一轮换代的本质,是 Java 后端从”线程池时代”走向”虚拟线程 + AI 能力内建“。Spring Boot 4 本身的写法变化不大,真正的成本在基线升级和依赖生态适配;Spring AI 2 则把 AI 从”外部服务”变成了”可注入组件”,但工程上的超时、成本、校验三件事仍需自己兜底。

先升运行时、再升框架、最后接新能力——这个顺序能避开绝大多数坑。

标签

#Spring Boot#Java#Spring AI#后端

2026 年值得落地的现代 CSS:容器查询、:has()、级联层与视图过渡

2026 年值得落地的现代 CSS:容器查询、:has()、级联层与视图过渡
关键词现代 CSS、容器查询、has 选择器、级联层、视图过渡、锚点定位

过去几年 CSS 的更新密度,是这门语言诞生以来最高的。容器查询、:has()、级联层、视图过渡、锚点定位……这些能力单独看是”又一个新属性”,合在一起却改变了样式表的组织方式:组件终于可以真正独立,动画终于可以真正声明式。

本文不罗列规范,只讲能在生产里落地的部分:每项能力解决什么老问题、代码怎么写、以及必须知道的兼容性红线。

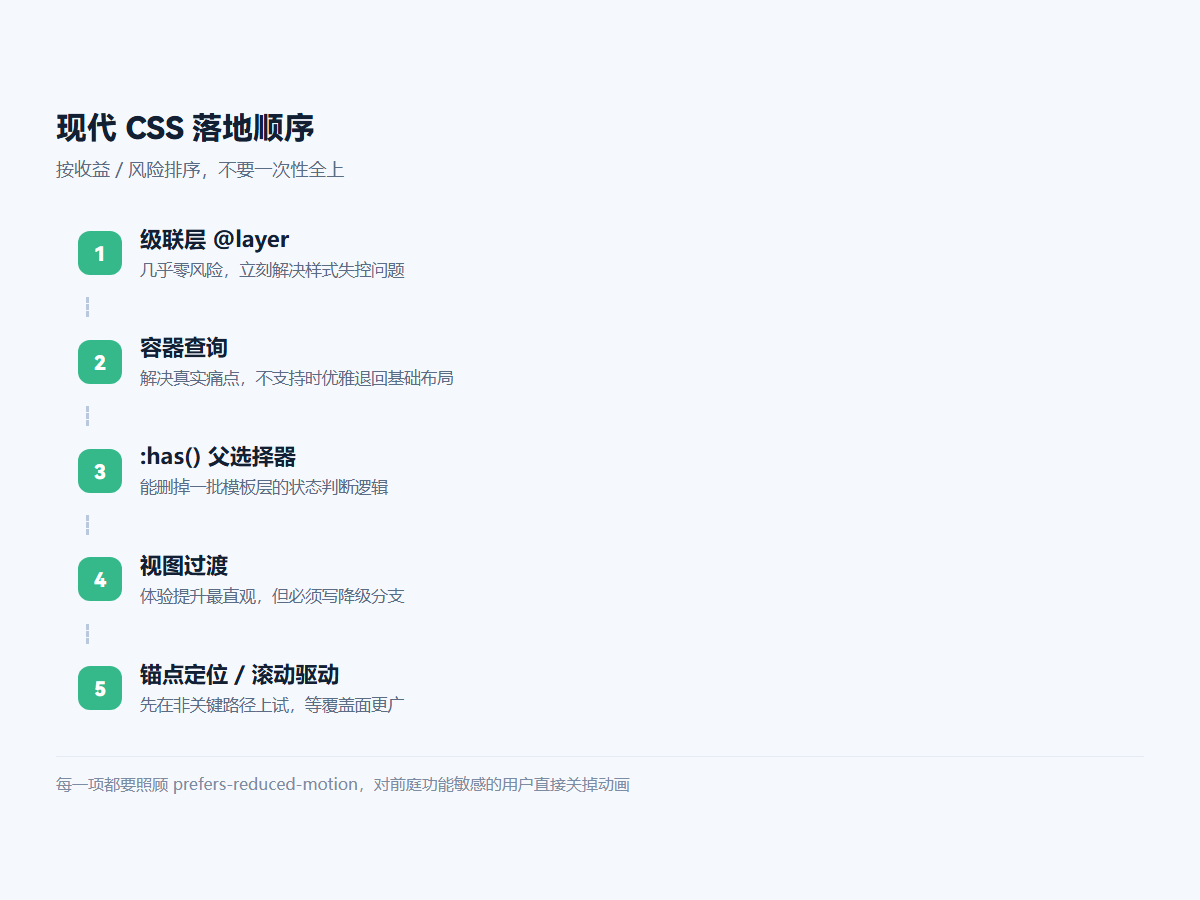
现代 CSS 落地顺序
现代 CSS 落地顺序:级联层 → 容器查询 → :has() → 视图过渡 → 锚点定位

一、容器查询:组件终于能自己决定长什么样

媒体查询(@media)问的是”视口有多宽”,但组件真正关心的是“我被放进了多大的空间”。同一个卡片组件,塞进 320px 的侧栏和塞进 900px 的主内容区,本来就应该长成两个样子——在容器查询之前,这件事只能靠 JS 测量或者给组件传 size 属性硬凑。

.card-container {
  container-type: inline-size;
}

.card { /* 窄容器:纵向堆叠 */ }

@container (min-width: 480px) {
  .card { /* 宽容器:左右布局 */ }
}

关键点是 container-type: inline-size,它把这个元素声明为一个”可查询的容器”。注意副作用:声明了 inline-size 的元素,其行内尺寸不再受内容撑开影响,布局上要额外确认一遍。

落地建议:优先在真正会被复用到不同位置的组件上用(卡片、列表项、工具栏),而不是全站铺开。铺开之后调试成本会明显上升,因为你得一级一级往上找是哪个容器在生效。

二、:has():缺失了二十年的父选择器

“如果这张卡片里有图片,就换一套内边距”——这类需求以前只能靠在模板层加 class。:has() 把它变回纯 CSS:

.card:has(img) {
  padding-top: 0;
}

/* 表单校验失败的字段,高亮整个表单组 */
.form-group:has(:invalid) {
  border-color: #d94f5c;
}

它的价值不只是少写 JS,而是把”结构判断”这件事放回了它该在的地方。模板不用再为了样式去维护一堆状态 class。

需要注意的性能认知:早期的担忧是 :has() 会不会很慢。实际在现代引擎里,限定作用域的写法(如 .card:has(img))开销可接受;真正要避免的是无约束的全局写法,比如 :has(*) 这类把整棵树都纳入匹配的模式。

三、级联层:把 !important 战争提前终结

大型项目样式失控的典型路径是:第三方库样式盖不住 → 加 !important → 别人再加一层 → 谁也不敢删。@layer 提供的是在层与层之间预先定好优先级的机制:

@layer reset, vendor, components, utilities;

@layer vendor     { @import url("some-lib.css"); }
@layer components { .btn { /* ... */ } }
@layer utilities  { .mt-4 { margin-top: 1rem; } }

声明顺序即优先级顺序:后声明的层压过先声明的层,且这个优先级高于选择器特异性。这意味着 utilities 层里的一个单类选择器,可以稳定压过 components 层里很长的后代选择器——再也不用靠堆类名长度取胜。

迁移成本很低:把现有的样式分块包进 @layer 即可,不需要改任何选择器。建议在新项目里第一天就建好层结构,老项目则可以在引入新模块时逐步收敛。

四、视图过渡:声明式的页面切换动画

单页应用里的路由切换动画,以前意味着一堆状态管理和 requestAnimationFrame。视图过渡 API 把这件事变成了浏览器原生能力:

function navigate(to) {
  if (!document.startViewTransition) {
    updateDOM(to)          // 不支持就老老实实直接切
    return
  }
  document.startViewTransition(() => updateDOM(to))
}

浏览器会自动截取切换前后的两帧做交叉淡入,元素只要标记了 view-transition-name,就能在两个状态之间自动做位置和尺寸补间——列表项点开变成详情页大图这种效果,几行 CSS 就能实现。

两条红线:一是必须做特性检测,不支持的环境要能正常降级;二是记得照顾 prefers-reduced-motion,对前庭功能敏感的用户直接关掉过渡。

五、还有几项值得排进技术雷达

  • subgrid:让子元素的网格对齐父网格。做”多行卡片左右列对齐”这种需求时,终于不用给每个卡片塞死高度;
  • 锚点定位(Anchor Positioning):把浮层绑定到触发元素,不用再手动算坐标。Tooltip、下拉菜单的味道很对,但兼容性还在铺,建议先做渐进增强;
  • oklch()color-mix(): perceptual 均匀的色彩空间,做主题色阶时比 HSL 靠谱得多,深浅色模式下的对比度也更可预期;
  • 滚动驱动动画:把动画进度绑到滚动位置,纯 CSS 实现,不再需要 scroll 事件监听。阅读进度条、滚动渐显这类效果的性价比极高。

六、落地顺序建议

不要把新特性一次性全上。按”收益 / 风险”排,我的建议顺序是:

  1. @layer——几乎零风险,立刻解决样式失控,收益立竿见影;
  2. 容器查询——解决真实痛点,且不支持时会优雅退回基础布局;
  3. :has()——能删掉一批模板层状态逻辑,写法收敛后很好维护;
  4. 视图过渡——体验提升最直观,但一定要写降级分支;
  5. 锚点定位 / 滚动驱动动画——先在非关键路径上试,等覆盖面更广再进主流程。

七、小结

这一轮 CSS 更新的共同主题,是把以前必须写 JS 才能做的事,收回到样式层。容器查询收走了尺寸测量,:has() 收走了结构判断,视图过渡收走了动画编排,@layer 收走了优先级管理。

对工程的实际影响是:组件的自洽性变强了。一个组件能不能”放哪都长对”,以前取决于使用方传没传对参数,现在取决于它自己写没写对容器查询。这个转变值得重新审视一遍现有的组件库。

标签

#CSS#前端#容器查询#响应式设计

TypeScript 7 原生编译器:一次编译速度的量级提升,与必须处理的迁移清单

TypeScript 7 原生编译器:一次编译速度的量级提升,与必须处理的迁移清单
关键词TypeScript 7、原生编译器、类型检查、构建提速、迁移、前端工程化

TypeScript 7 是这门语言十年来最大的一次底层变更:编译器从 JavaScript 实现换成了 Go 实现的原生二进制。带来的直接结果是类型检查与编译速度的量级提升,以及大型单体仓库终于能吃到的”秒级全量检查”。

但版本号跳跃也意味着迁移成本。本文讲清 TS 7 到底改了什么、哪些写法会被挡住、以及一份可照抄的渐进迁移清单。

一、版本坐标

截至 2026 年 9 月,typescript 的 npm dist-tags 大致是这样的状态:latest7.0.2rc 通道为 7.0.1-rc,next 通道指向 7.1.0-dev,而 beta 通道上还留着 6.0.0-beta。版本号可以在 npm 上的 typescript 包页面随时核对。

这里有个容易混淆的点需要讲明白:6.x 和 7.x 不是简单的先后关系,而是”两条线”。6.x 延续原有的 JavaScript 编译器实现,主要承担兼容与过渡职责;7.x 则是全新的原生实现,是未来的主线。选错分支会在升级时白跑一趟。

二、TS 7 到底换了什么

一句话:编译器本体被重写了,语言本身基本没变

TypeScript 团队长期面临的一个结构性问题是,用 JavaScript 写的编译器在超大仓库上做全量检查时,单线程性能和内存占用都到了瓶颈。项目越大,tsc --noEmit 越慢,IDE 里的类型提示就越迟钝。原生实现的目标就是把这层天花板掀掉。

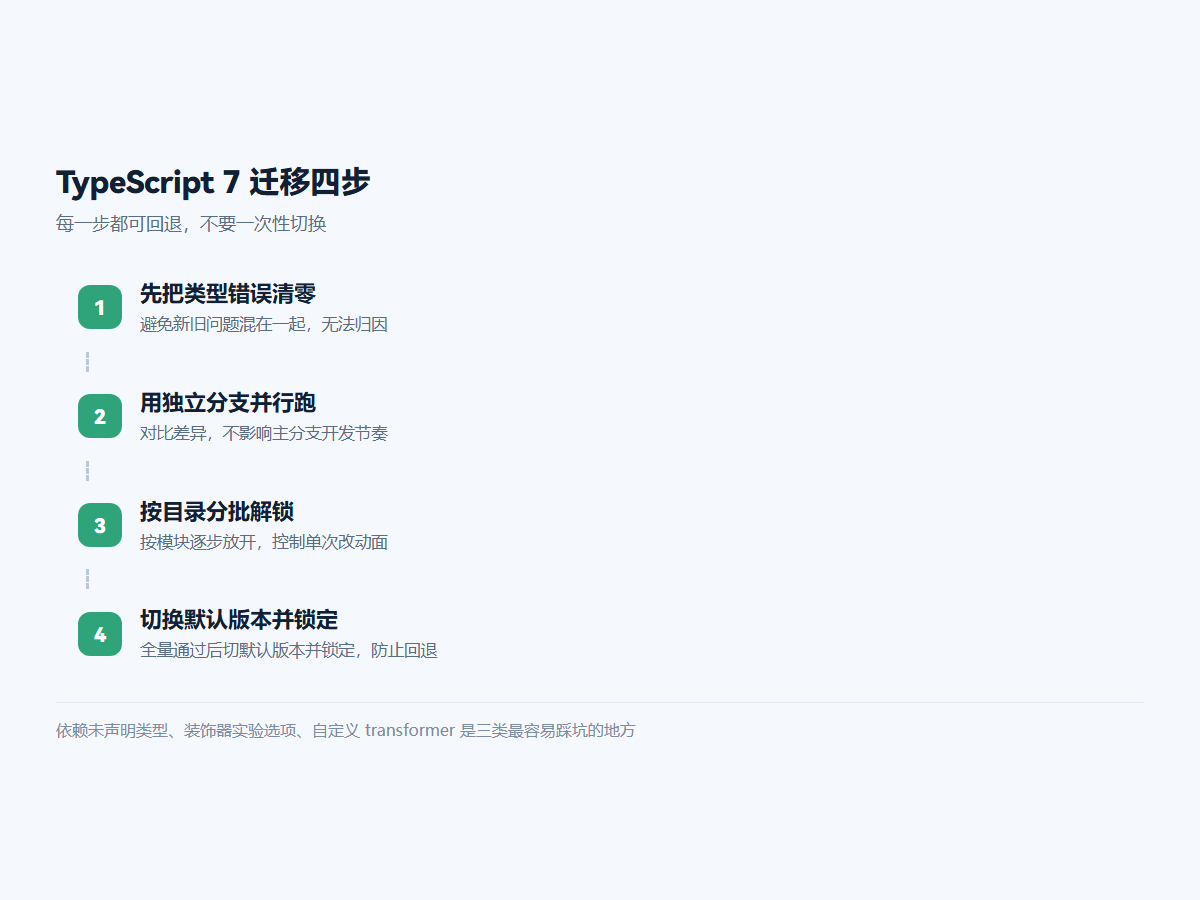
TypeScript 7 迁移四步
TypeScript 7 迁移清单:清零错误 → 并行验证 → 分批解锁 → 锁定默认

对使用者的意义很直接:同样的代码,检查更快、内存更省、编辑器响应更跟手。对于几万文件的 Monorepo,全量检查从”分钟级”压到”秒级”是常见的数量级变化。CI 里跑类型检查的时间成本下降,也会连带影响流水线的排队与并发策略。

三、语言层面:哪些写法要改

原生实现为了换取性能,收紧了一批历史上”能过但语义模糊”的写法。迁移时最先卡住项目的通常是下面几类。

1. 依赖未声明类型的隐式行为

老编译器在某些场景下会”宽容地放过”类型信息缺失的情况,比如从无类型的 .js 文件里推导出的 any 再参与运算。原生实现倾向于更早、更严格地报错。这类问题的修法很朴素——把隐式 any 显式化

// 迁移前:handler 的入参被推导为 any,静默通过
import { handler } from './legacy-helper.js'
handler(event)

// 迁移后:显式标注,把不确定性摆到台面上
import { handler } from './legacy-helper.js'
handler(event as unknown as AppEvent)

2. 装饰器与实验性选项

如果你的项目重度使用装饰器(尤其是 Angular、NestJS 这类框架),需要重点回归测试。装饰器的元数据发射与求值顺序是原生实现中最容易与旧行为产生差异的地方。建议在迁移分支上先跑一遍完整的框架构建与运行时冒烟,而不是只看 tsc 是否报错。

3. 自定义 transformer 与编译器 API

这是最硬的一块。直接依赖 typescript 内部 API 的工具链(老版本的代码生成插件、自定义 transformer)在原生实现下大概率失效,因为内部数据结构不再是同一套 JavaScript 对象树。

排查顺序建议:

  • 先检查 tsconfig.json 里有没有配置 plugins
  • 再检查构建工具链里是否有依赖 ts.createProgramts.transform 之类 API 的脚本;
  • 对无法替换的插件,考虑把对应能力前移到构建阶段(比如用 Babel/SWC 插件或独立的代码生成脚本),让类型检查只做类型检查。

四、迁移清单:四步走

不要一次性切主分支。推荐按下面的顺序推进,每一步都能独立回退。

第 1 步:先把类型错误清零

在旧版本上把 strict 下的类型错误全部修完,并让 CI 强制拦截。带着一堆既有错误去迁新版,会分不清哪些是新版引入的。

# 先在当前版本上确认基线
npx tsc --noEmit

第 2 步:用独立分支并行跑

在 CI 里新增一个”实验性”任务,用 TS 7 跑一遍类型检查,允许失败但产出报告。这一步不阻塞合入,只是持续收集差异。

# CI 中的并行检查任务(示例)
- name: Type check (TS 7 preview)
  run: npx tsc --noEmit
  continue-on-error: true

第 3 步:按目录分批解锁

把第 2 步收集到的错误按目录归类,从”叶子模块”(依赖最少的工具层、类型定义层)开始修,逐步向业务层推进。这样每修一批都能立刻看到错误总数下降,进度可控。

第 4 步:切换默认版本并锁定

全部绿灯后,把 typescript 依赖切到 7.x 并锁定次版本,同时更新编辑器使用的 TS 版本(VS Code 需要在工作区里显式指定,否则可能仍在用内置版本)。

// .vscode/settings.json
{
  "typescript.tsdk": "node_modules/typescript/lib"
}

五、什么时候不该急着升

说了这么多好处,也得讲清边界。下面三种情况,建议再等一两个小版本

  • 强依赖内部编译器 API 的自研工具链:替代方案没落地之前,升级等于自断一臂;
  • 处于发布冻结期的项目:类型检查行为变化可能牵出运行时问题,不值得在冻结期冒险;
  • 装饰器重度使用且缺少回归测试:没有测试兜底,差异很难被及时发现。

反过来说,纯业务代码、测试覆盖尚可、CI 有类型检查关卡的项目,升级收益明显大于风险,可以排上日程。

六、小结

TypeScript 7 的价值不在新语法糖,而在把类型检查从”不得不忍受的等待”变成”随手可跑的即时反馈”。真正的工作量不在改代码,而在排查工具链依赖——尤其那些悄悄用了编译器内部 API 的插件。

迁移的正确姿势是并行跑、分批修、可回退,而不是挑个周末一把梭。

标签

#TypeScript#前端工程化#编译器#前端

薪资谈判与技术人软技能:HR 面 20 问与应答策略

薪资谈判与技术人软技能:HR 面 20 问与应答策略
关键词薪资谈判、期望薪资、薪酬总包、offer比较、软技能、HR面试

薪资谈判是技术人最容易吃亏的环节。原因很简单:我们习惯用”技术能力”换取回报,但薪资谈判考验的是信息、节奏与心理素质——这三项恰恰不是日常训练的内容。

本文给出一套可执行的谈薪方法,并附上 HR 面软技能高频题的应答策略。

一、谈薪前:先补齐三个信息

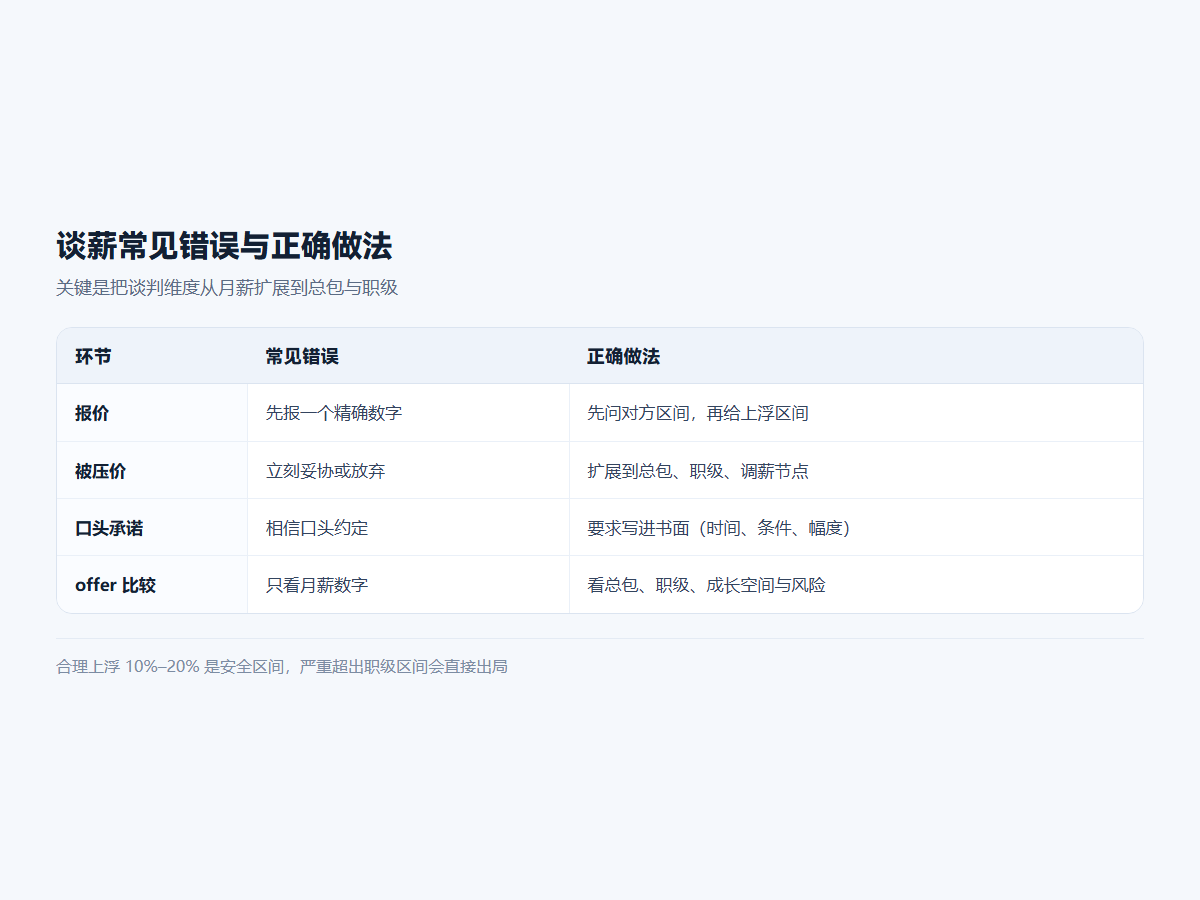
谈薪常见错误与正确做法
谈薪常见错误与正确做法对比:报价、压价、口头承诺与 offer 比较
  1. 市场区间。 通过同行交流、招聘平台的同类岗位、猎头反馈,建立”同城 + 同级别 + 同技术栈”的薪酬区间认知。没有参照系的报价,必然要么亏要么冒进;
  2. 对方的预算与结构。 了解薪酬包构成:base、绩效、年终、股权/期权、补贴、公积金基数。税前总包才是可比口径,只看月薪会被结构差异误导;
  3. 自己的底线与筹码。 底线是”低于多少不去”,筹码是”我凭什么值这个价”——后者要能说成可量化的成果

二、报价策略:三个不要

不要先报数字(如果可以的话)。 当对方问期望薪资时,优先反问:”贵司这个职级有既定的薪酬区间吗?我想先了解一下结构。”先拿到对方的区间,你就掌握了锚点。

不要报一个精确数字。 给出一个略微上浮的区间,例如市场价 30K 时说”我期望在 32–35K 左右,具体看整体薪酬结构”。区间给谈判留空间,也给对方面子。

不要无依据地狮子大开口。 报价严重超出职级区间,会直接进入”不合适”通道,连还价机会都没有。合理上浮 10%–20% 是常见的安全区间。

三、当对方压价时:四步应对

对方的说法 应对思路
“你的期望超出预算” 问清楚差距多大 → 转向其他组成部分(签字费、年终、职级、调薪节奏)
“你上一家薪资不高” 不与上家挂钩,强调岗位价值与个人产出,说明上家薪资包含历史因素
“我们更看重发展机会” 认可机会,但明确”合理的薪酬是对我投入的基本认可”,要求给出明确的调薪节点
“先入职,半年后调薪” 要求写进书面约定(调薪时间、条件、幅度),口头承诺不具备约束力

核心原则:薪资谈不拢时,把谈判维度从”月薪”扩展到”整体薪酬 + 职级 + 发展”。很多时候月薪动不了,但签字费、职级、股票、年假是可以争取的。

四、 Offer 比较:别只看数字

拿到多个 offer 时,建议按以下维度打分:

  1. 现金总包:base × 12 + 年终 + 补贴,注意年终是”保底”还是”浮动”;
  2. 职级与成长空间:职级决定了未来 3 年的薪资天花板,往往比当前多几千更重要;
  3. 技术资产积累:这个岗位能否让你在某个方向形成壁垒;
  4. 团队与管理者:直属领导的专业度与稳定性,直接影响你的成长速度;
  5. 风险项:业务稳定性、融资阶段、加班强度、通勤成本。

不要拿 offer 恶意抬价。 用 A 家的 offer 去逼 B 家加价、反复改口,会在行业里留下口碑成本。有比较可以如实说明,但不要编造不存在的 offer。

五、软技能高频题与应答

Q:你的优点和缺点是什么?
优点要与岗位相关并带例证;缺点要真实但可控,且说明改进措施。例如:”我过去对需求理解容易想当然,后来养成了先输出技术方案再动手的习惯。”忌讳说”我的缺点是太追求完美”这类伪缺点。

Q:你和同事发生矛盾怎么处理?
用事实 + 行动 + 结果:说明分歧点 → 如何用数据或方案对比推进 → 结果如何。体现的是协作与沟通方式,不是谁对谁错。

Q:你怎么应对压力?
不要说”我没压力”,也不要渲染焦虑。示范:”我会先把问题拆成可执行的清单,按优先级推进,并及时同步风险。压力大的时候我会主动沟通,避免把风险憋到最后。”

Q:为什么有一段空窗期?
如实说明(照顾家人、系统学习、身体调整、主动休息),并强调已经准备好回归,以及空窗期的收获。回避或含糊其辞反而放大疑虑。

Q:你能接受加班吗?
不要直接说”完全不接受”或”都可以”。推荐答法:”项目关键节点我会全力投入,但我更希望通过合理的排期与流程减少不必要的加班。“既表态又不自我压价。

Q:你有什么想问我们的?
问岗位职责、团队目标、成功标准、技术栈与协作流程。这展示的是认真度。薪资细节留到 offer 沟通阶段。

六、最后三个提醒

  1. 所有承诺落到书面。 薪资、职级、年终、调薪时间,口头承诺在入职后很难追回;
  2. 离职要体面。 做好交接、不诋毁前公司,行业圈子比你想象的小;
  3. 谈薪失败很正常。 谈不拢往往不是你的问题,而是预算与职级匹配问题,保持专业,留下好印象,未来还有机会。

七、小结

谈薪不是对抗,而是把”我能创造的价值”与”对方的预算结构”对齐的过程。准备充分、报价合理、沟通坦诚,结果通常不会差。

记住一句话:入职前是你议价能力最强的时刻,错过这个窗口,下一次调薪要等一年。

标签

#HR面试#薪资谈判#软技能#面试

HR 面试通关:自我介绍、项目复盘与职业规划的高分答法

HR 面试通关:自我介绍、项目复盘与职业规划的高分答法
关键词HR面试、自我介绍、STAR法则、职业规划、跳槽原因、面试技巧

技术面过了,HR 面栽了——这是最可惜的失败方式。原因通常是把 HR 面当成”聊天”,随口发挥,反而暴露了准备不足、职业规划模糊、或对跳槽动机解释不清。

本文给出 HR 面三大核心题(自我介绍、项目复盘、职业规划)的可复用答法,以及高频追问的应对框架。

一、先理解 HR 面在考什么

HR 面与技术面的评价维度完全不同,技术面看”能不能干“,HR 面看”稳不稳、合不合、贵不贵“:

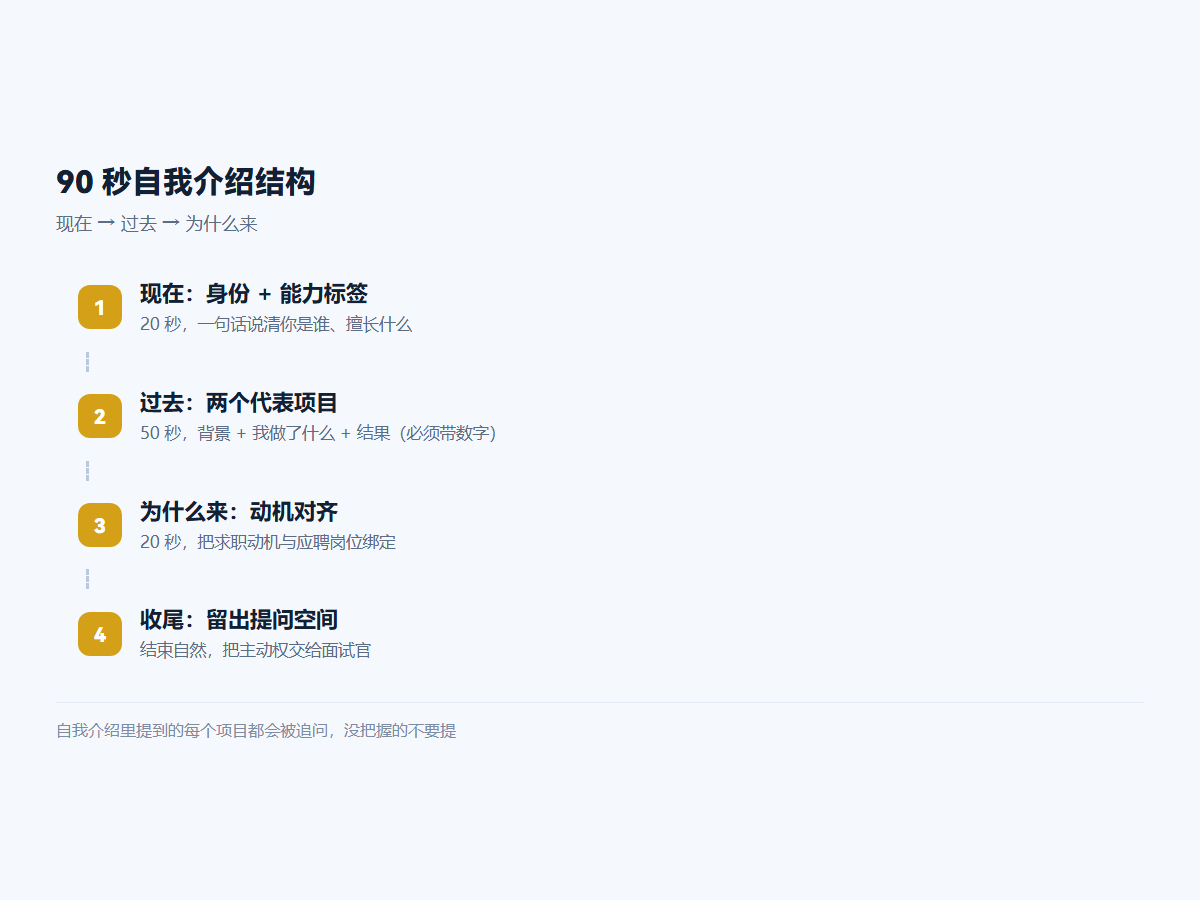
90 秒自我介绍结构
自我介绍黄金结构:现在(身份标签)→ 过去(两个项目)→ 为什么来(动机对齐)
  • 稳定性:会不会干几个月就走?跳槽是否过于频繁?动机是否合理?
  • 匹配度:你的经历与诉求,和这个岗位是否一致?
  • 性价比:期望薪资是否在预算内?
  • 风险点:有无劳动纠纷、竞业、背景问题,沟通与协作是否正常。

想明白这一点,答题就有了锚点:每个回答都要在降低对方的顾虑。

二、自我介绍:90 秒的黄金结构

最常见的失败是按时间顺序流水账:”我是 XX 年毕业的,先在 A 公司做了……然后在 B 公司……”。HR 听了三分钟抓不到重点。

推荐结构(现在 → 过去 → 为什么来):

  1. 现在(20 秒):当前身份 + 核心能力标签。”我目前在一家 XX 公司做高级前端,主要负责高并发 C 端业务的架构与性能优化。”
  2. 过去(50 秒):挑 2 个最能证明能力的项目,用”背景 + 我做了什么 + 结果”三句话讲完,结果必须带数字。
  3. 为什么来(20 秒):说明求职动机,并与应聘岗位对齐。”我希望在 XX 方向做深,贵团队正好在……”

关键提醒:自我介绍里提到的每一个项目,都会被追问细节。没把握的项目不要提——宁可讲得少而稳,也不要给自己挖坑。

三、项目复盘:用 STAR 结构答

HR 听不懂技术细节,但能听懂问题、行动、结果、你的角色。用 STAR 框架:

要素 要讲清什么 示例
S 情境 背景与难点 首页首屏 4 秒,跳出率高
T 任务 你的目标 两个月内首屏降到 2 秒内
A 行动 你具体做了什么 拆阶段埋点、定位长任务、重构渲染链路
R 结果 可量化的产出 LCP 从 4.1s 降到 1.8s,转化率提升 X%

三个高频追问

追问 1:”你在项目中遇到的最大困难是什么?”
真实且有收获的困难,重点讲你如何分析和解决,而不是抱怨资源不足或同事不配合。抱怨型回答是 HR 面大忌。

追问 2:”你和同事/上级有过分歧吗?怎么处理?”
这是协作能力测试。示范答法:说明分歧点 → 你如何用数据或方案对比沟通 → 最终结果 → 你从中学到什么。不要把分歧描述成”我是对的,他们不懂”

追问 3:”这个项目里你最大的贡献是什么?”
用”我主导了 X“而非”我们做了 X”,但要诚实区分主导参与。夸大贡献在背景调查时容易露馅。

四、职业规划:别说”三年做到管理岗”

职业规划题考察的是稳定性与自我认知。常见失分答法:

  • ❌ “三年内做到技术总监”——显得动机在权力而非技术,且与岗位可能不匹配;
  • ❌ “还没想好,先干着看”——显得没有规划、容易流失;
  • ❌ “打算两年后自己创业”——几乎等于告诉对方你干不长。

推荐结构:短期(1 年)落地 + 中期(2–3 年)深耕 + 与岗位的绑定

示例:”一年内我希望把公司的 XX 体系摸透,在性能/稳定性方向上做出可量化的成果;两到三年我希望成长为能独立负责一条业务线的技术骨干。这也是我看重贵团队在 XX 方向上积累的原因。”

五、动机类问题:跳槽原因怎么说

核心原则:说”追求什么”,不说”逃离什么”

失分说法 更好说法
领导不行 / 加班太多 希望找到更能发挥专业能力、流程更规范的平台
钱太少了 希望薪酬与承担的职责更匹配
技术栈太老 希望在 XX 技术方向上有更深入的实践机会
同事关系差 希望加入协作氛围更紧密的团队

注意:不要贬低前公司或前领导。这在 HR 眼里是风险信号——因为你未来也可能这么评价他们。

六、反问环节:问什么才加分

反问是展示你认真度的最后机会。推荐问:

  • “这个岗位所在的团队目前的主要目标是什么?”
  • “团队的技术栈与协作流程是怎样的?”
  • “这个岗位半年度的成功标准是什么?”
  • “入职后前三个月,您希望我优先解决什么问题?”

避免一上来就问:加班多不多、几点下班、能不能远程、年终奖几个月。这些可以问,但放到 offer 沟通阶段更合适。

七、小结

HR 面的本质不是”聊天”,而是风险排查。准备的诀窍是把每个高频题写成要点、对着镜子练三遍,确保90 秒内能讲清自己是谁、能干什么、为什么来

最后一句提醒:诚实比完美重要。 编造的经历在追问与背调面前非常脆弱,真话讲得有结构,比假话讲得有技巧安全得多。

标签

#HR面试#面试技巧#职业规划#面试

ArkUI 面试精讲:声明式 UI、状态管理 V1/V2 与渲染流程

ArkUI 面试精讲:声明式 UI、状态管理 V1/V2 与渲染流程
关键词ArkUI、声明式UI、@State、@Observed、状态管理V2、鸿蒙面试

ArkUI 的面试题有个特点:表面上问的是写法,实际考察的是”你是否理解状态驱动 UI 的完整链路”。因为声明式框架的所有坑,几乎都出在”状态变了但 UI 没更新”或”UI 更新了但范围失控”这两件事上。

本文按”声明式原理 → 装饰器 → 渲染流程 → 性能”四层拆解高频考点。

一、声明式 UI:先讲清与命令式的区别

Q1:声明式 UI 和命令式 UI 的本质区别?
命令式是手动操作 UI 对象(找到控件、设置属性、调用刷新);声明式是描述”UI 应该是状态的函数”,状态变化时框架自动计算差异并更新。

ArkUI 属于后者:用 build() 描述 UI 结构,用装饰器标记状态,状态变化驱动局部刷新。

@Entry
@Component
struct Demo {
  @State count: number = 0

  build() {
    Row() {
      Text(`count = ${this.count}`)
      Button('+1').onClick(() => this.count++)
    }
  }
}
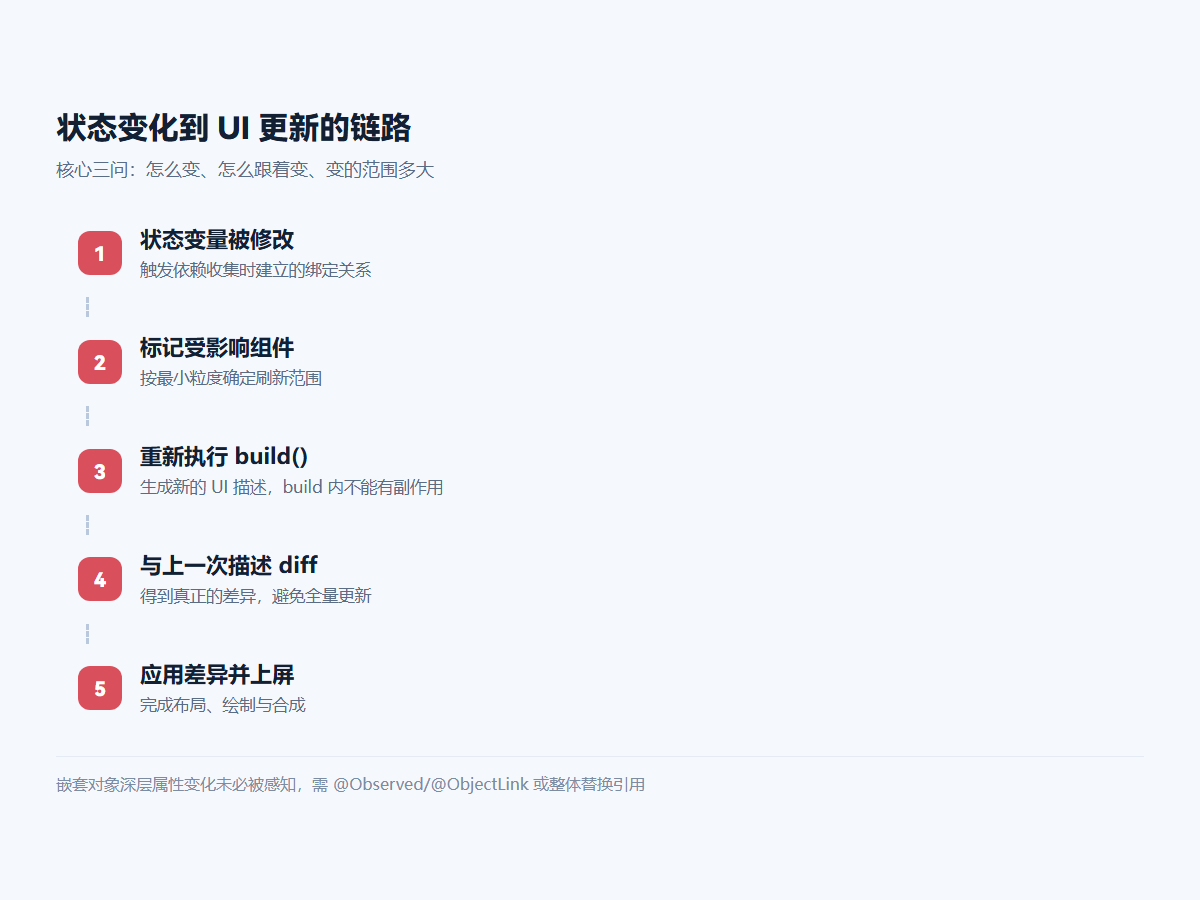
状态变化到 UI 更新的链路
ArkUI 渲染流程:状态变更 → 标记脏 → 重新 build → diff → 应用差异上屏

二、状态装饰器:面试必考的区分题

Q2:@State@Prop@Link 的区别?

装饰器 数据流向 典型场景
@State 组件内部状态,自身可写 组件私有的可变数据
@Prop 父 → 子,单向 子组件只读展示父级数据
@Link 父子双向绑定 子组件需要修改父级状态
@Provide / @Consume 跨层级双向 避免逐层传递
@Observed / @ObjectLink 嵌套对象/数组的观测 复杂数据结构的局部刷新

Q3:为什么改了嵌套对象的属性,UI 不刷新?
这是最高频的实战坑。@State 的观测能力对嵌套对象的深层属性、或数组元素内部的字段变化存在边界。解法:

  • 把嵌套类用 @Observed 装饰,子组件用 @ObjectLink 接收,实现深层属性变化的观测;
  • 整体替换对象引用(赋一个新的对象),让框架感知到引用变化;
  • 数组更新尽量用会产生新引用的方式,避免原地修改。

追问陷阱:“为什么有时必须整体替换对象?”
因为框架对状态变化的感知依赖引用变化或明确的属性写入。原地深层修改不会触发通知机制,UI 自然不刷新。答出”引用变化”这四个字基本就通过了。

Q4:状态管理 V1 与 V2 的差异?
V2 是新一代状态管理能力,重点解决 V1 在深度观测、精准刷新、组件复用上的局限(例如对复杂对象的观测能力、更细粒度的刷新控制、更清晰的装饰器语义)。面试时建议表达为:V2 是方向,新模块优先采用;存量代码按节奏迁移,不要一次性重写。

三、渲染流程:把链路讲完整

Q5:一次状态变化到 UI 更新,中间发生了什么?

  1. 状态变量被修改,触发依赖收集时建立的绑定关系
  2. 框架标记受影响的组件为脏,按最小粒度确定刷新范围;
  3. 重新执行相关组件的 build(),生成新的 UI 描述;
  4. 与上一次的描述做 diff,得到差异;
  5. 将差异应用到渲染树,完成布局、绘制与合成上屏。

Q6:build() 方法有什么约束?

  • 不能有副作用:不要在里面发网络请求、修改非状态变量、操作数据库——build 可能被调用多次;
  • 只能有一个根节点(用容器组件包裹);
  • 不要做耗时计算:会直接拖慢刷新;
  • 条件渲染用 if、列表用 ForEach/LazyForEach,而不是在 build 外拼装组件数组。

Q7:ForEachLazyForEach 怎么选?
ForEach 会一次性创建全部子组件,适合数量少且固定的列表;LazyForEach 按需创建、滑出可视区可回收,适合长列表或数据量大的场景。长列表用 LazyForEach 是最基本的性能素养

四、性能:从原理推出的优化点

Q8:ArkUI 常见的性能问题有哪些?

  • 刷新范围过大:一个状态变化导致整页重建。解法是拆组件,把状态收敛到最小子树;
  • build 里做重活:把计算外移或用缓存;
  • 长列表未懒加载:改用 LazyForEach 并设置合理的缓存数量;
  • 布局层级过深:嵌套过深会增加测量与布局成本,尽量扁平化;
  • 频繁创建销毁对象:造成内存抖动,考虑复用。

Q9:如何定位刷新范围问题?
利用 DevEco Studio 的性能分析工具查看布局与渲染耗时,同时在开发期给关键组件的 build 打日志,确认每次状态变化到底重建了哪些组件。这是最朴素也最有效的手段。

五、工程实践题

Q10:如何组织一个中大型 ArkUI 项目的状态?

  1. 分层:组件内部临时状态用 @State;跨组件共享用 @Provide/@Consume 或应用级存储;业务领域状态收敛到独立的状态类,避免散落各处;
  2. 数据源单一:同一份数据不要在多处持有副本,否则必然出现不一致;
  3. 复杂对象用 @Observed:提前设计好数据结构,别等 UI 不刷新再补救;
  4. 与持久化解耦:状态层不直接写数据库,通过独立的仓储层处理。

六、小结

ArkUI 面试的核心就一句话:状态怎么变、UI 怎么跟着变、变的范围有多大。

准备时最有价值的练习:写一个带列表 + 详情 + 编辑的页面,刻意踩一遍”嵌套对象不刷新”的坑,再用 @Observed/@ObjectLink 修好。这段经历能让你在面试里自然地讲出原理,而不是复述文档。


参考:HarmonyOS 官方开发指南。装饰器语义与状态管理能力随 API 版本演进,请以华为官方文档为准。

标签

#鸿蒙面试#ArkUI#状态管理#面试

鸿蒙面试必备:Stage 模型、Ability 与 ArkTS 高频题

鸿蒙面试必备:Stage 模型、Ability 与 ArkTS 高频题
关键词Stage模型、UIAbility、AbilityStage、Want、ArkTS、鸿蒙面试

鸿蒙岗位的面试,几乎一定会从 Stage 模型与 Ability 开问。因为它决定了你对应用生命周期、进程结构与组件边界的理解深度——这是”会不会写”和”懂不懂”的分界线。

本文按高频真题组织,覆盖 Stage 模型、Ability 类型、生命周期、进程通信与 ArkTS 语言特性。

一、先讲清:什么是 Stage 模型

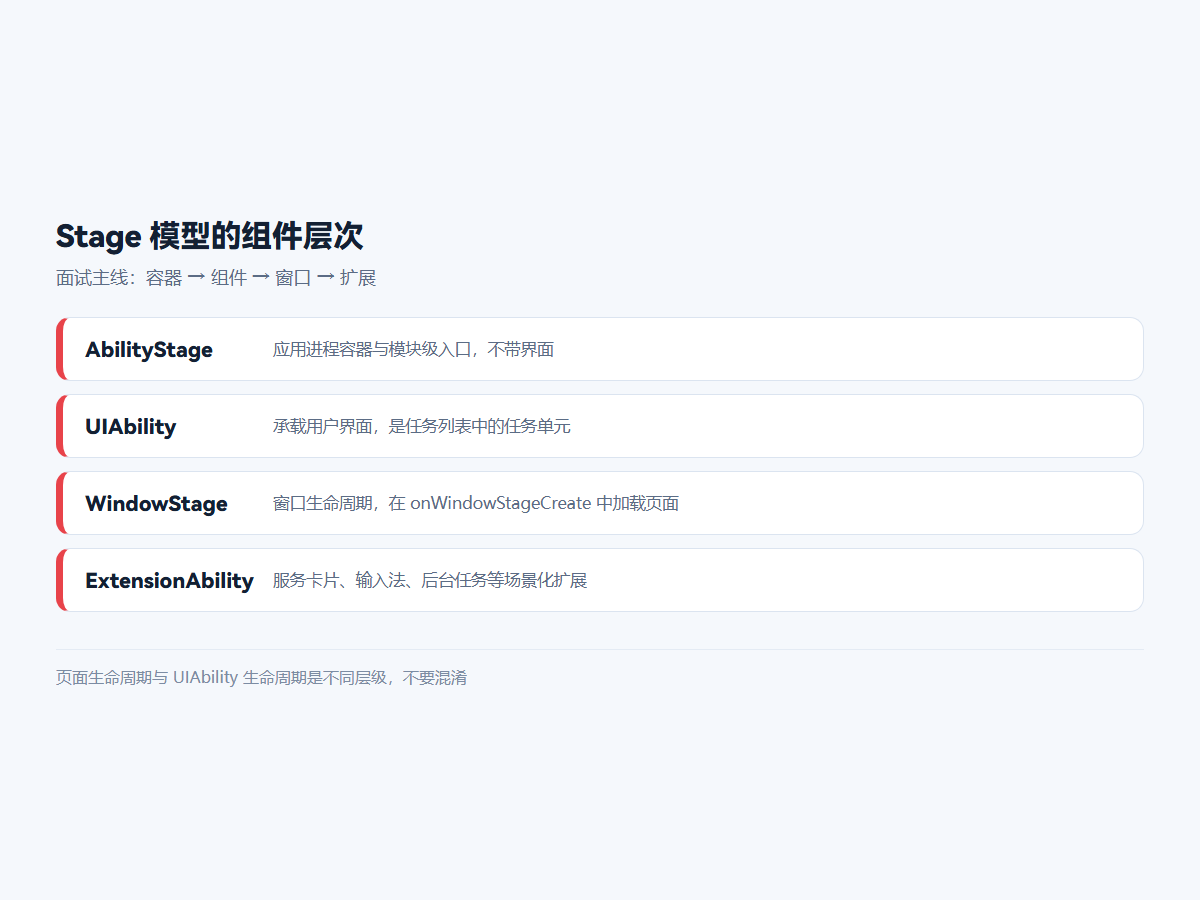
Stage 模型的组件层次
Stage 模型层次:AbilityStage 容器、UIAbility 组件、WindowStage 窗口与 ExtensionAbility 扩展

Q1:鸿蒙有哪几种应用模型?现在该用哪个?
早期有 FA(Feature Ability)模型,当前主流是 Stage 模型。Stage 模型以 AbilityStage 作为应用进程的入口与容器,向下管理各类 Ability 组件。新项目一律使用 Stage 模型。

Q2:Stage 模型相比 FA 模型的核心改进是什么?

  • 组件与进程解耦更清晰:Ability 不再直接承载窗口,窗口概念被独立出来;
  • 生命周期更细、更可控:区分了 UIAbility 的生命周期与窗口生命周期;
  • 更利于多设备与多窗口形态:同一 Ability 可对应不同窗口形态,适配折叠屏、平板、多窗口更自然;
  • 内存回收更合理:后台 Ability 可被回收而保留应用进程状态。

Q3:AbilityStage、UIAbility、ExtensionAbility 分别是什么?

概念 定位 是否带界面
AbilityStage 应用进程的容器与入口,模块级
UIAbility 承载用户界面的组件,任务列表中的任务单元
ExtensionAbility 面向特定场景的扩展组件(服务卡片、输入法、后台任务等) 视类型而定

二、生命周期:最常考的连线题

Q4:UIAbility 的生命周期有哪些回调?
核心链路:onCreateonWindowStageCreateonForegroundonBackgroundonWindowStageDestroyonDestroy

要点:onWindowStageCreate 里加载页面内容windowStage.loadContent()),onForeground/onBackground 处理前后台切换时的资源申请与释放。

export default class EntryAbility extends UIAbility {
  onCreate(want: Want, launchParam: AbilityConstant.LaunchParam) {
    // 应用级初始化
  }
  onWindowStageCreate(windowStage: window.WindowStage) {
    windowStage.loadContent('pages/Index', (err) => {
      if (err.code) { /* 处理错误 */ }
    })
  }
  onForeground() { /* 回到前台:恢复定位、传感器 */ }
  onBackground() { /* 退到后台:释放资源、保存状态 */ }
}

Q5:UIAbility 生命周期和页面(Page)生命周期的区别?
两者是不同层级:UIAbility 的生命周期由系统调度(前后台、销毁),页面生命周期则是组件内部的(onPageShowonPageHideaboutToAppearaboutToDisappear)。一个 UIAbility 可以包含多个页面,页面跳转不会触发 UIAbility 的生命周期变化。

Q6:Want 是什么?
Want 是组件间信息传递的载体,用于启动 Ability 时指定目标(bundleName、abilityName)以及携带参数。它类似于 Android 的 Intent,是面试中常被要求解释的概念。

三、ArkTS 语言特性:TS 背景也要小心

Q7:ArkTS 和 TypeScript 是什么关系?
ArkTS 是 TypeScript 的超集,在 TS 基础上强化了静态类型约束,通过方舟编译器编译为字节码运行。它不是”增强版 TS”,而是”受限并静态化的 TS”——这个措辞在面试里很加分。

Q8:ArkTS 对 TS 做了哪些限制?为什么?

  • 限制动态特性:不支持运行时动态增删对象属性、限制 anyunknown 的滥用、弱化结构类型的动态性;
  • 要求更明确的类型标注:部分场景需要显式类型;
  • 目的:让编译器能在编译期完成更多检查与优化,从而提升运行时性能、减少运行时类型判断,同时降低移动端上的不可预期行为。

Q9:structclass 在 ArkUI 里怎么用?
自定义组件用 @Component 装饰的 struct;普通业务逻辑、数据模型用 classstruct 用于描述 UI 结构,不能随意当成普通对象使用,这是新手常犯的错。

四、状态与通信:进阶考点

Q10:组件间通信有哪些方式?

  • 装饰器传递@Prop(单向)、@Link(双向)、@Provide/@Consume(跨层级);
  • 应用级状态AppStorage(应用级)、LocalStorage(页面级);
  • 持久化PersistentStorage
  • 跨 Ability:通过 Want 传参,或使用公共事件机制。

Q11:@State 的刷新机制是什么?
@State 装饰的变量变化时,驱动依赖它的组件重新渲染。注意其观测能力有边界:嵌套对象的深层属性变化、数组元素内部字段的变化,未必能被感知——需要配合 @Observed/@ObjectLink 等装饰器处理复杂数据结构。这是高频追问点。

Q12:鸿蒙的后台任务与长时任务怎么处理?
系统对后台行为有严格约束。长时间运行的任务需要申请对应的后台任务类型(如数据传输、音频播放、定位),并遵守系统配额;不应试图用隐式手段常驻后台。

五、常见追问与加分点

追问 A:“纯血鸿蒙(HarmonyOS NEXT)和之前有什么区别?”
答:NEXT 版本不再兼容安卓 APK,移除 AOSP 兼容层,应用必须使用鸿蒙原生方式(ArkTS + ArkUI)开发。“能不能直接跑安卓应用”的答案是不能,这是理解当前生态的前提。

追问 B:“怎么看待鸿蒙的分布式能力?”
答:跨设备流转、多端协同是其差异化优势,但需要按设备能力做降级设计——不是所有设备都具备全部能力,调用前需做能力判断。

六、小结

鸿蒙面试的答题主线:AbilityStage → UIAbility 生命周期 → Want 与启动 → 状态装饰器 → ArkTS 静态化特性。把这五块串起来,再准备一个自己做过的功能模块(哪怕是练手项目),基本能覆盖八成考点。

版本方面,请务必说明自己熟悉的 API 版本与 DevEco Studio 版本,并强调SDK、IDE 与目标设备的配套关系——这本身就是专业度的体现。


参考:HarmonyOS 官方开发指南HarmonyOS 版本概览。API 与模型细节请以华为官方文档为准。

标签

#鸿蒙面试#ArkTS#Ability#面试

Flutter 面试 20 问:渲染管线、状态管理与性能优化

Flutter 面试 20 问:渲染管线、状态管理与性能优化
关键词Flutter、三棵树、Widget、Element、RenderObject、状态管理、Isolate

Flutter 面试有极强的技术特征:只要你没真正理解渲染管线,后面的状态管理、性能优化题基本答不到点子上。因为几乎所有设计决策,都能从”三棵树 + 自绘”这个根上推导出来。

本文按”渲染管线 → 状态管理 → 性能 → 工程”四层,整理 20 个高频考点。

一、渲染管线:一切的起点

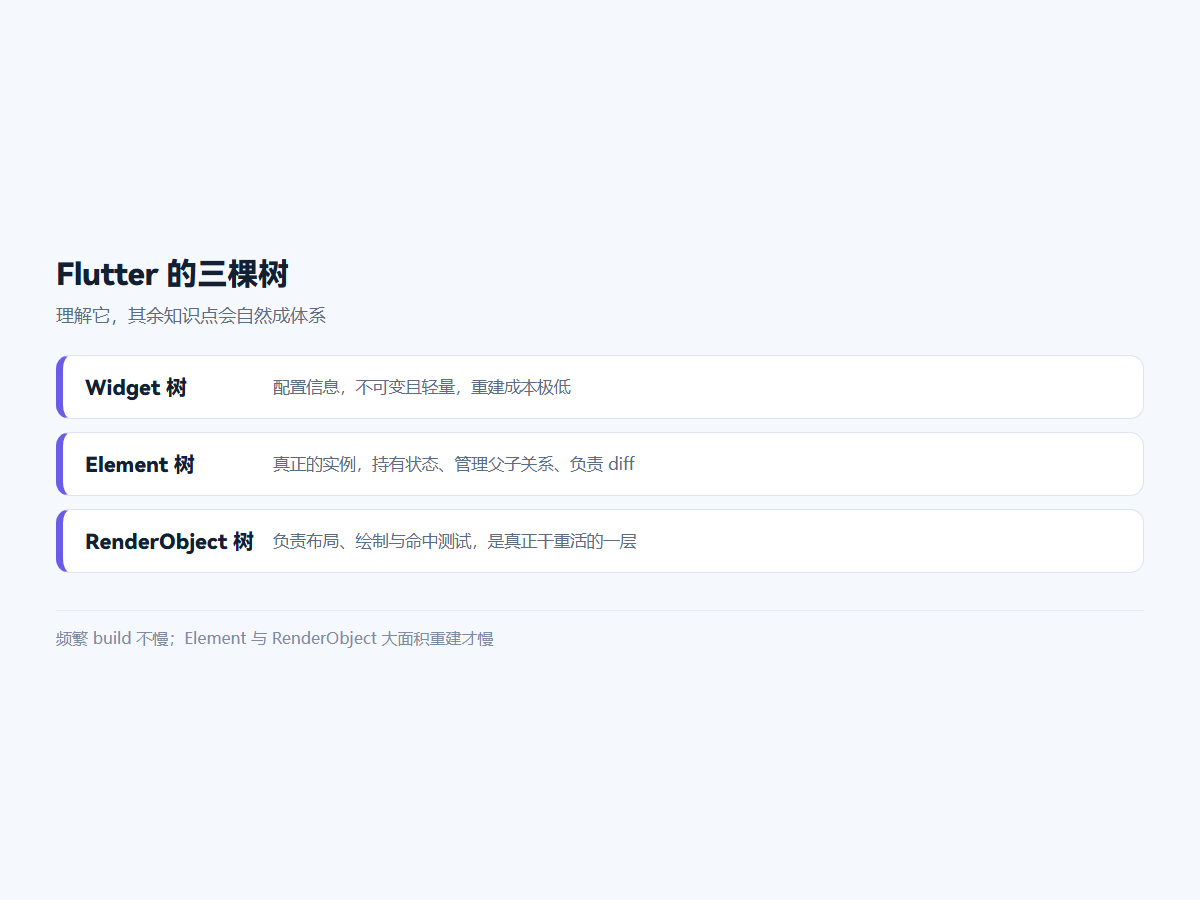
Flutter 的三棵树
Flutter 三棵树:Widget 配置、Element 实例、RenderObject 渲染

Q1:Flutter 的三棵树是什么?各自的作用?

  • Widget 树:配置信息,不可变、极其轻量,重建成本极低;
  • Element 树:真正的”实例”,负责持有状态、管理父子关系、做 diff,是连接 Widget 与 RenderObject 的桥梁;
  • RenderObject 树:负责布局(layout)、绘制(paint)、命中测试,是真正干重活的一层。

追问陷阱:“Widget 重建是不是很贵?”
不是。Widget 是不可变的配置对象,重建只是创建新对象,代价极小。真正贵的是 Element 与 RenderObject 的重建。Flutter 通过 Element 的 diff(比较 runtimeType 与 key)来决定是复用还是重建。这就是为什么”频繁 build 不慢,但让 Element 树大面积重建会很慢”。

Q2:Flutter 为什么能做到跨平台 UI 一致?
因为它不依赖系统原生控件,而是自带渲染引擎直接绘制(Skia/Impeller)。UI 由 Flutter 自己画,所以两端表现完全一致。代价是包体积更大,与原生控件混排需要平台通道。

Q3:setState 之后发生了什么?
标记对应 Element 为 dirty → 下一帧回调时重建 Widget → Element diff → 需要更新的 RenderObject 重新 layout/paint → 合成上屏。注意 setState 是同步调用,但重建发生在下一帧。

Q4:Key 有什么用?什么时候必须用?
Key 决定 Element 与 Widget 的匹配策略。当同类型 Widget 在列表中位置会变化(如删除中间项、重排序)时,必须用 Key,否则 Flutter 会错误复用 Element,导致状态串位(例如输入框内容错位)。

二、状态管理:选型题

Q5:StatelessWidget 和 StatefulWidget 的区别?
前者无可变状态,build 只依赖外部传入的配置;后者通过 State 对象持有可变状态,State 的生命周期独立于 Widget(Widget 重建时 State 可复用)。

Q6:主流状态管理方案怎么选?

方案 特点 适用
setState 最简单,重建范围大 局部、简单的页面内状态
InheritedWidget 底层机制,可跨层共享 理解原理用,业务少直接用
Provider / Riverpod 基于 InheritedWidget 封装,可精细刷新 中小型应用首选
Bloc / Cubit 事件驱动,状态流转清晰,可测试性强 中大型、业务逻辑复杂
GetX 上手快,功能全(路由/依赖注入) 追求开发速度,注意规范约束

加分答法:不要说”哪个最好”,而要说”按团队规模与业务复杂度选,关键是刷新范围要可控“。再补一句”无论用哪个,都应避免让整棵树重建”。

Q7:如何避免不必要的重建?
三层手段:① 拆分 Widget,把变化范围缩小到最小子树;② 使用 const 构造函数,让常量 Widget 编译期复用;③ 用状态管理方案的选择性重建能力(如 SelectorConsumer)。

// 反例:整个页面 build 依赖 count,购物车列表陪跑重建
Consumer<CartModel>(builder: (_, cart, __) => WholePage(cart));

// 正例:Selector 把重建范围收敛到真正依赖该状态的子树
Selector<CartModel, int>(
  selector: (_, cart) => cart.itemCount,        // 只订阅计数
  builder: (_, count, __) => Badge(child: Text("$count")),
);
// 静态部分尽量 const 化,diff 时直接跳过
const HeaderBar(title: Text("购物车"));

三、性能:面试官最爱追问的部分

Q8:Flutter 卡顿的常见原因?

  • build 方法里做重计算:build 可能一帧调用多次,任何耗时逻辑都要外移;
  • UI 线程做重活:大 JSON 解析、图片编解码应放到 Isolate
  • Shader 编译卡顿:首次出现复杂动效时编译着色器导致掉帧,需预热着色器
  • 列表未用懒加载:长列表必须用 ListView.builder 而非一次性创建全部子项;
  • 过度使用 Opacity / Clip / 阴影:会触发离屏渲染,代价高。

Q9:Isolate 是什么?和线程有什么区别?
Isolate 是 Dart 的并发单元,拥有独立内存,不共享状态,通过消息(port)通信。因为没有共享内存,不需要锁,也没有数据竞争,但传递大数据会有拷贝开销(可用 TransferableTypedData 优化)。

Q10:const 构造为什么能提升性能?
编译期常量化:相同的 const Widget 会被复用为同一个实例,同时 Flutter 在 diff 时可直接判断相等,跳过重建。在频繁重建的界面里(如动画、列表项)收益明显。

四、工程与混合开发

Q11:Platform Channel 是什么?有什么性能注意点?
Flutter 与原生通信的通道(MethodChannel / EventChannel / BasicMessageChannel)。注意:跨通道调用有编解码开销,高频调用(如每帧传传感器数据)会成为瓶颈,应改为批量传输或改用 EventChannel 流式推送。

Q12:Flutter 与原生混合开发怎么集成?
两种形态:① 原生页面嵌入 Flutter 模块(渐进迁移,常用);② Flutter 页面嵌入原生视图(通过 PlatformView,注意其性能与兼容性开销)。

Q13:包体积怎么优化?
移除未使用资源、开启代码混淆与 tree-shake 图标、按 ABI 分包、压缩 so、延迟加载非必要字体。

Q14:main() 里的 runApp 之前能做什么?
可以执行初始化(如绑定 WidgetsFlutterBinding、初始化依赖、加载配置)。注意:耗时初始化会推迟首帧,需要权衡,可做启动页过渡。

Q15:热重载和热重启的区别?
热重载(Hot Reload)把更新的代码注入正在运行的 Dart VM,保留应用状态,秒级生效;热重启(Hot Restart)重启应用,状态丢失,但比冷启动快。修改 main()、全局变量初始化等场景需要热重启。

五、答题策略

Flutter 面试有一个明显的”根节点”:三棵树的职责划分。答任何问题都可以往回靠——状态管理考察的是”如何缩小重建范围”,性能优化考察的是”哪棵树在承受代价”。

如果只能准备一个案例,建议准备:一次真实的卡顿排查(用 Performance Overlay / DevTools 发现问题 → 定位到具体 Widget → 用拆分、const 或 Isolate 解决 → 用数据验证)。这一个问题能串起整条知识链。

六、小结

把渲染管线理解透,Flutter 的其余知识会自然成体系。版本方面,Flutter 稳定版与 Dart SDK 持续快速迭代(Dart 已进入 3.x 世代),面试中不必纠结具体版本号,重点讲清机制与权衡


延伸阅读:Flutter 官方文档Dart 官方文档。版本信息以 Flutter 官方 Release 元数据为准。

标签

#Flutter#移动端面试#Dart#面试

移动端面试高频:启动流程、内存管理与 ANR/OOM 排查

移动端面试高频:启动流程、内存管理与 ANR/OOM 排查
关键词冷启动、Zygote、内存泄漏、ANR、OOM、卡顿排查、移动端面试

移动端面试有两类问题最能区分水平:一类是能不能讲清系统启动的完整链路(说明你理解平台),另一类是遇到线上崩溃/卡死能否给出排查路径(说明你真的做过项目)。

本文把这两块的高频真题整理成可背诵、可延伸的答题框架。

一、启动流程:两张流程图

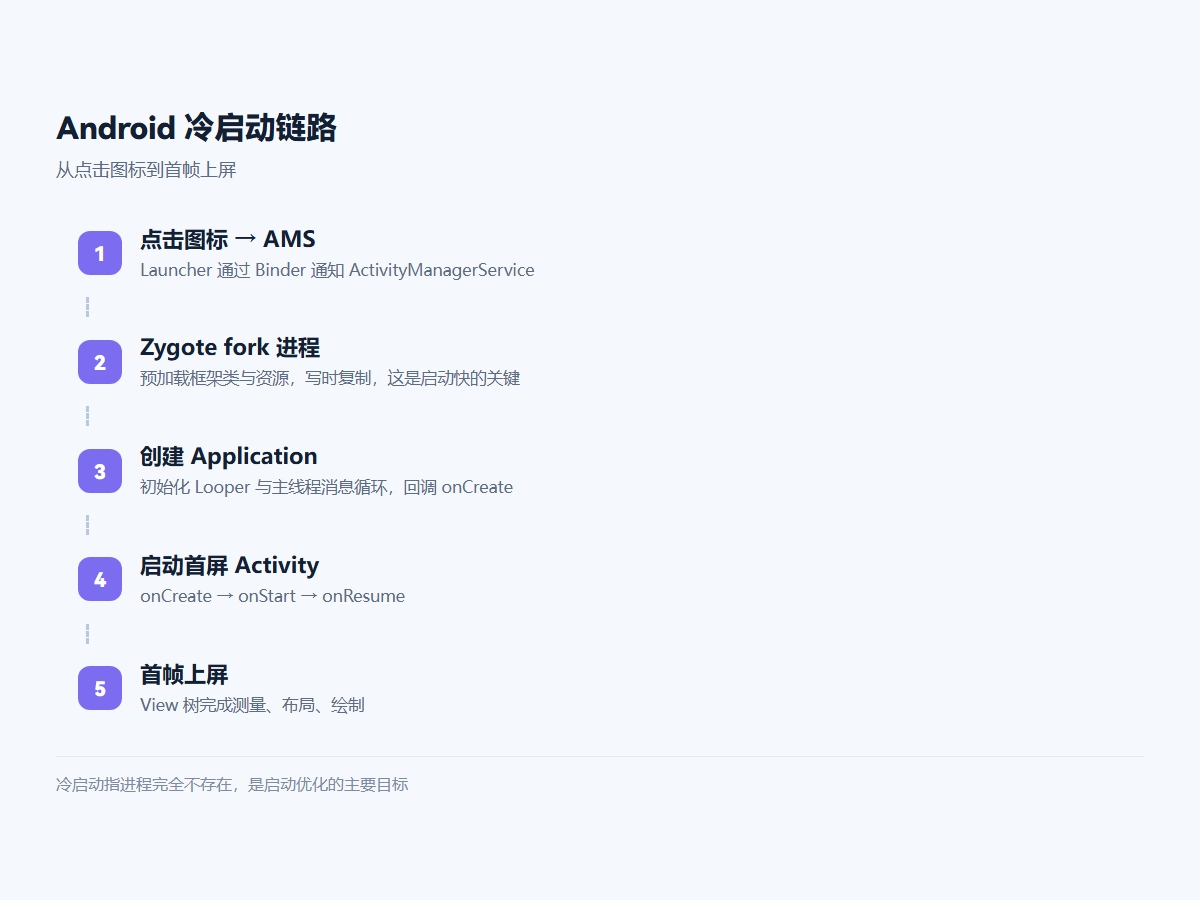
Android 冷启动链路
Android 冷启动链路:AMS → Zygote fork → Application → Activity → 首帧上屏

Android 启动链路

  1. 点击图标 → Launcher 通过 Binder 通知 ActivityManagerService(AMS);
  2. AMS 检查目标进程是否存在,不存在则通过 Zygote fork 出新进程(Zygote 预加载了框架类与资源,这是 fork 快的原因);
  3. 新进程创建 ActivityThread,执行 main(),初始化 Looper 与主线程消息循环;
  4. AMS 通知进程创建 Application,回调 onCreate()
  5. 启动首屏 Activity:依次回调 onCreate → onStart → onResume
  6. View 树完成测量、布局、绘制后,首帧上屏,冷启动结束。

追问:“为什么要有 Zygote?”
因为 fork 时子进程继承父进程的内存。Zygote 预加载了系统框架类与常用资源,fork 出的应用进程直接共享这些内容(写时复制),省去重复加载的时间与内存。这是 Android 启动优化的基础设计。

iOS 启动链路

  1. exec() 加载 Mach-O 可执行文件;
  2. dyld 加载动态库(dylib),完成符号绑定与 rebase/bind;
  3. 运行 Objective-C/Swift 运行时初始化(注册类、分类、+load);
  4. 调用 main()UIApplicationMain,建立主 RunLoop;
  5. AppDelegate 回调系列方法,最终渲染首屏。

Q:冷启动、温启动、热启动的区别?
冷启动是进程完全不存在,需要完整创建;温启动是进程存在但 Activity 需重建;热启动是应用已在后台,直接切回前台。优化目标通常指冷启动

二、内存管理:必考的核心机制

Q:Android 与 iOS 的内存管理机制有何不同?

维度 Android(ART) iOS
回收方式 GC(垃圾回收),分代 + 并发标记 ARC(自动引用计数)
释放时机 由 GC 决定,非确定性 引用计数归零立即释放
典型泄漏 长生命周期对象持有 Activity/Context 循环引用(尤其闭包捕获 self)
排查工具 Android Profiler、LeakCanary、MAT Instruments、Xcode Memory Graph

Q:Android 内存泄漏最常见的原因?

  • 静态变量持有 Activity 或 View;
  • 内部类/匿名类持有外部 Activity 引用(Handler 延迟消息是最经典场景);
  • 未注销的监听器(广播、回调、EventBus);
  • 资源对象未关闭(Cursor、文件流、Bitmap 未回收)。
// 典型泄漏:Handler 隐式持有 Activity,延迟消息未处理完则 Activity 无法回收
class MyActivity : Activity() {
    private val handler = Handler(Looper.getMainLooper())
    override fun onCreate(b: Bundle?) {
        handler.postDelayed({ /* ... */ }, 60_000)
    }
}
// 修复:静态内部类 + WeakReference,并在 onDestroy 移除所有回调

Q:iOS 的循环引用怎么产生?怎么破?
对象 A 强引用 B、B 又强引用 A,引用计数永不归零。闭包捕获 self 是最常见场景。解法:用 weak / unowned 打破环(Swift 中常写 [weak self]);delegate 一律用 weak 修饰。

三、ANR 与 OOM:线上问题排查

Q:ANR 是怎么触发的?怎么排查?
Android 中主线程在规定时间内未响应即触发 ANR:输入事件 5 秒内未处理完、BroadcastReceiver 10 秒、Service 生命周期 20 秒

排查路径:

  1. 导出 /data/anr/traces.txt,查看主线程的堆栈;
  2. 看主线程是在做耗时任务(大量计算、I/O),还是阻塞在锁或 Binder 调用上;
  3. 结合 CPU 使用率判断:CPU 高说明在忙,CPU 低却 ANR 说明被阻塞;
  4. 线上接入 ANR 监控(WatchDog 或官方 API)采集堆栈。

Q:OOM 有哪些类型?怎么优化?

  • Java 堆 OOM:对象太多或泄漏,用 Profiler 抓堆转储分析;
  • 内存抖动:短时间频繁创建销毁对象,触发频繁 GC,表现为卡顿;
  • 大图 OOM:图片未按显示尺寸采样(inSampleSize)、未及时回收;
  • 线程 OOM:线程数超上限,每个线程都占栈内存,需用线程池收敛;
  • 文件描述符耗尽:流未关闭,表现为 Too many open files。

四、卡顿排查的通用方法论

Q:线上卡顿怎么定位? 一个通用四步法:

  1. 监控采集:用 Choreographer 帧回调或 CADisplayLink 计算掉帧率,超过阈值时采样主线程堆栈;
  2. 聚合归因:把大量堆栈按栈顶聚合,找出高频耗时函数(而不是看单次样本);
  3. 工具深挖:Android 用 Perfetto/System Trace,iOS 用 Instruments Time Profiler;
  4. 解法归类:主线程耗时 → 异步化或延迟;布局复杂 → 扁平化;频繁创建对象 → 复用池;锁竞争 → 缩小锁粒度。

加分答法:提到”监控要有采样率控制,否则监控本身会造成卡顿”,以及”先看聚合后的 Top 问题,不要陷入单次调用栈“。这两点说明你有线上经验。

五、小结

移动端面试的启动、内存、卡顿三块,共同的答题结构是:讲清系统机制 → 指出常见成因 → 给出排查路径 → 落到具体工具与代码

最有效的备考方式:拿自己的项目跑一遍 Profiler / Instruments,找一个真实的性能问题并解决掉。面试官问细节时,这段经历会让你的回答立刻变得可信。


参考:Android 性能官方文档Apple 性能调优文档。版本与工具行为以官方文档为准。

标签

#移动端面试#Android#iOS#面试