loader

Nerio News Magazine brings you trusted, timely and thought-provoking stories from around the globe.

Follow Us

MySQL 与 Redis 面试攻坚:索引、锁、缓存一致性

MySQL 与 Redis 面试攻坚:索引、锁、缓存一致性
关键词MySQL索引、B+Tree、间隙锁、隔离级别、Redis、缓存一致性、缓存穿透

MySQL 与 Redis 几乎是后端面试的必考组合:前者考察你对存储引擎与并发控制的理解,后者考察你对缓存设计与一致性的把握。两者结合的那道”缓存一致性”题,更是区分初中高级的分水岭。

本文按高频真题组织,每题给出标准答法与追问陷阱。

一、索引:从数据结构问到优化
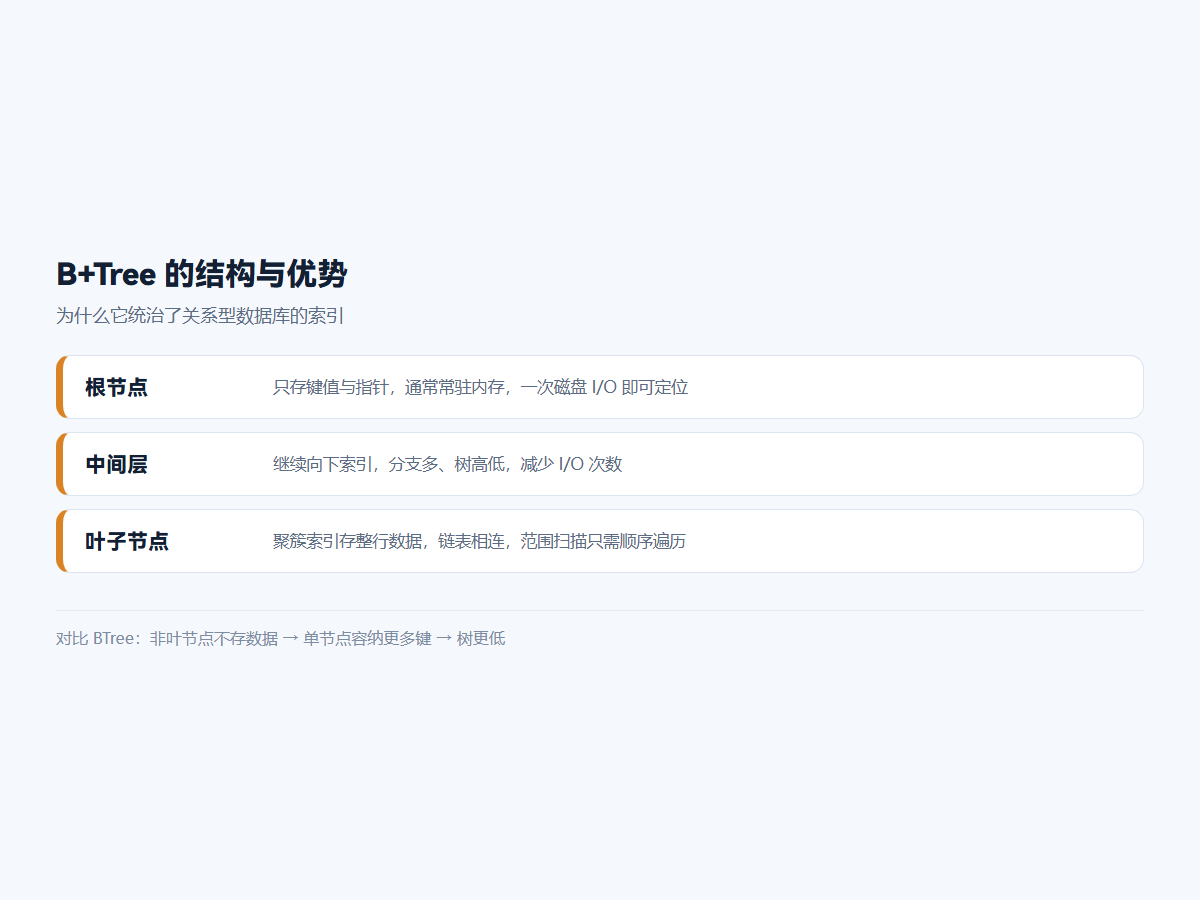
B+Tree 的结构与优势
B+Tree 结构:非叶子节点只存键值,叶子节点存数据并链表相连

Q1:为什么 MySQL 用 B+Tree 而不是 BTree 或哈希?

  • 对比哈希:哈希只支持等值查询,不支持范围查询与排序,而业务里 BETWEENORDER BY 极其常见;
  • 对比 BTree:B+Tree 的非叶子节点只存键值不存数据,因此单个节点能容纳更多键,树高更低、磁盘 I/O 次数更少
  • B+Tree 的叶子节点用链表相连,范围扫描只需顺序遍历叶子节点,效率极高。

Q2:聚簇索引和二级索引的区别?什么是回表?
InnoDB 中,聚簇索引的叶子节点存整行数据(按主键组织);二级索引的叶子节点存主键值。通过二级索引查到主键后,再到聚簇索引取完整行,这个过程叫回表

追问:“怎么避免回表?” → 覆盖索引:让查询的字段都包含在索引里,EXPLAIN 中会出现 Using index

Q3:最左前缀原则是什么?
对联合索引 (a, b, c),查询条件必须从最左列开始连续匹配才能用上索引。a=1 AND b=2 可用;b=2 不可用;a=1 AND c=3 只能用到 a 部分。注意:范围查询之后的列无法继续走索引

Q4:哪些情况索引会失效?

  • 对索引列做函数运算或隐式类型转换(如 WHERE YEAR(created_at)=2026、字符串列传数字);
  • 使用 LIKE '%xxx' 前置通配符;
  • 违反最左前缀;
  • OR 连接的条件中存在未建索引的列;
  • 优化器判断回表代价过高(如命中行数占比太大)时选择全表扫描。

二、锁与事务隔离

Q5:InnoDB 有哪几种行锁?

  • 记录锁(Record Lock):锁单条索引记录;
  • 间隙锁(Gap Lock):锁索引记录之间的间隙,防止插入;
  • 临键锁(Next-Key Lock):记录锁 + 间隙锁,锁”左开右闭”区间,是 InnoDB 默认行锁算法。

Q6:为什么有间隙锁?
为了解决幻读。在可重复读(RR)隔离级别下,间隙锁阻止在范围内插入新记录,从而保证同一事务内两次范围查询结果一致。

Q7:RR 和 RC 的区别?生产选哪个?

隔离级别 幻读 间隙锁 并发度
RC(读已提交) 存在 基本不使用 高,锁冲突少
RR(可重复读) 靠 MVCC + 间隙锁避免 使用 较低,死锁概率高

互联网业务常选 RC:并发度更高、死锁更少,幻读问题通过业务设计规避。

Q8:死锁怎么排查与避免?
排查用 SHOW ENGINE INNODB STATUS 查看最近死锁日志;避免手段:固定加锁顺序、缩短事务、减少锁定范围、合理设计索引(没索引会升级为表锁)。

三、Redis:数据结构与过期

Q9:Redis 为什么快?
四点:① 纯内存操作;② 单线程模型避免锁与上下文切换(指命令执行主线程);③ I/O 多路复用;④ 高效数据结构。注意补充:Redis 后期版本引入了多线程处理网络 I/O,但命令执行仍是单线程。

Q10:缓存穿透、击穿、雪崩分别是什么?怎么解决?

问题 现象 解法
穿透 查不存在的数据,绕过缓存直击 DB 布隆过滤器、缓存空值(短 TTL)、参数校验
击穿 单个热点 key 过期瞬间大量请求打穿 互斥锁重建、逻辑过期(永不过期 + 后台刷新)
雪崩 大量 key 同时过期 TTL 加随机抖动、多级缓存、限流降级

Q11:内存满了怎么办?淘汰策略怎么选?
常用:allkeys-lru(所有 key 中淘汰最近最少用)、volatile-lru(只在设了过期时间的 key 中淘汰)、allkeys-lfu(淘汰最不经常使用,适合有明显热点且希望保留高频访问数据的场景)。若数据不允许丢失,应设为 noeviction 并配合监控扩容。

四、缓存一致性:核心难题

Q12:先更新数据库还是先删缓存?
推荐 先更新数据库,再删除缓存(Cache-Aside)。原因:如果先删缓存再更新数据库,在删除后、更新完成前的并发读会把旧值重新写回缓存,导致长期不一致——这个概率远高于另一种顺序。

Q13:删缓存失败了怎么办?
三层保障:① 重试机制;② 订阅数据库 binlog 异步删除(如 Canal 类方案);③ 设置较短的过期时间兜底。第二点是生产环境的常见做法:

// Cache-Aside 标准写法:更库 + 删缓存,失败进重试队列
public void updateItem(Item item) {
    itemMapper.update(item);                       // 1. 先更库
    boolean ok = redis.delete(key(item.getId()));  // 2. 再删缓存
    if (!ok) {
        retryQueue.offer(new CacheEvictTask(item.getId(),
            System.currentTimeMillis() + backoff()));  // 3. 失败重试
    }
}
// 兜底:Canal 订阅 binlog 的 row_change 事件再删一次,
// 即使应用层两次都失败,最终也会被 binlog 驱动的删除修正

Q14:能做到强一致吗?
能,但代价是加锁串行化(读时加读锁、写时加写锁),吞吐会大幅下降。绝大多数业务的正确选择是最终一致 + 过期时间 + 监控对账

加分答法:主动说明”缓存的作用是提升读性能,不应承担强一致职责。如果业务要求强一致,应该考虑读写分离到主库,而不是给缓存加复杂的同步逻辑。”

五、小结

MySQL 部分的答题主线是 B+Tree → 索引优化 → 锁与隔离级别;Redis 部分是 数据结构 → 过期与淘汰 → 三大缓存问题 → 一致性

准备时最有效的方法是:把每个结论都用 EXPLAIN 或 Redis 命令实际验证一遍。面试时能说出”我用 EXPLAIN 看过,这个查询没走索引是因为隐式类型转换”,比背诵十条规则更有说服力。


版本参考:MySQL LTS 版本信息见 endoflife.date,Redis 版本见 endoflife.date;采集于 2026 年 9 月 1 日。实现细节请以 MySQL 官方文档Redis 官方文档 为准。

标签

#MySQL#Redis#后端面试题#数据库
后端面试真题:分布式事务与一致性,面试官的 12 个追问

后端面试真题:分布式事务与一致性,面试官的 12 个追问
关键词分布式事务、2PC、TCC、Saga、幂等、最终一致性、CAP

“分布式事务怎么保证一致性?”——这道题的难点不在于说出几种方案,而在于能扛住面试官一连串的追问:你的方案在部分失败时怎么办?补偿失败了怎么办?怎么保证幂等?

本文按真实追问链组织,12 个问题层层递进,覆盖从理论到落地的完整路径。

一、先问清楚:为什么要分布式事务

Q1:为什么单体事务(本地事务)不能直接用于微服务?
本地事务依赖单个数据库连接的 ACID。微服务下数据分散在不同库、不同服务,一次业务操作可能要改多个库,本地事务管不到别人的库。

Q2:CAP 到底在说什么?
在网络分区(P)不可避免的前提下,只能在一致性(C)与可用性(A)之间取舍。注意常见误区:CAP 不是”三选二”的简单开关,而是在分区发生时的取舍,正常状态下系统可以同时保证 CA。

Q3:BASE 理论怎么理解?
基本可用(Basically Available)、软状态(Soft state)、最终一致性(Eventually consistent)。它的工程含义是:接受短暂不一致,用补偿与对账换取可用性——这是绝大多数互联网业务的实际选择。

二、方案对比:四选一

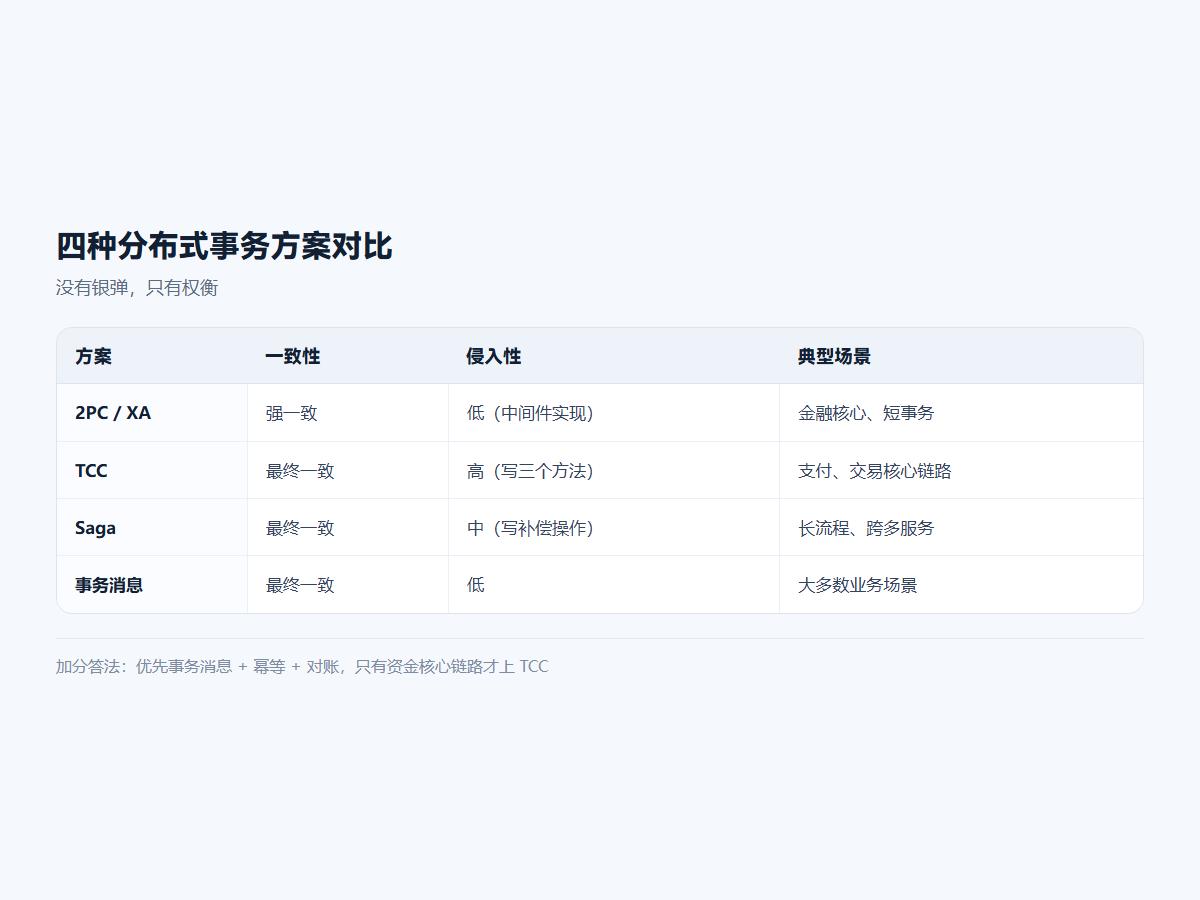
四种分布式事务方案对比
四种分布式事务方案对比:一致性与侵入性、性能的取舍

Q4:2PC(两阶段提交)有什么问题?
协调者故障会导致参与者一直锁定资源(阻塞);第二阶段协调者宕机可能出现部分提交的数据不一致。它的优点是强一致、实现简单(如 XA 事务),缺点是性能差、可用性低。

Q5:TCC 是什么?和 2PC 的区别?
TCC 是业务层面的两阶段:Try(预留资源)→ Confirm(确认)或 Cancel(释放)。区别在于:2PC 在数据库层锁资源,TCC 在业务层做预留,锁粒度更细、性能更好,但需要为每个操作写三套代码,侵入性极强。

Q6:Saga 模式怎么工作?
把长事务拆成一系列本地事务,每个步骤都有对应的补偿操作。任一失败时,反向执行已完成步骤的补偿。优点是不长期占锁、适合长流程;缺点是缺乏隔离性,可能出现”脏读”(看到中间状态)。

Q7:本地消息表 / 消息队列事务消息怎么做?
核心是把”业务操作”与”消息发送”放在同一个本地事务里:先写业务数据 + 消息表,再由投递任务把消息发出去,消费方保证幂等。这是落地成本最低、使用最广的最终一致方案。

-- 同一个本地事务里写业务数据与消息记录
BEGIN;
UPDATE account SET balance = balance - 100 WHERE id = 1;
INSERT INTO local_message(id, topic, payload, state)
VALUES (uuid(), "topic-transfer", '{"from":1,"to":2,"amt":100}', "INIT");
COMMIT;

-- 异步投递任务:只投递 INIT 状态且达到重试间隔的消息
SELECT id, payload FROM local_message
 WHERE state = "INIT" AND next_retry <= now()
 LIMIT 100 FOR UPDATE SKIP LOCKED;  -- 多实例防重复投递
-- 投递成功置 SENT,失败累加 retry_count 并按退避推后 next_retry
方案 一致性 侵入性 性能 典型场景
2PC / XA 强一致 低(中间件做) 金融核心、短事务
TCC 最终一致 高(写三个方法) 较好 支付、交易核心链路
Saga 最终一致 中(写补偿) 长流程、跨多服务
事务消息 最终一致 大多数业务场景

三、追问区:这里才是分水岭

Q8:补偿失败了怎么办?
三层防线:① 补偿操作必须可重试(幂等);② 重试要有最大次数与退避策略;③ 超过阈值进入人工干预队列并告警。任何分布式事务方案都必须设计”最终兜底”,否则就是定时炸弹。

Q9:怎么保证幂等?
常见四种手段:

  • 唯一键/唯一索引:数据库层兜底,最可靠;
  • 去重表:用业务唯一 ID 记录已处理的请求;
  • 状态机:只允许特定状态迁移(如”待支付 → 已支付”),重复请求因状态不符被拒绝;
  • Token 机制:前置申请一次性令牌,服务端校验后删除。

Q10:消息会丢失吗?怎么保证不丢?
三个环节都要防:
生产端——事务消息或本地消息表 + 确认机制;
broker 端——持久化 + 多副本;
消费端——先执行业务再提交位点(注意这样会产生重复消费,所以幂等是必须的)。

Q11:怎么保证消息顺序?
只在需要保证顺序的业务键上路由到同一分区(如同一订单 ID 的消息进同一分区),同时消费端串行处理该分区。全局有序代价极高,业务上几乎不需要。

Q12:最终一致怎么验证一致性没被破坏?
对账是最后一道防线:定时比对上下游数据(如订单与账单),发现差异自动修复或告警。同时建立一致性监控指标(如悬停事务数量、补偿失败率),纳入告警。

加分答法:主动说出”我们优先用事务消息 + 幂等 + 对账这套组合,只有在资金核心链路才上 TCC”。这说明你在权衡,而不是堆砌名词。

四、一个完整的答题框架

被问到”如何设计 X 场景的事务”时,按这个顺序答:

  1. 先确认一致性要求:是否必须强一致?能否接受秒级/分钟级延迟?这一步决定方案区间;
  2. 给出方案及理由:说明为什么选它、放弃了什么;
  3. 说明失败处理:重试、幂等、补偿、兜底;
  4. 补充验证机制:对账与监控指标;
  5. 提一句降级:极端情况下能否走人工流程。

五、小结

分布式事务没有银弹,只有权衡。面试中真正拉开差距的,不是知道多少种协议,而是能否说清”为什么在这个场景选这个方案,以及它失败时会怎样“。

记住一句话:能用最终一致解决的,别上强一致;必须强一致的,把范围缩到最小。


延伸阅读: microservices.io · Saga 模式。方案实现细节请以所使用的消息队列与框架官方文档为准。

标签

#分布式#后端面试题#事务#面试

JavaScript 面试硬题:事件循环、闭包、原型与 this 的 15 道追问

JavaScript 面试硬题:事件循环、闭包、原型与 this 的 15 道追问
关键词事件循环、宏任务、微任务、闭包、原型链、this、Promise

事件循环、闭包、原型、this——JavaScript 面试的”四大名捕”。它们之所以常考,不是因为偏,而是因为这四块直接决定了你写的异步代码会不会出诡异 bug

本文用 15 道递进式题目,把每个概念的常见误解与追问陷阱一次讲透。

一、事件循环:先分清两个队列

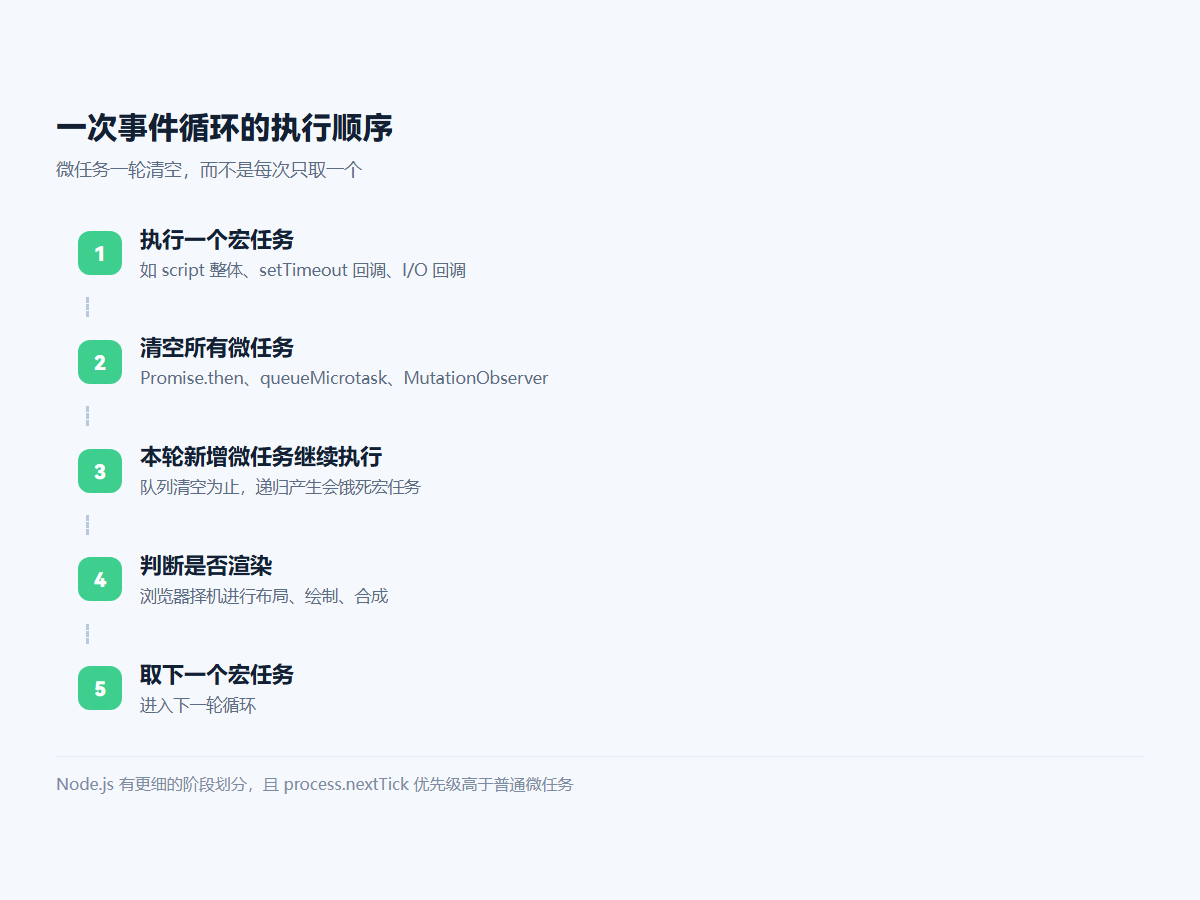
一次事件循环的执行顺序
事件循环:执行一个宏任务 → 清空所有微任务 → 渲染 → 下一个宏任务

Q1:宏任务和微任务的执行顺序是怎样的?
一次事件循环:执行一个宏任务 → 清空所有微任务 → (可能)渲染 → 取下一个宏任务。关键是微任务会被一次性清空,而不是每次只取一个。

console.log('1')

setTimeout(() => console.log('2'), 0)

Promise.resolve().then(() => console.log('3'))
  .then(() => console.log('4'))

console.log('5')

// 输出:1 5 3 4 2

解释:同步代码输出 1、5;然后清空微任务队列,链式 then 产生的 3 和 4 都在同一轮清空;最后执行宏任务 setTimeout,输出 2。

Q2:微任务里再产生微任务会怎样?
在本轮继续被执行,直到队列为空。这意味着递归产生微任务会饿死宏任务,页面卡死。这是面试里区分”背过”和”懂了”的关键追问。

Q3:async/await 在事件循环里怎么算?
await 后面的代码相当于放进 .then() 里,属于微任务。但要注意:多个 await 串联会产生多轮微任务,顺序题里最容易错在这里。

Q4:Node.js 和浏览器的事件循环一样吗?
不一样。Node 有更细的阶段划分(timers、poll、check 等),且有 process.nextTick,其优先级高于普通微任务。答”完全一样”是常见失分点。

二、闭包:不止是”函数套函数”

Q5:闭包到底是什么?
闭包是函数与其定义时所在词法环境的组合。只要内部函数持有对外部变量的引用,且该函数在其词法作用域之外被调用,闭包就产生了。

Q6:经典陷阱题——循环里的闭包。

for (var i = 0; i < 3; i++) {
  setTimeout(() => console.log(i), 0)
}
// 输出:3 3 3(var 是函数作用域,共享同一个 i)

for (let i = 0; i < 3; i++) {
  setTimeout(() => console.log(i), 0)
}
// 输出:0 1 2(let 为每次迭代创建新的绑定)

追问:“不用 let 怎么修?” → 用 IIFE 创建新的函数作用域,或用 setTimeout 的第三个参数传值。

Q7:闭包会导致内存泄漏吗?
闭包本身不会”泄漏”,它只是让变量无法被回收。真正的问题是被闭包持有的大对象(如整个 DOM 子树、缓存数组)一直不被释放。解法是解除引用或缩小捕获范围,而不是不用闭包。

三、原型与继承:把三张关系图记牢

Q8:__proto__prototype 的区别?

  • prototype函数才有的属性,指向该函数作为构造函数时创建实例的原型对象;
  • __proto__对象都有的内部属性(标准写法是 Object.getPrototypeOf()),指向其原型;
  • 关系:obj.__proto__ === Constructor.prototype

Q9:属性查找的完整链路?
先在对象自身找 → 找不到沿 __proto__ 到原型对象 → 继续沿原型链向上 → 直到 null 返回 undefined

Q10:new 一个函数时发生了什么?

  1. 创建一个新空对象;
  2. 把该对象的 __proto__ 指向构造函数的 prototype
  3. 以该对象为 this 执行构造函数;
  4. 若构造函数返回对象则用该对象,否则返回新创建的对象。

Q11:ES6 class 是语法糖吗?
本质上是基于原型的语法糖,但有实质差异:class 必须用 new 调用、方法不可枚举、内部默认严格模式、有 extendssuper 的语义。答”纯粹的语法糖”会被追问。

四、this:四种绑定规则的优先级

Q12:this 的绑定规则有哪些?优先级如何?

  1. new 绑定:this 指向新创建的对象;
  2. 显式绑定call / apply / bind
  3. 隐式绑定:作为对象方法调用时,指向该对象;
  4. 默认绑定:非严格模式指向全局对象,严格模式为 undefined

Q13:箭头函数的 this 有什么特殊?
箭头函数没有自己的 this,它在定义时捕获外层作用域的 this,且无法通过 call/apply/bind 改变,也不能用作构造函数。

const obj = {
  name: 'obj',
  normal() { console.log(this.name) },
  arrow: () => console.log(this?.name)
}
obj.normal()  // 'obj'
obj.arrow()   // undefined(this 来自模块/全局作用域)

追问:“为什么类方法用箭头函数就能稳定 this?” → 因为箭头函数捕获了构造函数作用域中的 this(即实例),不随调用方式改变。代价是该方法成为实例属性而非原型方法,每个实例一份,内存略增。

五、综合题:把四个知识点串起来

Q14:手写 Promise.all 要注意什么?
三个要点:并发发起、结果按输入顺序返回(而非完成顺序)、任一失败立即 reject。还要处理传入非 Promise 值的情况(用 Promise.resolve 包装),以及空数组应 resolve 空数组

Promise.myAll = function (list) {
  return new Promise((resolve, reject) => {
    const res = new Array(list.length)
    let count = 0
    if (list.length === 0) return resolve(res)
    list.forEach((p, i) => {
      Promise.resolve(p).then(
        v => { res[i] = v; if (++count === list.length) resolve(res) },
        reject
      )
    })
  })
}

Q15:为什么 0.1 + 0.2 !== 0.3
因为 JS 用 IEEE 754 双精度浮点数表示数字,部分十进制小数无法被二进制精确表示,相加后产生微小误差。工程解法:比较时用容差(Math.abs(a-b) < Number.EPSILON * k),金额场景用整数分或专用十进制库。

六、小结

这四块知识点有一个共同特点:都能用一段短代码验证。面试准备时不要只背结论,把每道题的代码在控制台跑一遍、改动一下再跑,理解会比背十遍更牢。

答题时记住一个原则:先给结论,再给机制,最后补一句工程上的注意事项。这样的回答结构清晰,也最容易拿到加分。


参考:MDN · JavaScript 参考文档。语言行为以 ECMAScript 最新规范与 MDN 为准。

标签

#JavaScript#前端面试题#面试

前端面试高频真题:浏览器渲染流水线与性能优化 20 问

前端面试高频真题:浏览器渲染流水线与性能优化 20 问
关键词浏览器渲染、重排、重绘、LCP、INP、CLS、前端面试题

“从输入 URL 到页面显示”是前端面试的常青题,但大多数人只能背出流程,一旦被追问到渲染流水线的具体阶段、每层优化的落点、以及如何量化效果就卡壳了。

本文按真实面试的追问深度,把渲染与性能这一块拆成 20 个高频考点,每题给出”标准答法 + 追问陷阱”。

一、渲染流水线:先背熟这张图

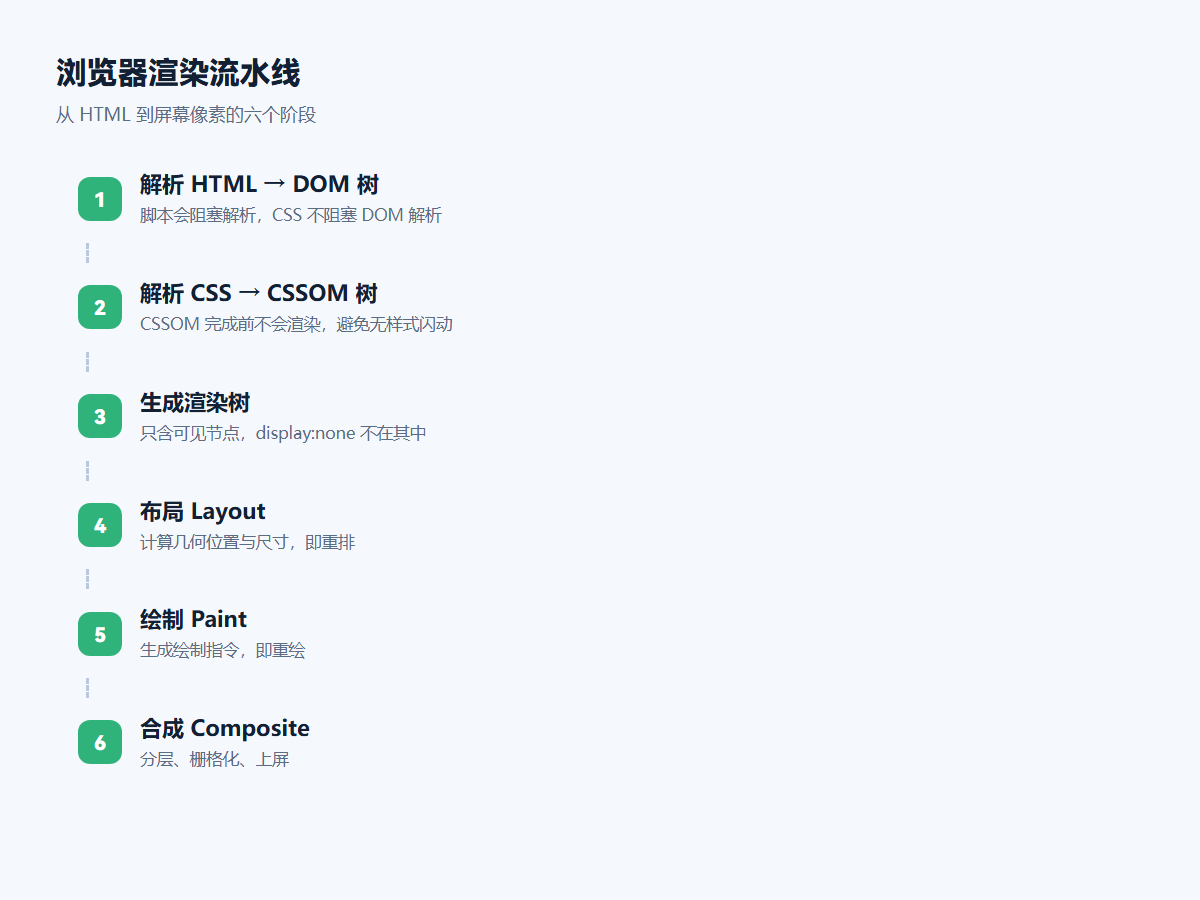
浏览器渲染流水线
浏览器渲染流水线:解析、构建渲染树、布局、绘制、合成到上屏

浏览器把 HTML 变成屏幕像素,大致经过这些阶段:

  1. 解析 HTML → 构建 DOM 树;
  2. 解析 CSS → 构建 CSSOM 树;
  3. DOM + CSSOM → 生成渲染树(Render Tree);
  4. 布局(Layout / Reflow) → 计算每个节点的几何位置与尺寸;
  5. 绘制(Paint) → 生成绘制指令;
  6. 合成(Composite) → 分层、栅格化、最终上屏。

追问陷阱:“渲染树和 DOM 树有什么区别?”
答:渲染树只包含可见节点display: none 的节点不在渲染树中,而 visibility: hidden 的节点仍在(它占空间、只是不可见)。此外 <head><script> 等不产生可见盒子的节点也不包含。

二、重排与重绘:面试必考

Q3:什么是重排(Reflow)和重绘(Repaint)?
重排是几何属性变化(尺寸、位置、增删节点),需要重新计算布局;重绘是外观变化(颜色、背景、阴影),不涉及几何。重排一定触发重绘,重绘不一定触发重排。

Q4:哪些操作会触发重排?
改变窗口大小、增删 DOM、修改宽高/边距/字体、读取 offsetTop/scrollTop/getComputedStyle 等布局信息。

Q5:什么叫布局抖动(Layout Thrashing)?
在循环里交替进行”写样式”和”读布局”,导致浏览器被迫反复重新计算布局。解法是读写分离:先批量读,再批量写;或用 requestAnimationFrame 包裹。

// ❌ 每次循环都强制同步布局
items.forEach(el => {
  el.style.width = '100px'
  console.log(el.offsetHeight)   // 读取触发重排
})

// ✅ 先读后写
const heights = items.map(el => el.offsetHeight)
items.forEach(el => { el.style.width = '100px' })

三、合成层与 GPU 加速

Q6:为什么 transform 动画比改 left/top 流畅?
因为 transformopacity 的变化可以只走合成阶段,跳过布局与绘制,且能在合成线程执行,不阻塞主线程。改 left/top 会触发完整的重排 + 重绘。

Q7:will-change 该不该滥用?
不该。它会让浏览器提前为该元素创建独立的合成层,占用额外内存。只在动画开始前加,动画结束后移除;长期挂在大量元素上会显著增加内存压力。

四、脚本加载:三道题连问

Q8:<script> 为什么会阻塞渲染?
因为脚本可能修改 DOM/CSSOM,浏览器会暂停解析等待脚本下载执行完毕。

Q9:deferasync 的区别?

属性 下载 执行时机 顺序保证
阻塞解析 下载完立即执行 按文档顺序
async 并行 下载完立即执行 不保证
defer 并行 DOM 解析完成后、DOMContentLoaded 前 按文档顺序

Q10:CSS 会阻塞渲染吗?
会。CSSOM 构建完成前不会渲染(避免无样式闪动),但 CSS 不阻塞 DOM 解析。注意:外链脚本会等待其之前的样式表加载完成,因为脚本可能查询样式。

五、性能指标:2026 年该答哪些

Q11:Core Web Vitals 有哪三个核心指标?

  • LCP(最大内容绘制):衡量加载速度,良好阈值 ≤ 2.5s;
  • INP(交互到下次绘制):衡量交互响应,良好阈值 ≤ 200ms(它已取代早期的 FID);
  • CLS(累积布局偏移):衡量视觉稳定性,良好阈值 ≤ 0.1。

追问陷阱:“FID 和 INP 有什么区别?”
FID 只测量首次交互的延迟;INP 测量页面生命周期内几乎所有交互的响应时间,取较差的分位值。INP 更能反映真实体验,这也是它被替换进核心指标的原因。

Q12:DOMContentLoadedload 的区别?
前者是 DOM 解析完成(不等图片等子资源);后者是所有资源加载完成

六、优化手段:按阶段归类

Q13–Q20 速答:

阶段 手段 解决的指标
网络 HTTP/3、资源压缩、CDN、预连接 LCP
解析 关键 CSS 内联、脚本 defer、减少阻塞 LCP、FCP
渲染 图片尺寸占位、字体 fallback 匹配 CLS
脚本 长任务拆分、scheduler.yield、Web Worker INP
列表 虚拟滚动、分页、内容可见性优化 INP、LCP
图片 AVIF/WebP、懒加载、响应式尺寸 LCP
缓存 强缓存 + 协商缓存、Service Worker 二次访问 LCP
监控 真实用户监控(RUM)采集三项核心指标 全量

七、加分项:怎么证明你真做过

面试官最想听到的不是名词,而是闭环。一个高分回答模板:

  1. 先量化:用 Lighthouse 或 RUM 拿到基线指标,指出瓶颈在 LCP 还是 INP;
  2. 再定位:用 Performance 面板找到长任务或强制同步布局的具体代码;
  3. 后优化:针对性改,一次只改一类;
  4. 最后验证与防劣化:对比优化前后数据,并把指标接入 CI 或灰度监控。

能说出”我们把 CLS 从 0.21 降到 0.06,方法是给所有图片和广告位补了尺寸占位”,比背十个名词都有说服力。

八、小结

渲染与性能这一块的面试,考察的不是记忆力,而是能否把现象、原理、手段、度量串成一条线。把流水线六阶段记住,把三个核心指标记住,再准备一个自己真实做过的优化案例,这一块基本就稳了。


参考:MDN · Web 性能web.dev 性能指南。指标阈值以官方最新定义为准。

标签

#前端面试题#浏览器#性能优化#面试

从 CPU 缓存行到伪共享:并发编程里最被低估的性能杀手

从 CPU 缓存行到伪共享:并发编程里最被低估的性能杀手
关键词伪共享、缓存行、False Sharing、MESI、并发编程、性能优化

有一段代码,单线程跑得飞快,一上多线程就慢得离谱,而且加的线程越多越慢。排查半天发现:CPU 没跑满、锁竞争也不严重、业务逻辑毫无问题。

元凶往往藏在你根本没看过的地方——CPU 缓存行与伪共享(False Sharing)。这是并发编程中最被低估、也最容易被误诊的性能杀手。

一、先建立缓存行的基本认知

CPU 访问内存的速度比访问缓存慢一到两个数量级。为了摊薄这个差距,CPU 不是按字节读内存,而是按”缓存行”(Cache Line,主流架构为 64 字节)为单位整块加载

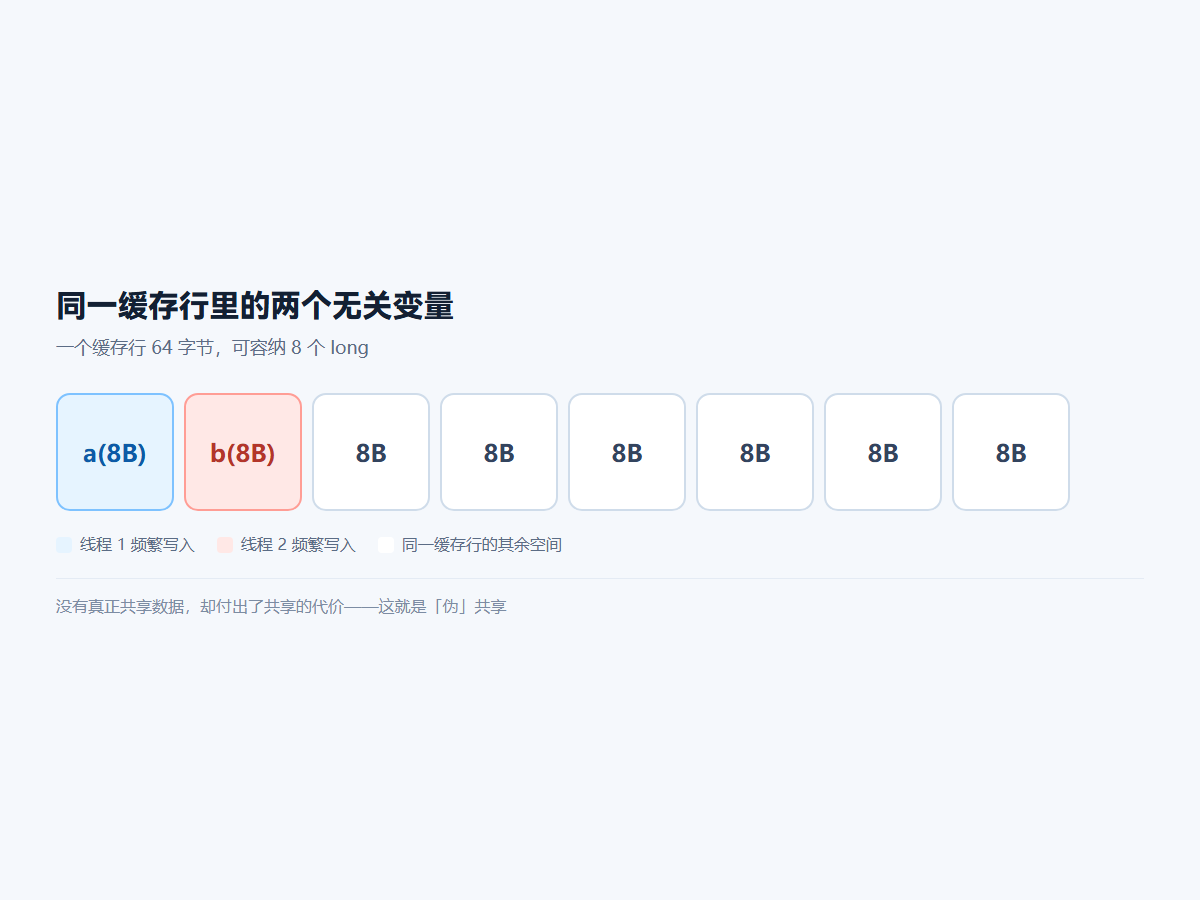
同一缓存行里的两个无关变量
伪共享示意:变量 a 与 b 同处一个 64 字节缓存行,两个核心反复互相使缓存失效

关键推论:即使你只改一个 8 字节的 long,CPU 也会把包含它的整个 64 字节缓存行加载进来。在多核环境下,这带来了缓存一致性协议的开销。

二、伪共享是怎么发生的

假设有两个变量 ab,它们在内存中恰好相邻,落在同一个缓存行里

class Counter {
  volatile long a;  // 线程 1 反复写
  volatile long b;  // 线程 2 反复写
}

从逻辑上看,两个线程写的是完全不同的变量,没有任何数据竞争。但从 CPU 的角度:

  1. 线程 1 改了 a,它所在的缓存行被标记为脏;
  2. 缓存一致性协议(MESI)会让其他核心上同一个缓存行的副本全部失效
  3. 线程 2 想写 b,发现缓存行失效,必须重新从内存加载;
  4. 线程 2 写完,又把线程 1 的副本搞失效……

结果就是:两个毫无关联的变量,因为住在同一间”房子”里,导致两个核心反复互相使绊子。 这就是伪共享——没有真正共享数据,却付出了共享的代价。

三、怎么判断自己踩了这个坑

三个特征同时出现时,高度怀疑伪共享:

  • 多线程性能不升反降,线程数越多越慢;
  • CPU 使用率很高,但有效吞吐很低(大量时间在缓存一致性上);
  • 用 perf 等工具观察时,能看到大量的缓存未命中与总线事务

Linux 下可以用 perf c2c 观察 cache line 的争用热点;Java 侧可用 JFR 的相关事件辅助定位。

四、三种解法

1. 填充(Padding):把变量隔开

最常见的做法是在变量前后填充无用字段,让它们各自独占一个缓存行:

// Java 8+ 可用 @Contended(需 JVM 参数启用)
@sun.misc.Contended
static final class PaddedCounter {
    volatile long value;
}

// 或手动填充(示意)
class PaddedLong {
    volatile long value;
    long p1, p2, p3, p4, p5, p6, p7; // 占位
}

2. 让每个线程写自己的对象

更彻底的方案是避免共享:让每个线程持有独立的计数器,读取时再汇总。这也是 LongAdder 相比 AtomicLong 在高争用下快得多的原因——它内部把计数分散到多个单元,降低争用。

3. 只读数据无需处理

伪共享只对频繁写入的场景有害。只读或极少写的数据放在同一个缓存行里反而能提升缓存命中率,不要盲目填充——填充会增加内存占用,过犹不及。

五、实践中的取舍

做法 适用 代价
手动/@Contended 填充 极热点的独立计数器 内存占用增加,可读性下降
分片计数(LongAdder 思路) 高争用计数场景 读取时需要汇总,非严格实时
线程本地存储 可聚合的中间状态 需要额外的合并逻辑
不做处理 写频率低、非热点路径

最重要的建议:先测量,再优化。 伪共享只在”高频写入 + 变量相邻”时才值得处理。凭感觉到处加填充,只会让代码变丑、内存变多,性能毫无变化。

六、面试怎么答

如果被问到”什么是伪共享”,一个完整的回答要包含四层:① 缓存行是 CPU 加载内存的最小单位(64 字节);② 多核间通过一致性协议保证缓存行同步;③ 相邻变量被不同线程写入时会产生无谓的失效风暴;④ 解法是填充隔离、分片计数或减少共享写入。

能补上一句”只读共享不是问题,盲目填充反而有害”,基本就是高分答案。

七、小结

伪共享是典型的”知道很简单,不知道就永远查不出来”的问题。它提醒我们一件事:并发性能的瓶颈,往往不在你写的逻辑里,而在硬件如何执行你的代码。

当多线程性能表现反常时,把怀疑范围从”锁”扩展到”内存布局”,你会少走很多弯路。


延伸阅读:MDN · SharedArrayBuffer(前端多线程共享内存同样受此影响)。硬件相关行为请以具体 CPU 架构手册为准。

标签

#计算机基础#并发编程#CPU缓存#性能优化

HTTP/3 与 QUIC:2026 年该默认开启了吗

HTTP/3 与 QUIC:2026 年该默认开启了吗
关键词HTTP/3、QUIC、队头阻塞、RFC 9000、CDN、弱网优化

HTTP/3 已经不是”新特性”了。到 2026 年,主流浏览器、CDN 与反向代理(nginx 主线已到 1.31)都已提供支持。真正的问题变成了:你的服务该不该默认开启它?开了之后要改什么?

本文讲清 QUIC 解决了什么、没解决什么,以及一份可执行的开启清单。

一、HTTP/3 解决的问题:队头阻塞

要理解 HTTP/3,必须先理解它前辈的痛点。

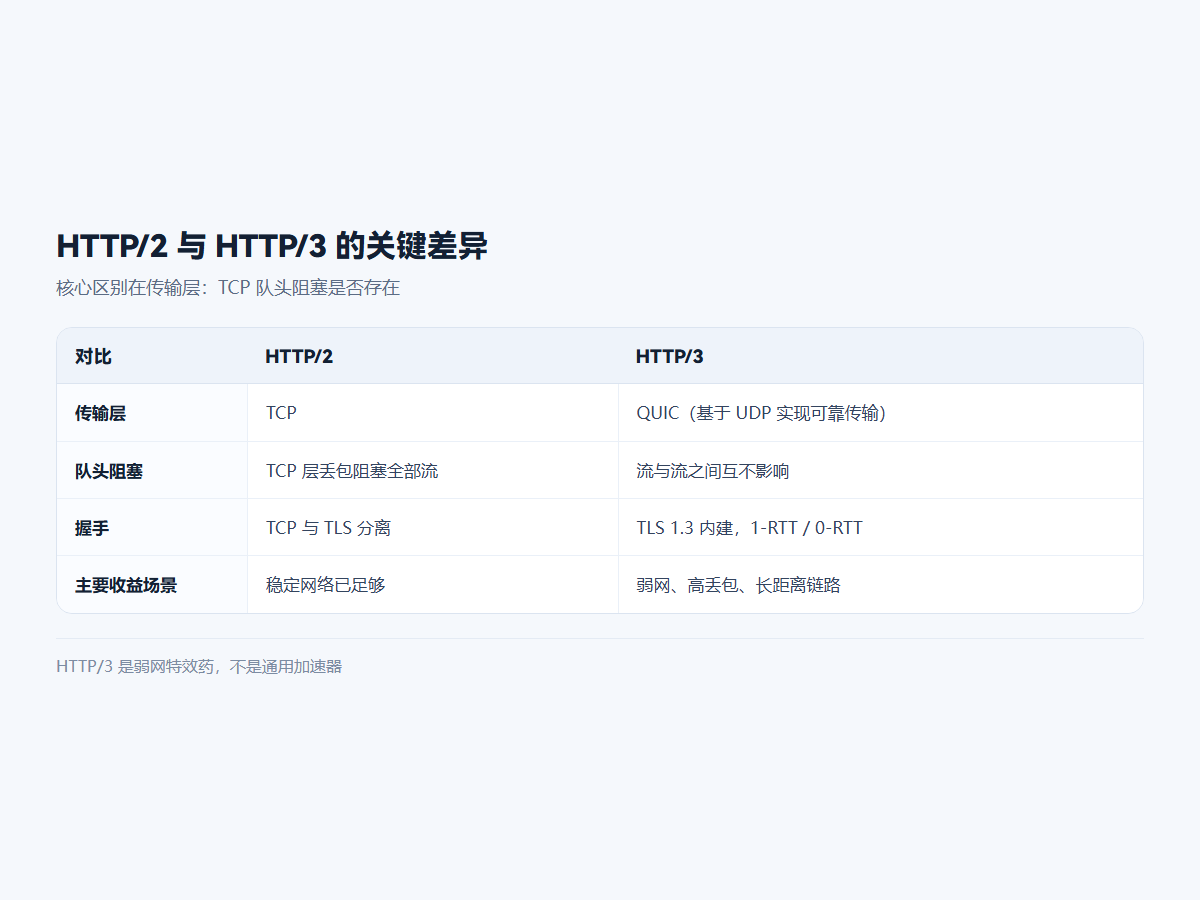
HTTP/2 与 HTTP/3 的关键差异
HTTP/2 与 HTTP/3 对比:QUIC 让流与流之间互不阻塞
  • HTTP/2 的多路复用解决了应用层队头阻塞——一个连接上可以并发多个流;但它运行在 TCP 之上,TCP 层的丢包重传会阻塞所有流。丢一个包,全部流一起等;
  • HTTP/3 把传输层换成 QUIC(基于 UDP 实现可靠传输),流与流之间互相独立。丢包只影响对应的那条流,其余流继续传输。

QUIC 由 IETF 标准化(RFC 9000 系列),同时把 TLS 1.3 内建进传输层握手,带来更少的握手往返(首次连接 1-RTT,会话复用可到 0-RTT)。

二、它没解决的问题:别抱错误期待

  1. 不解决带宽不足。 链路带宽是物理限制,换协议不会变快;
  2. 不解决服务端慢。 如果瓶颈在数据库或业务逻辑,HTTP/3 的收益等于零;
  3. 可能在低丢包网络里没有明显收益。 网络质量好时,HTTP/2 已经足够快;
  4. 0-RTT 有重放风险。 需要业务层配合做幂等设计,不能无脑开启。

一句话:HTTP/3 是弱网与高丢包场景的特效药,不是通用加速器。

三、什么场景收益最大

场景 预期收益
移动网络(4G/5G 切换、信号波动) 显著,抗丢包能力强
跨境、长距离链路 显著,减少握手往返
弱网地区的 C 端应用 显著,首包时间改善明显
机房内网、专线 几乎没有,反而增加复杂度
大文件下载 有限,瓶颈在带宽

四、开启清单:四步走

1. 确认全链路支持

HTTP/3 需要客户端、CDN/反向代理、服务端三方都支持。最常见的落地方式是:CDN 或边缘代理终结 HTTP/3,回源仍走 HTTP/1.1 或 HTTP/2——这样业务服务一行代码都不用改。

2. 开启 UDP 443

QUIC 跑在 UDP 之上,防火墙与安全组必须放行 UDP 443。这是开启失败最常见的原因——配置都对了,但包根本进不来。

3. 正确返回协商头

服务需要在响应里带上 Alt-Svc 头,告诉客户端”我支持 HTTP/3″:

Alt-Svc: h3=":443"; ma=86400

客户端首次仍用 HTTP/2 或 HTTP/1.1 连接,看到这个头后,下次连接才会尝试 QUIC。

4. 观测与灰度

  • 用浏览器开发者工具查看协议列(h3 表示已走 HTTP/3);
  • 服务端区分统计 HTTP/2 与 HTTP/3 的连接数、首包时间、错误率;
  • 先灰度一部分流量,确认无异常再全量。

五、三个工程上的坑

① 中间设备干扰。 部分老旧防火墙、负载均衡器会丢弃或限速 UDP 流量,导致连接反复回退到 HTTP/2,表现为”开了但效果不明显”。
② 监控盲区。 传统基于 TCP 的监控指标对 QUIC 无效,需要补充 UDP 层的连接成功率与回退率监控。
③ 回退路径必须验证。 客户端或网络不支持时必须能平滑回落到 HTTP/2,这条路径要专门测试,否则弱网用户会直接打不开。

六、小结

2026 年的务实建议:面向公网的 C 端服务,建议开启 HTTP/3,优先在 CDN/边缘层终结,成本低、收益明确;内网服务不必跟风,稳定压倒一切。

开启前想清楚一件事:你的用户是否在弱网环境?如果是,HTTP/3 值得投入;如果不是,先把服务端的响应时间优化好,收益更直接。


参考:RFC 9000 · QUIC: A UDP-Based Multiplexed and Secure TransportMDN · HTTP 文档nginx 官方文档。nginx 版本参考 endoflife.date,采集于 2026 年 9 月 1 日。

标签

#HTTP/3#QUIC#计算机网络#性能优化

Monorepo 工具链选型:pnpm 11 Workspace、Turborepo 2 与 Nx 23

Monorepo 工具链选型:pnpm 11 Workspace、Turborepo 2 与 Nx 23
关键词Monorepo、pnpm Workspace、Turborepo、Nx、任务编排、CI/CD

代码仓库该拆还是该合?2026 年的工程实践已经给出偏向性答案:中大型前端/全栈项目,Monorepo 是主流选择。而工具链之争,主要落在 pnpm Workspace、Turborepo、Nx 三者之间。

本文基于当前版本(pnpm 11.24.0、Turborepo 2.10.12、Nx 23.1.2),讲清它们的分工边界与组合方式。

一、先厘清:它们不是一个层面的东西

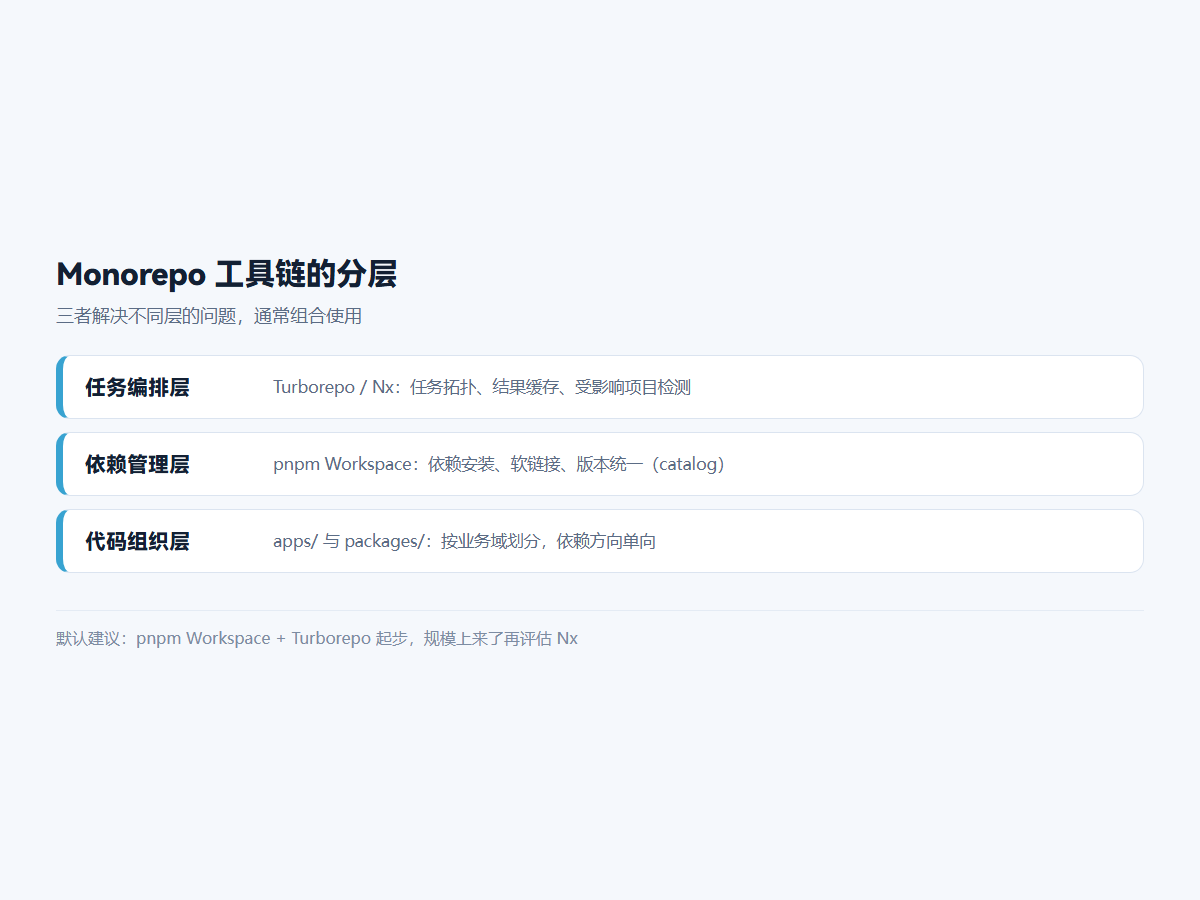
这是最常见的误解——很多人以为三者是互斥选项,实际上它们解决的是不同层的问题

Monorepo 工具链的分层
Monorepo 工具链分层:任务编排层、依赖管理层、代码组织层
  • pnpm Workspace:解决依赖安装与包之间的软链接。它让多个包共享同一份依赖、本地包之间互相引用;
  • Turborepo:解决任务编排与缓存。它负责决定”哪些任务要跑、能否复用上次结果、能否并行”;
  • Nx:解决工程治理。它包含任务编排、依赖图分析、代码生成、受影响项目检测,还带分布式缓存与 IDE 集成。

因此最常见的组合是 pnpm Workspace(管依赖)+ Turborepo 或 Nx(管任务)。真正的二选一发生在后两者之间。

二、三者定位对比

维度 pnpm Workspace Turborepo Nx
核心职责 依赖安装 / 包链接 任务编排 + 缓存 全链路工程治理
学习成本 中高
配置复杂度 极简(一个 yaml) 简洁(turbo.json) 较复杂(项目配置丰富)
受影响项目检测 需借助其他工具 支持 强项,粒度可到文件级
分布式/远程缓存 不涉及 支持 支持,生态更完整
适用规模 任意 中小到大型 中大型、多团队协作

三、pnpm Workspace:地基

# pnpm-workspace.yaml
packages:
  - 'apps/*'
  - 'packages/*'
  - '!**/dist/**'

pnpm 的硬链接 + 内容寻址存储让多包项目的安装速度与磁盘占用远优于传统方案。实践建议:

  • catalog: 统一管理常用依赖版本,避免各包版本漂移;
  • pnpm --filter 精准对某个包执行命令;
  • CI 里用 lockfile 冻结安装,开启 store 缓存提速。

四、Turborepo:够用就好的编排

// turbo.json(示意)
{
  "tasks": {
    "build": {
      "dependsOn": ["^build"],
      "outputs": ["dist/**"]
    },
    "test": { "dependsOn": ["build"], "outputs": [] },
    "lint": { "outputs": [] }
  }
}

核心概念只有两个:任务依赖拓扑(^build 表示先构建上游依赖包)与产物缓存。它的优势是配置简单、心智负担小,团队半天就能上手。

五、Nx:当规模上来了再考虑

Nx 的价值在大仓治理:依赖图可视化、受影响项目精确到文件、代码生成器统一脚手架、分布式任务执行。当你的仓库有几十个包、多个团队并行开发、CI 时间成为瓶颈时,Nx 的能力是对症的。

代价是配置与概念更多,团队需要投入学习成本。小团队硬上 Nx,往往会觉得”复杂但没用上”。

六、选型决策

3 人以内的项目、包数量 < 10:pnpm Workspace 即可,脚本够用别上编排工具。
中型项目、追求快速接入:pnpm + Turborepo,性价比最高。
大型多团队仓、CI 时长已成瓶颈:pnpm + Nx,用受影响检测与分布式缓存换时间。
已有 CI 编排能力:只上 pnpm Workspace,用现有流水线补任务缓存。

七、五个落地要点

  1. 边界先划清。 按业务域而非技术层分包(packages/order 而不是 packages/utils 一锅炖);
  2. 依赖方向单向。 上层可以依赖下层,禁止反向依赖与循环依赖,用 lint 规则固化;
  3. 缓存要正确声明产物。 outputs 写错会导致命中错误的缓存,产生诡异的构建结果;
  4. CI 只跑受影响的项目。 这是 Monorepo 提速的最大杠杆;
  5. 版本发布统一策略。 用 changeset 之类的方案管理版本号与 changelog,避免手工出错。

八、小结

Monorepo 工具链在 2026 年已经成熟,选择不再是”谁更强”,而是”你的规模和团队能吃下多少复杂度“。

默认建议:pnpm Workspace + Turborepo 起步,规模上来了再评估 Nx。工具是手段,仓库结构清晰、依赖方向可控,才是 Monorepo 成功的前提。


版本数据来源:npm registry(pnpm、turbo、nx 包页面);采集于 2026 年 9 月 1 日。参考:pnpm Workspace 文档Turborepo 文档Nx 官方文档

标签

#Monorepo#pnpm#前端工程化#CI/CD

可观测性落地实战:OpenTelemetry + Prometheus + Grafana 一条龙

可观测性落地实战:OpenTelemetry + Prometheus + Grafana 一条龙
关键词可观测性、OpenTelemetry、Prometheus、Grafana、链路追踪、SLO、MTTR

“系统又慢了”——如果这句话之后需要半小时才能定位到原因,说明你的可观测性还停留在”有日志”的阶段。2026 年,可观测性的标准答案已经收敛为一条清晰的链路:OpenTelemetry 采集 → Prometheus 存储指标 → Grafana 展示与告警,配合链路追踪定位跨服务问题。

本文给出一条可照抄的落地路径,以及四个最容易做错的地方。

一、先分清三根支柱

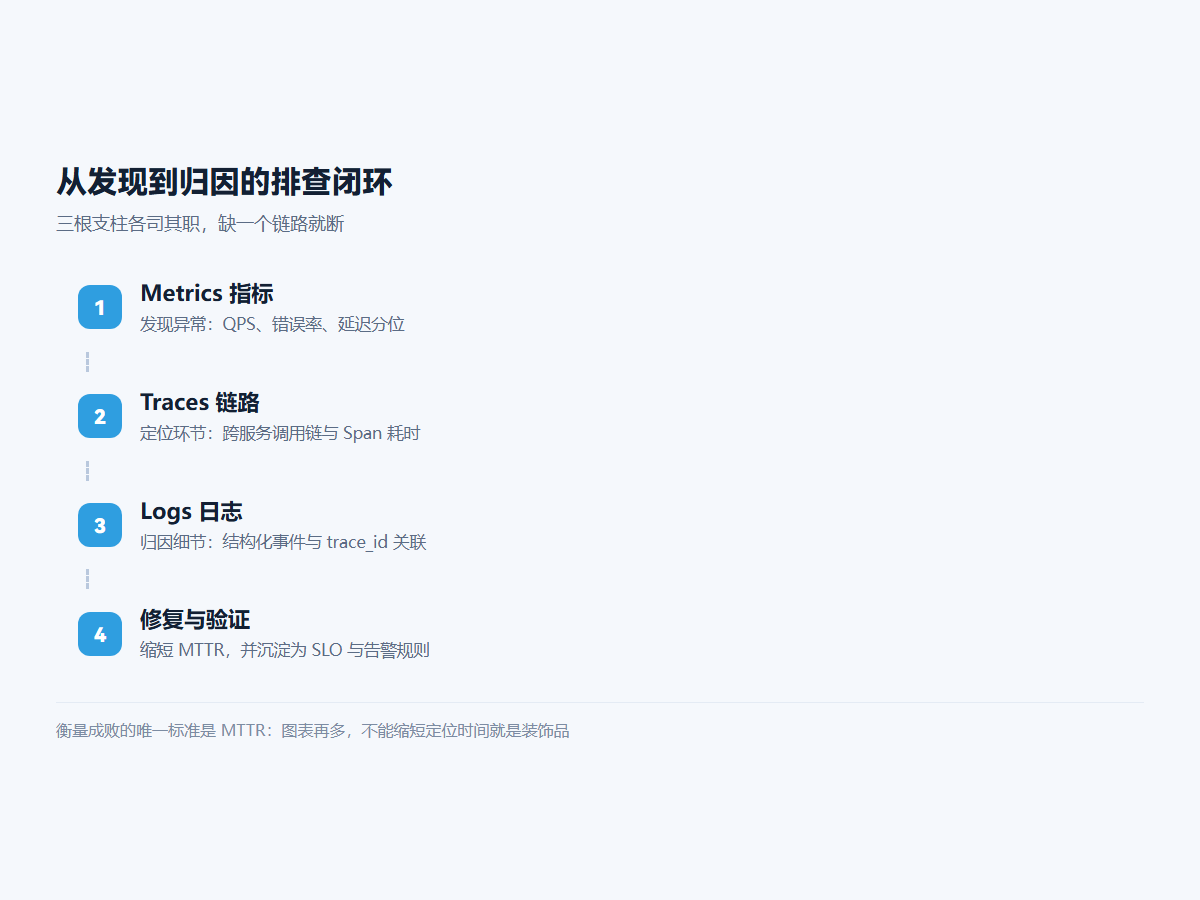
很多团队把”监控”和”可观测性”混为一谈,结果堆了一堆图表却依然查不出问题。区别在于问的问题不同:

从发现到归因的排查闭环
可观测性三支柱:指标发现、链路定位、日志归因
支柱 回答什么问题 典型数据
Metrics 指标 有没有问题?有多严重? QPS、延迟分位、错误率、饱和度
Logs 日志 具体发生了什么? 结构化事件、错误堆栈
Traces 链路 问题出在哪个环节? 跨服务调用链、Span 耗时

指标用于发现,链路用于定位,日志用于归因。 三者缺一个,排查链路就会断。

二、标准链路怎么搭

1. 采集:OpenTelemetry 统一 SDK

OpenTelemetry(简称 OTel)已成为事实标准:一套 SDK + 协议(OTLP)同时输出指标、日志、链路,避免被单一厂商绑定。

# OpenTelemetry Collector 最小配置示意
receivers:
  otlp:
    protocols:
      grpc:
        endpoint: 0.0.0.0:4317

processors:
  batch: {}
  memory_limiter:
    check_interval: 1s
    limit_percentage: 80

exporters:
  prometheus:
    endpoint: 0.0.0.0:8889

service:
  pipelines:
    metrics:
      receivers: [otlp]
      processors: [memory_limiter, batch]
      exporters: [prometheus]

用 Collector 做中间层的价值:应用只对接 OTLP,后端存储可随时替换,不用改一行业务代码。

2. 存储与查询:Prometheus

Prometheus 用拉取模型 + 时序数据库 + PromQL,适合存指标。注意它的定位:它是指标系统,不是日志系统,别往 label 里塞高基数维度(如用户 ID、订单号),否则会把存储打爆。

3. 展示与告警:Grafana

负责仪表盘、告警规则与通知路由。告警设计的核心原则是只告警可行动的异常——凡是收到告警却不需要做任何事的规则,都该删掉。

三、四个最容易做错的地方

① 高基数标签把存储打爆

user_idtrace_id、URL 里的动态参数作为 label,会让时间序列数量指数级膨胀。label 只放低基数维度(服务名、方法、状态码、机房),高基数信息放链路或日志里。

② 只看平均延迟

平均延迟会掩盖长尾问题。P50 正常、P99 爆炸是最常见的故障形态。一律用分位数(P95/P99)定义 SLO,告警也基于分位数。

③ 链路采样率拍脑袋

全量采样成本高、头部采样会漏掉错误请求。实践建议:低比例头部采样 + 错误与慢请求全采(尾部采样),既控成本又保留关键现场。

④ 日志没有结构化

纯文本日志无法聚合分析。统一输出 JSON 结构,并在日志里带上 trace_id,实现从指标告警 → 链路 → 日志的一键跳转,这才是排查提速的关键。

四、落地节奏建议

  1. 第一周:指标先行。 接入 OTel SDK,先覆盖 RED 三指标(Rate 请求量、Errors 错误率、Duration 耗时),让核心服务有图可看;
  2. 第二周:补链路。 打通跨服务调用链,确认 trace 能贯穿网关 → 业务 → 数据库;
  3. 第三周:日志关联。 日志注入 trace_id,实现三支柱联动;
  4. 第四周:定 SLO 与告警。 基于真实数据设定阈值,清理无效告警;
  5. 持续:做一次故障演练。 故意注入延迟或错误,检验整条链路能否在 5 分钟内定位。

衡量可观测性建设是否成功的唯一标准是 MTTR(平均修复时间)。图表再多,如果不能缩短定位时间,就只是装饰品。

五、与云原生环境的配合

在 Kubernetes 环境(当前主线版本已到 1.37)中,建议把 OTel Collector 以 DaemonSet + Gateway 两层部署:节点级 Agent 负责采集,中心 Gateway 负责统一处理与导出。这样既降低应用侧负担,又便于集中治理采样与脱敏策略。

六、小结

可观测性不是买一套平台,而是建立”发现—定位—归因”的闭环能力。技术选型上,OpenTelemetry + Prometheus + Grafana 已是稳妥的默认组合;工程上,控制基数、关注分位、关联三支柱,才是真正决定成败的细节。


参考:OpenTelemetry 官方文档Prometheus 官方文档Grafana 官方文档。Kubernetes 版本信息参考 endoflife.date,采集于 2026 年 9 月 1 日。

标签

#可观测性#OpenTelemetry#Prometheus#DevOps

ArkUI-X 与一次开发多端部署:鸿蒙跨端能做到什么程度

ArkUI-X 与一次开发多端部署:鸿蒙跨端能做到什么程度
关键词ArkUI-X、一次开发多端部署、鸿蒙跨端、响应式布局、能力降级

“一次开发,多端部署”是鸿蒙最有吸引力、也最容易被误解的一张牌。它到底能做到什么程度?ArkUI-X 在其中扮演什么角色?本文讲清能力边界与落地姿势。

一、先分清两件事:多端部署 vs 跨平台

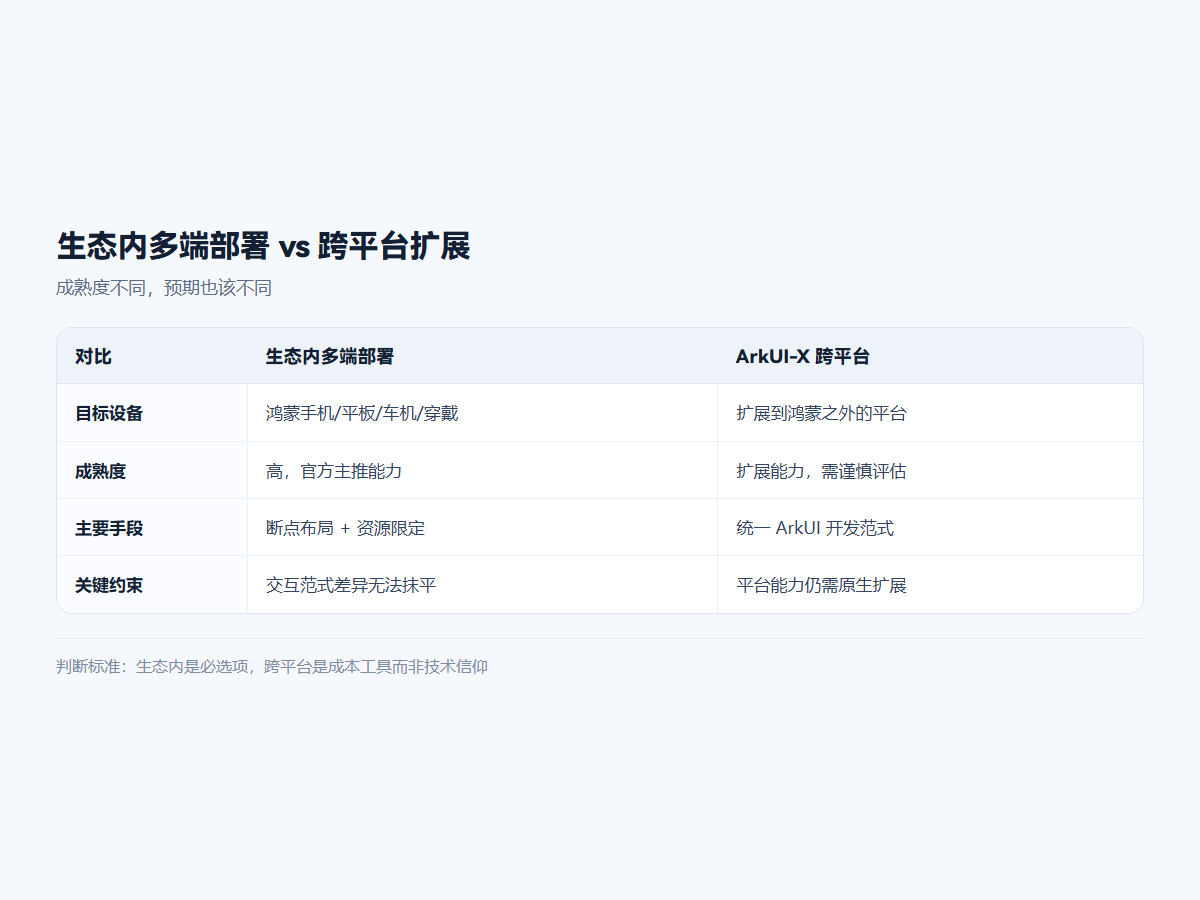
很多讨论把两个概念混为一谈,导致预期错位:

生态内多端部署 vs 跨平台扩展
生态内多端部署与 ArkUI-X 跨平台扩展的能力边界对比
  • 鸿蒙生态内的一次开发多端部署:指同一份 ArkTS/ArkUI 代码,部署到鸿蒙手机、平板、车机、智慧屏、穿戴设备。这是鸿蒙的原生能力,靠响应式布局与资源限定能力实现;
  • ArkUI-X 跨平台扩展:把 ArkUI 的声明式开发范式延伸到鸿蒙之外的平台(如 Android、iOS),目标是让一套 ArkTS 代码跑到更多系统上。

前者成熟度高、风险低;后者是扩展能力,落地时需要更谨慎的评估。

二、生态内多端部署:靠什么实现

核心是三件事:响应式布局、资源限定、能力可选

1. 响应式布局:断点 + 自适应组件

把界面按窗口宽度划分为不同断点(如手机、折叠屏展开、平板、宽屏),同一份 UI 描述在不同断点下走不同排布。DevEco Studio 已支持同时预览多个档位断点的 UI 效果,便于快速验证。

// 按断点切换布局结构(示意)
GridRow({ breakpoints: { value: ['320vp', '600vp', '840vp'] } }) {
  GridCol({ span: { sm: 12, md: 6, lg: 4 } }) {
    ItemCard()
  }
}

2. 资源限定:同一语义,不同形态

通过资源限定词(屏幕密度、设备类型、语言、横竖屏等)为不同设备提供差异化资源,代码里只引用资源名,系统在运行时自动匹配。

3. 能力可选:没有的能力要能优雅降级

这是工程上最容易翻车的地方。手表没有摄像头、车机没有触控键盘、智慧屏没有定位——代码里必须先判断能力是否存在,再调用,否则在低配设备上直接崩溃。

三、必须接受的三个现实约束

  1. 交互范式差异无法靠布局抹平。 手机是触控、车机是语音+大按钮、手表是轻交互。布局能自适应,但交互流程需要分设备设计,指望一套 UI 通吃所有形态是不现实的;
  2. 性能预算差异巨大。 穿戴设备的算力与内存远低于手机,同一份代码需要做性能降级策略(降低动画复杂度、减少列表项、压缩图片);
  3. 测试矩阵会膨胀。 支持的设备形态越多,回归测试成本越高。需要建立”典型设备档位”清单,而不是穷举所有机型。

四、ArkUI-X:跨到鸿蒙之外的正确预期

ArkUI-X 的思路是:把 ArkUI 的声明式开发范式带到其他平台,让已有 ArkTS 资产可以延伸复用。它的价值在两种情况下最明显:

  • 你已有成熟鸿蒙应用,希望低成本覆盖 Android/iOS,且应用偏标准控件、对平台原生观感要求不高;
  • 团队以 ArkTS 为主力语言,希望统一技术栈,降低多端人力成本。

但它不是”写一次到处完美运行”的银弹:平台特有能力仍需原生扩展,UI 细节与性能表现需要逐平台调优。选型时应当按”能省下多少工作量”来算账,而不是按”能不能跨”来决策。

五、落地建议:一套可执行的顺序

  1. 先做单端精品,再谈多端。 在主力设备上把体验打磨好,比同时铺五个形态但都不精更明智;
  2. 设计阶段就引入断点。 后期补响应式布局的成本远高于前期规划;
  3. 抽象能力层。 把所有”设备可能不支持”的能力做成统一接口,内部做能力探测与降级;
  4. 建立设备档位清单。 挑 3–5 个典型档位作为回归基线,覆盖即可;
  5. 跨平台用 ArkUI-X 时先做技术验证。 用一个中等复杂度的页面验证渲染一致性、性能与原生扩展成本,再决定是否全量。

一句话判断标准:如果你的应用在鸿蒙生态内,多端部署是必选项;如果要跨到生态外,把 ArkUI-X 当作成本工具而非技术信仰。

六、小结

鸿蒙的一次开发多端部署,在国内多设备场景下有真实价值,尤其适合手机 + 平板 + 车机 + 智慧屏的连贯体验。但它的收益上限取决于产品是否真的需要多设备协同,而不是技术本身能做到什么。

ArkUI-X 则是一条向外延伸的路,适合已有鸿蒙资产、希望复用技术栈的团队。评估它时请带上计算器,而不是带上期待。


参考:HarmonyOS 官方开发指南HarmonyOS 版本概览。能力边界以华为官方文档为准,采集于 2026 年 9 月 1 日。

标签

#鸿蒙#ArkUI#跨端开发#ArkUI-X

HarmonyOS NEXT 与 ArkTS 开发现状:纯血鸿蒙的机遇与门槛

HarmonyOS NEXT 与 ArkTS 开发现状:纯血鸿蒙的机遇与门槛
关键词HarmonyOS NEXT、ArkTS、ArkUI、DevEco Studio、鸿蒙开发、端侧 AI

2026 年是鸿蒙生态的分水岭:HarmonyOS NEXT(纯血鸿蒙)规模化商用,彻底移除 AOSP 兼容层,”把安卓应用简单移植过来”的红利期结束,原生开发成为唯一主线。

对开发者来说,这既是门槛也是窗口。本文梳理当前鸿蒙开发的技术底座、真实门槛与可切入的机会点。

一、版本坐标(2026 年 9 月)

组成部分 当前状态
系统版本 HarmonyOS 6.1.1(24),API 24
开发工具 DevEco Studio 26.0.0(支持开发 API 26.0.0 工程)
版本标识 API 版本号启用语义化版本格式(如 26.0.0)
开发语言 ArkTS(TypeScript 超集,静态编译型)
UI 框架 ArkUI 声明式开发范式
应用模型 Stage 模型(UIAbility / ExtensionAbility)

注意一个容易踩的坑:API 版本号与系统版本号是两套标识,开发时必须确认 DevEco Studio、SDK、目标设备三者的配套关系,否则会出现”能编译但真机跑不起来”的情况。

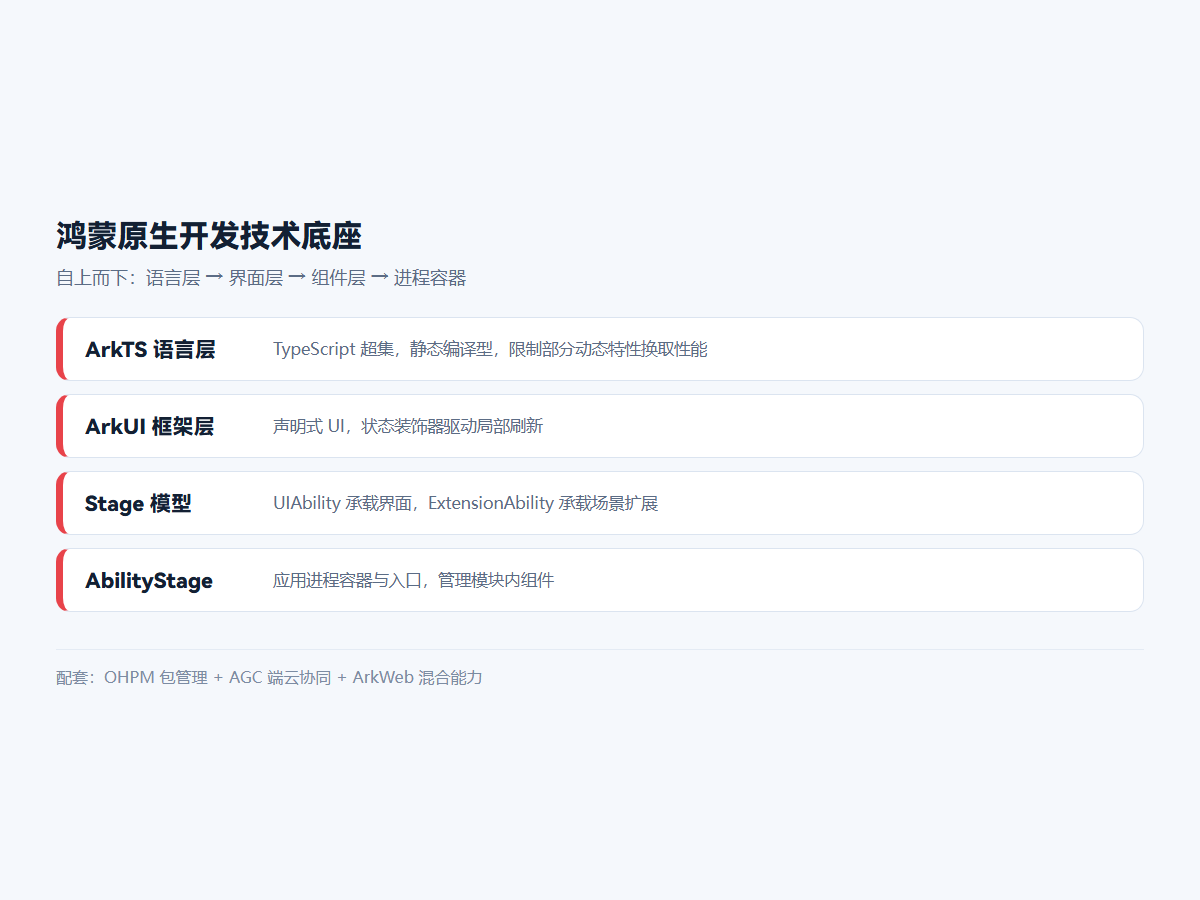
二、技术底座:五件套

鸿蒙原生开发技术底座
鸿蒙原生开发技术底座:ArkTS、ArkUI、Stage 模型与 AbilityStage

1. ArkTS:静态化的 TypeScript 超集

ArkTS 在 TS 基础上强化了静态类型约束,通过方舟编译器编译为字节码运行。熟悉 TypeScript 的前端开发者上手较快,但要注意:它限制了部分动态特性(如运行时动态增删属性、any 的滥用),换取的是编译期检查与运行时性能。

2. ArkUI:声明式 UI

用装饰器与链式调用描述 UI,状态变化自动驱动刷新。思维模型接近 Flutter/SwiftUI,前端同学从 React/Vue 迁移需要适应”状态装饰器”这套体系(@State@Prop@Link@Provide/@Consume 等)。

@Entry
@Component
struct Index {
  @State count: number = 0

  build() {
    Column() {
      Text(`点击了 ${this.count} 次`)
        .fontSize(24)
      Button('点我')
        .onClick(() => { this.count++ })
    }
    .width('100%')
    .height('100%')
  }
}

3. Stage 模型

这是当前主流的应用模型,以 AbilityStage 为进程入口,用 UIAbility 承载界面、ExtensionAbility 承载后台能力。理解 Stage 模型是理解鸿蒙应用生命周期的关键,也是面试高频考点。

4. OHPM 与 AGC

OHPM 是鸿蒙的包管理器(用法接近 npm),AGC(AppGallery Connect)提供云数据库、云函数、认证等端云协同能力。

5. ArkWeb

系统 Web 组件,其内核版本持续升级(Chromium 内核已迭代到 144),为”原生 + Web 混合”提供了过渡路径。

三、真实的门槛在哪

  1. 生态位尚未填满,但也意味着轮子少。 很多在安卓/iOS 上随手拈来的三方库,鸿蒙上需要自己实现或找替代;
  2. 分布式与元服务是新心智。 跨设备流转、元服务(免安装)这些能力是鸿蒙的差异化优势,但需要重新理解产品形态,不是简单移植就能用上;
  3. 调试与性能工具有学习成本。 DevEco Studio 提供了 Hot Reload、内存分析模板等能力,但用好它们需要时间;
  4. 版本配套关系要盯紧。 API 语义化改版后,工程配置与目标设备的匹配比以往更需要注意。

四、机会在哪

  • 端侧 AI 与智能体:系统内置离线端侧大模型能力,开发者可直接调用本地 AI 接口,数据不出设备、天然满足隐私合规,这是相对安卓/iOS 的差异化优势;
  • 中长尾应用空白:头部国民应用已完成适配,但垂直行业工具、企业内部应用、硬件配套应用仍有大量空缺;
  • 多端协同场景:手机、平板、车机、智慧屏、穿戴设备构成的设备矩阵,配合一次开发多端部署能力,适合做跨设备连贯体验的产品;
  • 政策与激励:面向原生应用、AI 智能体等方向有专项扶持计划,创业团队可关注官方开发者激励。

五、给不同背景开发者的入局建议

前端/TS 背景:从 ArkTS + ArkUI 切入最顺,先做一个完整的元服务练手;
Android 背景:重点补齐声明式 UI 与 Stage 模型,把既有架构经验迁移过来;
完全新手:跟着官方文档做一个完整应用,重点理解”状态驱动 UI”和”Ability 生命周期”两块。

六、小结

鸿蒙已经从”要不要关注”变成”什么时候入局”。技术底座(ArkTS + ArkUI + Stage 模型 + DevEco Studio)已经成型,纯血鸿蒙的商用化让原生能力成为唯一通路

对开发者的现实建议:不要为了追热点而转,要为了具体的场景和产品而转。 找到那个鸿蒙能做得比安卓/iOS 更好的点,投入才划算。


参考:华为开发者联盟 · HarmonyOS 版本概览DevEco Studio 官方站点。版本信息以华为官方文档为准,采集于 2026 年 9 月 1 日。

标签

#鸿蒙#ArkTS#HarmonyOS#移动开发