端侧 AI 在鸿蒙生态里是个被反复提及但边界模糊的词。本文把鸿蒙的 AI 能力拆成三层,讲清每层能做什么、不能做什么,给出三条可落地的接入路径,并列出四个必须提前想清楚的约束:机型覆盖、端云思维差异、模型更新与合规。
关键词鸿蒙端侧 AI、HarmonyOS AI、端云协同、ArkTS、AI 接入
“端侧 AI”在鸿蒙生态里是个被反复提及、但边界模糊的词。厂商演示里它能做很多事,落到具体项目上,开发者真正想知道的是:我能在 App 里用上哪部分?要用哪些能力?代价是什么?
本文把鸿蒙的 AI 能力拆成三层,讲清每层能做什么、不能做什么,并给出三条可落地的接入路径。
一、版本坐标
先对齐版本号,鸿蒙的版本体系比想象中更容易搞混。根据华为开发者联盟官方的开发套件版本总览(2026 年 8 月 29 日更新):
- 26.0.0 —— 配套 DevEco Studio 26.0.0 Release,2026 年 8 月 28 日发布,官方标注为新开发应用推荐使用、已开发应用推荐升级;
- 6.1.1(24) —— DevEco Studio 6.1.1 Release,2026 年 5 月 26 日;
- 6.1.0(23) —— 2026 年 4 月 20 日;
- 6.0.0(20) —— 2025 年 9 月 25 日,官方同样标注为推荐版本。
格式上括号里的是 API 版本,前面是 HarmonyOS 版本。选型时的经验法则:以官方标注”推荐使用”的版本作为新项目的基线,不要为了尝鲜特性而把生产项目压在某个中间版本上。
二、鸿蒙的 AI 能力分三层,别混为一谈
这是理解全局的关键。很多讨论把三层混在一起说,导致期待和实际对不上。
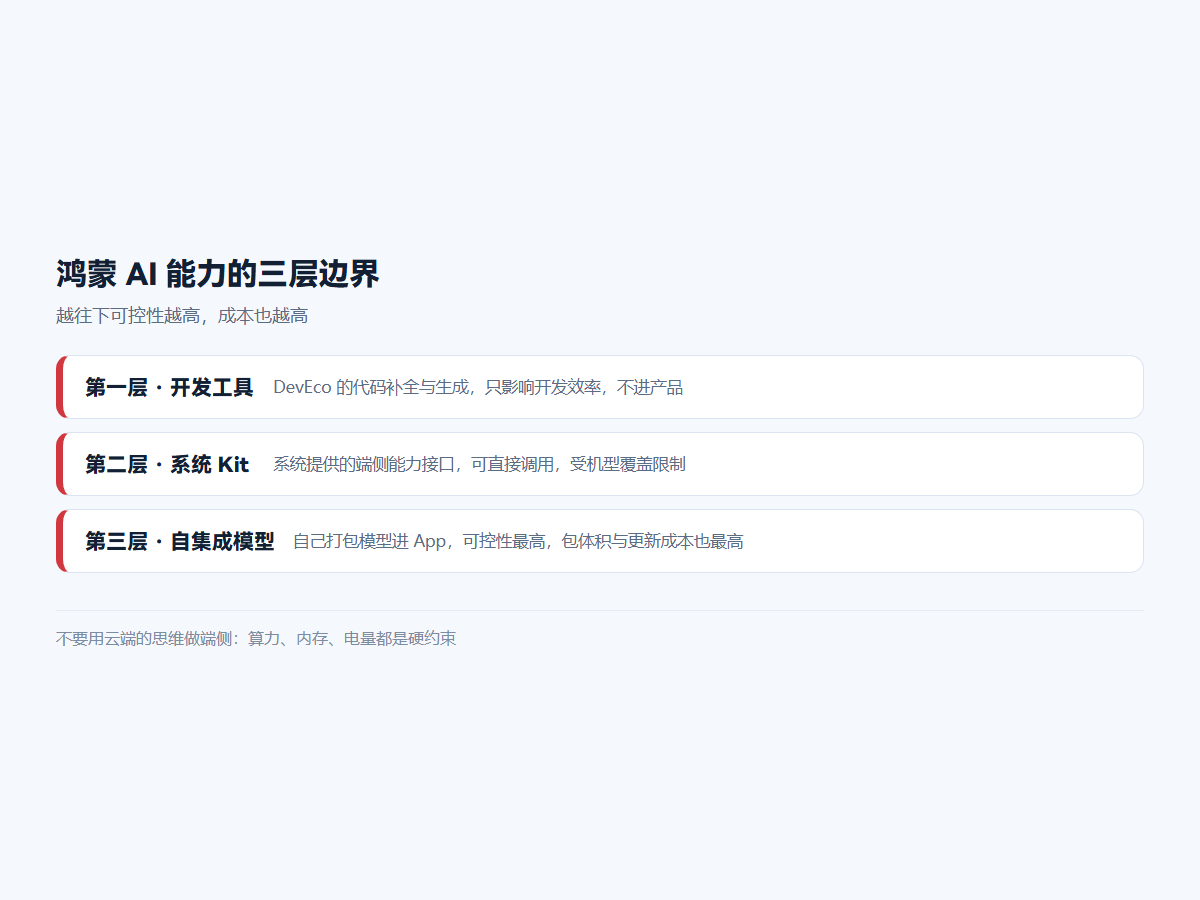
第一层:开发工具层的 AI
这一层最成熟、也最容易被忽略——它提升的是开发者的效率,不是应用的能力。
DevEco Studio 近几个版本在这块投入很大:自定义智能体(Agent)配置与调用、通过自然语言描述测试步骤自动在设备上执行 UI 操作并验证结果的 UI Verification(26.0.0 Beta 起)、以及动态效果分析等。IDE 内还支持切换不同模型来驱动代码生成与智能问答。
实际价值:把重复性的 UI 回归测试和样板代码生成交给工具。这一层对任何鸿蒙项目都适用,且没有兼容性负担——它不改变你的产物。
第二层:系统 Kit 能力
这是”系统已经做好、应用直接调用”的部分,比如语音、视觉、文本理解相关的系统级 Kit。好处是无需自带模型、包体积不涨、功耗由系统统一优化;限制是能力边界由系统定义,你只能用它提供的那些。
接入前要做的功课是核对能力清单与覆盖机型——系统能力的可用性和设备硬件、系统版本强相关,必须在真机上验证,不能只看文档。
第三层:应用自集成模型
自由度最高、成本也最高的一层:自己把模型打进应用,在端侧跑推理。适合有定制需求、或不能把数据送出设备的场景。
这一层要自己解决三件事:模型体积与包体积的平衡、推理性能与功耗、以及模型更新机制。这三个问题都不是”接个 SDK”能解决的,需要实际的工程投入。
三、三条可落地的接入路径
按投入从低到高排列,建议依次评估,能用低成本方案满足就不要上高成本方案。
路径一:只用来提效,不进产品
先用 DevEco Studio 的智能体与自动化验证能力,把开发流程里的重复劳动砍掉:样板代码生成、UI 自动化回归、代码解读。
适合:所有团队,尤其是刚切到鸿蒙、还在熟悉 ArkTS 的团队。零风险,投入产出比最高。
路径二:调用系统 Kit 做能力增强
在应用里接入系统提供的 AI 能力,做诸如智能识别、语音交互、文本处理这类功能。关键点是把降级路径设计好:能力不可用时(老机型、系统版本低)必须有非 AI 的兜底流程,否则会变成大面积功能不可用。
适合:希望”有 AI 功能”但不愿承担模型成本的大多数业务应用。
import { brainInterface } from "@kit.NaturalLanguageKit";

// 系统能力调用的标准形态:先探测能力,再使用,最后留兜底
async function summarize(text: string): Promise<string> {
  if (!brainInterface.canIUse()) {
    return ruleBasedSummary(text);   // 老机型/低版本:非 AI 兜底
  }
  const session = await brainInterface.createSession();
  try {
    return await session.processText(text, { task: "summarize" });
  } finally {
    session.release();               // 会话及时释放,避免占用推理资源
  }
}
路径三:自集成端侧模型
只有在这几种情况才该走这条路:数据不能出设备(隐私或合规要求)、需要离线可用、或系统 Kit 覆盖不了你的定制需求。
工程上必须提前规划:
- 模型量化与裁剪:原始模型直接塞进 App 通常不可接受,量化后的精度损失要在业务上可容忍;
- 按需下载:把模型放在首次使用时下载,而不是打进安装包;
- 推理放在非主线程:主线程跑推理会直接卡 UI,这是新手最常犯的错;
- 功耗与发热:持续的端侧推理是耗电大户,要有明确的触发时机和频次控制。
四、四个必须提前想清楚的约束
1. 机型覆盖是硬约束
端侧 AI 能力(尤其是依赖 NPU 加速的部分)与设备硬件强绑定。旗舰机型能跑的能力,中低端机型可能直接不可用或慢到无法接受。做功能设计时必须先确认目标用户群的设备分布。
2. 不要用云端的思维做端侧
从云端 API 切到端侧推理,最大的思维转变是延迟模型完全不同:云端是”网络往返 + 排队”,端侧是”稳定的本地计算但受算力限制”。很多在云端合理的交互设计(比如逐字流式输出),在端侧可能因为首字延迟过高而体验崩坏。
3. 模型更新比想象中麻烦
云端模型改一版,所有用户立刻生效;端侧模型改一版,要面对版本碎片化——总有一部分用户停留在旧模型上。设计时必须让后端能感知客户端的模型版本,并做兼容处理。
4. 合规与隐私声明
端侧处理是隐私优势,但不等于没有合规义务。数据如何在设备本地处理、是否上传、模型本身是否涉及第三方授权,这些都要在隐私政策和上架材料中说清楚。
五、小结
鸿蒙的 AI 能力不是单一功能,而是从开发工具到系统能力再到自集成模型的三层结构。绝大多数项目应该止步于前两层——用 IDE 的 AI 提效、用系统 Kit 做功能增强——因为第三层的工程成本是数量级上的跃升。
真正需要自集成模型的,只有那些数据不能出设备、或必须离线可用的场景。把边界划清楚,能省下大量不必要的投入。
标签
#鸿蒙#端侧 AI#HarmonyOS#AI 应用