理解 B+Tree 与 LSM-Tree 的根本分歧,很多数据库的奇怪行为就都能解释了:为什么 LSM 系的库写入快但读延迟抖动,为什么 B+Tree 系的表在大量随机写入后会膨胀。本文从原地更新与追加写入讲起,给出选型建议并澄清两个常见误解。
关键词B+Tree、LSM-Tree、存储引擎、写放大、读放大、Compaction
为什么 MySQL 用 B+Tree,而很多分布式 KV 存储用 LSM-Tree?答案不是”哪个更先进”,而是它们对磁盘的写入方式根本不同,进而决定了各自适合什么负载。
理解这个差异,很多数据库的”奇怪行为”就都能解释了:为什么 LSM 系的库写入快但读延迟抖动,为什么 B+Tree 系的表在大量随机写入后会变慢。
一、根本分歧:原地更新 vs 追加写入
这是两条路线的分水岭。
B+Tree:原地更新
B+Tree 是一棵多路平衡搜索树,数据主要存在叶子节点,叶子之间用链表串起来。它的更新方式是找到那条记录在磁盘上的位置,直接改掉。
这个模型很符合直觉,也带来几个直接优势:读路径短且稳定——从根到叶子最多三四层,且因为有缓存,实际 IO 次数更少;范围查询极快——叶子节点本身有序且相连,扫一段区间就是顺序读。
代价在写入。随机主键写入意味着每次修改都可能落在磁盘的不同位置,产生随机 IO。更麻烦的是页分裂:当一个数据页写满,要分裂成两个页并调整父节点,这是相当昂贵的操作。
LSM-Tree:追加写入
LSM-Tree 的思路完全不同:所有写入都是追加。新数据先写 WAL(保证持久性),再进内存里的 MemTable;MemTable 满了就整体刷成一个不可变的 SSTable 文件落到磁盘。磁盘上的文件从不原地修改。
这个设计把随机写变成了顺序写——对机械盘是数量级的性能差异,对 SSD 也显著减少写放大。写入吞吐因此远高于 B+Tree。
代价被转移到了三个地方:读放大、空间放大、写放大(由 compaction 引起)。
二、LSM-Tree 的三个”放大”
这是理解 LSM 行为特征的关键,也是面试和线上调优的高频考点。
1. 读放大
一条记录可能存在多个 SSTable 文件里(每次更新都产生新版本)。查询时要从最新的 MemTable 开始,逐层往老的文件找,直到找到为止。层数越多,读一次可能要碰的文件数就越多。
两个标准缓解手段:Bloom Filter(快速判断”这个文件肯定没有这个 key”,直接跳过)和块缓存。这两个组件做得好不好,直接决定了一个 LSM 引擎的实际读性能。以 RocksDB 为例,这两个旋钮通常是调优的第一站:
// RocksDB:读放大治理的两个关键配置
options.optimize_filters_for_hits = true;  // 热点数据优先命中 Bloom Filter
options.bloom_locality = 1;                // 提高 filter 的缓存局部性

// BlockBasedTable 层面:缓存命中决定点查延迟
BlockBasedTableOptions table;
table.block_cache = NewLRUCache(4ULL * 1024 * 1024 * 1024); // 4GB 块缓存
table.filter_policy.reset(NewBloomFilterPolicy(10));        // 10 位/键
options.table_factory.reset(NewBlockBasedTableFactory(table));
2. 空间放大
同一条记录的多个版本、以及被删除记录留下的墓碑标记,都要等到 compaction(后台合并)时才被清理。这意味着实际占用的磁盘空间可以远大于有效数据量。
规划容量时必须把这个系数算进去。写多读少、且更新频繁的业务,空间放大可能非常可观。
3. 写放大
compaction 要把多个 SSTable 读出来、合并排序、再写回去。同一条数据可能被反复读写多轮——这就是写放大:业务写了一份,磁盘上实际写了好几份。
这也是 LSM 系数据库延迟抖动的根源:compaction 是后台跑的,但它抢占 IO 和 CPU 资源。表现就是平时响应很快,每隔一段时间突然出现一批慢请求。对 SSD 来说,写放大还直接影响盘的使用寿命。
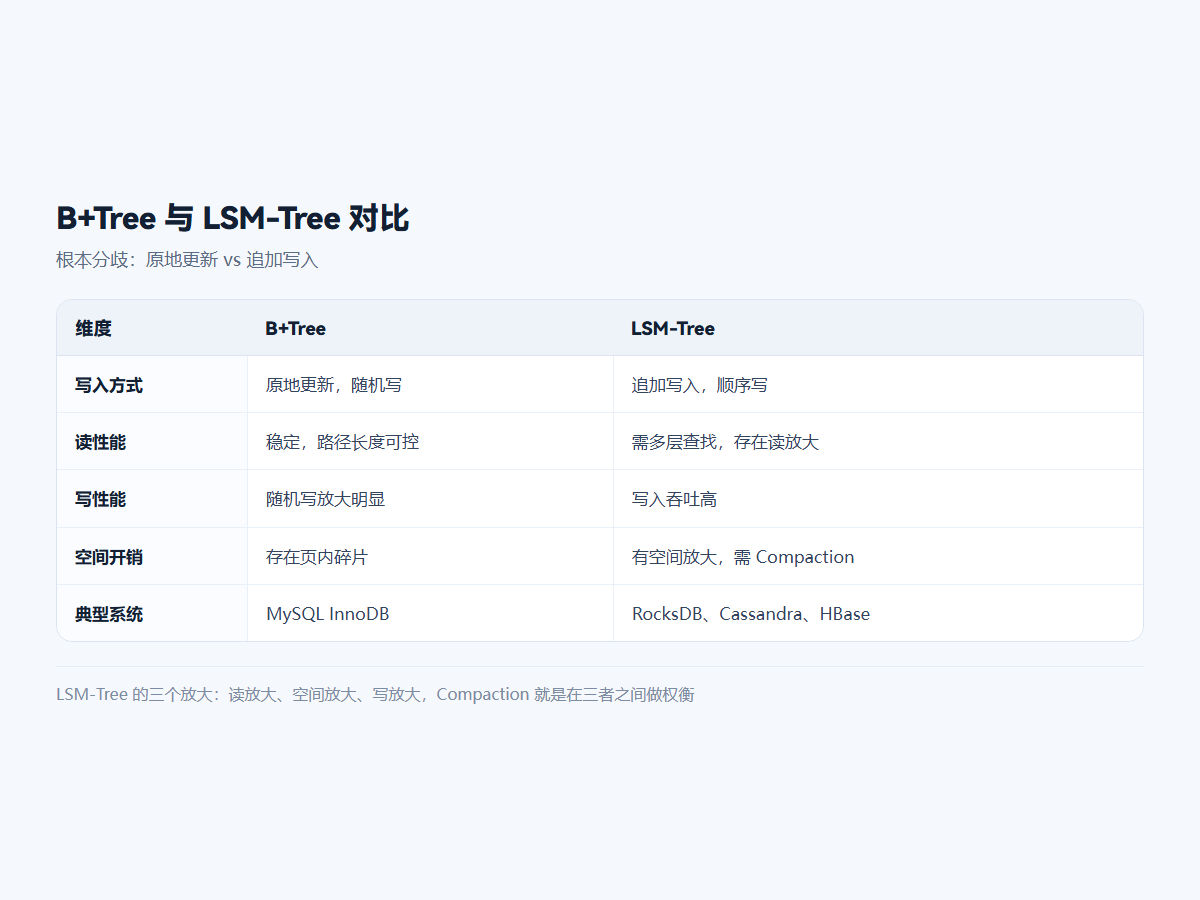
三、对比表
- 写入吞吐:LSM-Tree 明显更高(顺序写);B+Tree 在随机写场景下受页分裂拖累。
- 点查延迟:B+Tree 更稳定且可预测;LSM-Tree 平均更低但长尾明显(受层数与 compaction 影响)。
- 范围查询:B+Tree 原生占优;LSM-Tree 需要跨多个文件归并,代价更高。
- 空间占用:B+Tree 更紧凑;LSM-Tree 存在空间放大。
- 读取一致性:B+Tree 读到的一定是最新值;LSM-Tree 要按层查找,依赖版本顺序。
- 运维复杂度:B+Tree 相对”省心”;LSM-Tree 需要调 compaction 策略,是持续的调优工作。
四、对应到实际系统
理解了这个框架,再看具体产品就清楚了:
- MySQL InnoDB 的聚簇索引是典型 B+Tree,因此它在读多写少、需要大量范围扫描和事务的 OLTP 场景下表现稳健。它的瓶颈在大量随机写入时的页分裂与刷盘压力。
- RocksDB 是 LSM-Tree 的代表实现,被大量分布式系统用作存储引擎,适合写吞吐要求高、读以点查为主的场景。使用时绕不开 compaction 调优。
- PostgreSQL 的堆表 + B+Tree 索引是另一种组合:数据存在堆里,索引是独立的 B+Tree。这个设计在更新频繁时会产生表膨胀(需要 VACUUM 清理),本质上也是一种”版本堆积”问题。
五、选型建议
不要问”哪个更好”,问下面三个问题:
1. 读写比例和访问模式是什么?
读多、范围查询多、要求延迟稳定→ B+Tree 系更省心。
写吞吐极高、以点查为主、能接受延迟抖动→ LSM-Tree 系更合适。
2. 有没有能力做持续调优?
这是最现实的一个问题。LSM-Tree 的性能高度依赖 compaction 策略与硬件匹配,需要有人持续看指标、调参数。没有这个人力,选 B+Tree 系会更稳。
3. 存储成本敏感吗?
如果数据量很大且预算敏感,LSM 的空间放大是实打实的成本,要按放大系数规划容量,不能按有效数据量算。
六、两个常见误解
误解一:LSM-Tree 写入快,所以什么都快
LSM 优化的是写吞吐,代价是读路径变长和后台 compaction 的资源占用。把它用在读密集、且对延迟稳定性要求高的场景,会得到比 B+Tree 更差的结果。
误解二:B+Tree 一定比 LSM 更占空间
通常 B+Tree 更紧凑,但B+Tree 也有碎片问题:大量删除和更新后,页内会出现空洞,需要重建表来回收空间。两类结构只是”放大”的表现形式不同——一个是版本堆积,一个是页内碎片。
七、小结
B+Tree 和 LSM-Tree 的分野,本质是把复杂度放在读路径还是写路径:B+Tree 保持了读的简单,把代价留给了随机写;LSM-Tree 把写变成顺序,把代价转移给读放大和后台合并。
近年也出现了不少混合结构的尝试(在 LSM 的某些层引入 B+Tree,或反过来),目的都是在两者之间找平衡点。但底层权衡没有变——复杂度不会消失,只会被搬走。理解它被搬到了哪里,就是理解一个存储引擎的开始。
标签
#存储引擎#B+Tree#LSM-Tree#计算机基础