JVM 是 Java 后端面试里最能区分用过和懂的一块。本文按内存结构、对象生命周期、GC 算法、回收器选型、调优排查五段组织,并结合 JDK 25 的紧凑对象头与分代 Shenandoah 等新变化,把 2026 年该答到的点补齐。
关键词JVM 面试、GC 算法、G1、ZGC、Shenandoah、内存泄漏、JDK 25
目录
JVM 是 Java 后端面试里最能区分”用过”和”懂”的一块。多数人能背出”堆分新生代和老年代”,但一追问”对象什么时候进入老年代””G1 为什么能设停顿目标””线上 Full GC 频繁你怎么排查”,就露怯了。
本文按内存结构 → 对象生命周期 → GC 算法 → 回收器选型 → 调优排查五段组织,并结合 JDK 25(2025 年 9 月发布的最新 LTS)的新变化,把 2026 年该答到的点补齐。
一、运行时数据区:先分清哪些共享、哪些私有
Q1:JVM 内存分哪几块?
高频追问:元空间(Metaspace)和永久代(PermGen)有什么区别?
- 永久代(JDK 7 及以前):在堆内,大小受
-XX:MaxPermSize限制,容易 OOM。 - 元空间(JDK 8 起):使用本地内存,理论上只受机器内存限制,默认值按需扩展。
- 迁移带来的实际变化:字符串常量池和静态变量移到了堆里(JDK 7 就开始迁移),类元信息留在元空间。
- 注意:元空间不受限不代表没风险,动态生成大量类(CGLib、反射、Groovy 脚本)仍会撑爆本地内存。
Q2:对象在内存里长什么样?
对象头(Mark Word + 类型指针)+ 实例数据 + 对齐填充。Mark Word 里存着哈希码、GC 分代年龄、锁状态标志——这也是 synchronized 锁升级(偏向锁 → 轻量级锁 → 重量级锁)的状态载体。
2026 年加分点:JDK 25 的紧凑对象头(JEP 519)已转正,通过
-XX:+UseCompactObjectHeaders可把 64 位平台上的对象头从 96–128 bit 压缩到 64 bit。对象密集型的负载通常能省下可观堆内存并改善数据局部性,相当于一次”免费升级”。落地前注意与所用 GC 组合的兼容性,需在目标环境实测验证。
二、对象生命周期:三个必考题
Q3:对象怎么判断”已死”?
不是引用计数法,是可达性分析。从 GC Roots 出发,能被引用链到达的对象是存活的,其余判定为可回收。
GC Roots 包括:虚拟机栈/本地方法栈中的引用、方法区中静态属性和常量的引用、被同步锁持有的对象、JVM 内部引用(如系统类加载器、异常对象)。
追问”引用计数法为什么不用“——因为它解决不了循环引用:A 引用 B、B 引用 A,两者计数都不为 0,但外部已经没人用了。
Q4:四种引用类型分别用在什么地方?
- 强引用:默认。只要存在,GC 绝不回收。
- 软引用(SoftReference):内存不足时才回收。适合做内存敏感的缓存。
- 弱引用(WeakReference):下一次 GC 就回收。
ThreadLocalMap、WeakHashMap用它来避免内存泄漏。 - 虚引用(PhantomReference):完全不影响生命周期,只用于在对象被回收时收到通知。典型用途是堆外内存的清理(DirectByteBuffer 的 Cleaner)。
高频连环问:”ThreadLocal 为什么会内存泄漏?“——
ThreadLocalMap的 key 是弱引用,value 是强引用。key 被 GC 回收后变成null,但 value 仍被Entry强引用着,而Entry又在线程的 map 里。如果线程长期不结束(线程池场景尤其严重),value 就永远无法回收。解法:用完必须调用remove()。
Q5:对象什么时候进入老年代?
三条路径:
- 年龄阈值:每熬过一次 Minor GC 年龄 +1,默认 15(
-XX:MaxTenuringThreshold)后晋升。 - 动态年龄判定:Survivor 区中同龄对象总大小超过 Survivor 一半时,大于等于该年龄的对象直接进入老年代。这条经常被漏答。
- 大对象直接进老年代:超过
-XX:PretenureSizeThreshold的对象(典型是长数组、大字符串)直接在老年代分配,避免在 Eden 和 Survivor 之间反复拷贝。
还有一条空间分配担保:Minor GC 前 JVM 会检查老年代剩余空间是否大于新生代对象总大小(或历次晋升的平均大小),不够则先触发一次 Full GC。
三、GC 算法:三个算法各自的代价
Q6:三种基础算法及优劣?
关键理解:复制算法在”大部分对象都会死”的前提下才划算。新生代对象朝生夕死(通常 98% 以上活不过一次 GC),所以只需要保留少量存活对象,10% 的 Survivor 空间就够了。老年代对象存活率高,用复制就得复制一大堆,所以改用标记-整理。
四、回收器选型:2026 年该答哪些
Q7:主流回收器怎么选?
- Serial / Serial Old:单线程,STW 全程暂停。只适合客户端或极小堆(百 MB 级)。
- Parallel / Parallel Old:吞吐量优先,多线程并行回收但 STW。JDK 8 默认。适合批处理、离线计算这类不在乎单次停顿、只在乎总吞吐的场景。
- CMS:并发标记清除,低停顿,但有碎片问题且已在 JDK 14 中被移除。了解即可,不要在新项目里提。
- G1:JDK 9 起的默认回收器。把堆划分成多个 Region,可预测的停顿时间模型(
-XX:MaxGCPauseMillis,默认 200ms),通过优先回收收益最高的 Region(Garbage First)来控制停顿。适合堆 4GB–数十 GB、要求均衡延迟与吞吐的服务。 - ZGC:超低延迟,停顿时间基本与堆大小无关,可稳定在毫秒级,支持 TB 级堆。核心技术是染色指针(Colored Pointers)+ 读屏障(Load Barrier),实现并发整理。JDK 21 起支持分代。
- Shenandoah:与 ZGC 同属低延迟阵营,核心技术是 Brooks 转发指针 + 读屏障,实现并发整理。JDK 25 中分代模式转正(JEP 521),可用
-XX:ShenandoahGCMode=generational开启,在短生命周期对象为主的负载上吞吐表现更好。
选型判断句:堆不大、追求吞吐 → Parallel;通用服务端、要平衡 → G1;延迟敏感且堆很大 → ZGC 或 Shenandoah。别一上来就说”用 ZGC”,它为了低延迟付出的是吞吐量下降和额外的内存开销(读屏障有成本)。
Q8:G1 为什么能设停顿目标?
因为它不再要求一次把整个代清理干净。G1 把堆分成约 2048 个大小相等的 Region,每个 Region 可以在新生代和老年代之间动态切换角色。回收时:
- 并发标记出各个 Region 的存活对象比例;
- 按”回收收益 / 停顿成本”排序;
- 在停顿目标的约束下,选择收益最高的一批 Region 作为回收集(CSet),采用复制算法把存活对象复制到空闲 Region;
- 一次只回收一部分,剩下的下次再来。
这就是”Garbage First”的含义:优先回收垃圾最多(收益最大)的区域,从而在有限的时间内拿到最大的空间收益。
Q9:ZGC 的染色指针是什么?
传统方案把对象状态(是否被移动、是否存活)存在对象头里,ZGC 把它编码进64 位指针的高位空闲比特里(所以叫”染色指针”,也叫 Colored Pointer)。好处是:
- 并发整理时不需要访问对象就能知道它的状态,大大减少了屏障操作的开销;
- 对象被移动后,只需修改指针的标记位;其他线程访问时会通过读屏障触发”自愈”——自动把指针修正到新地址,并重映射。
代价:需要 64 位平台、不支持压缩指针(Compressed Oops)、读屏障带来一定的运行时开销。
五、调优与排查:面试官真正想听的部分
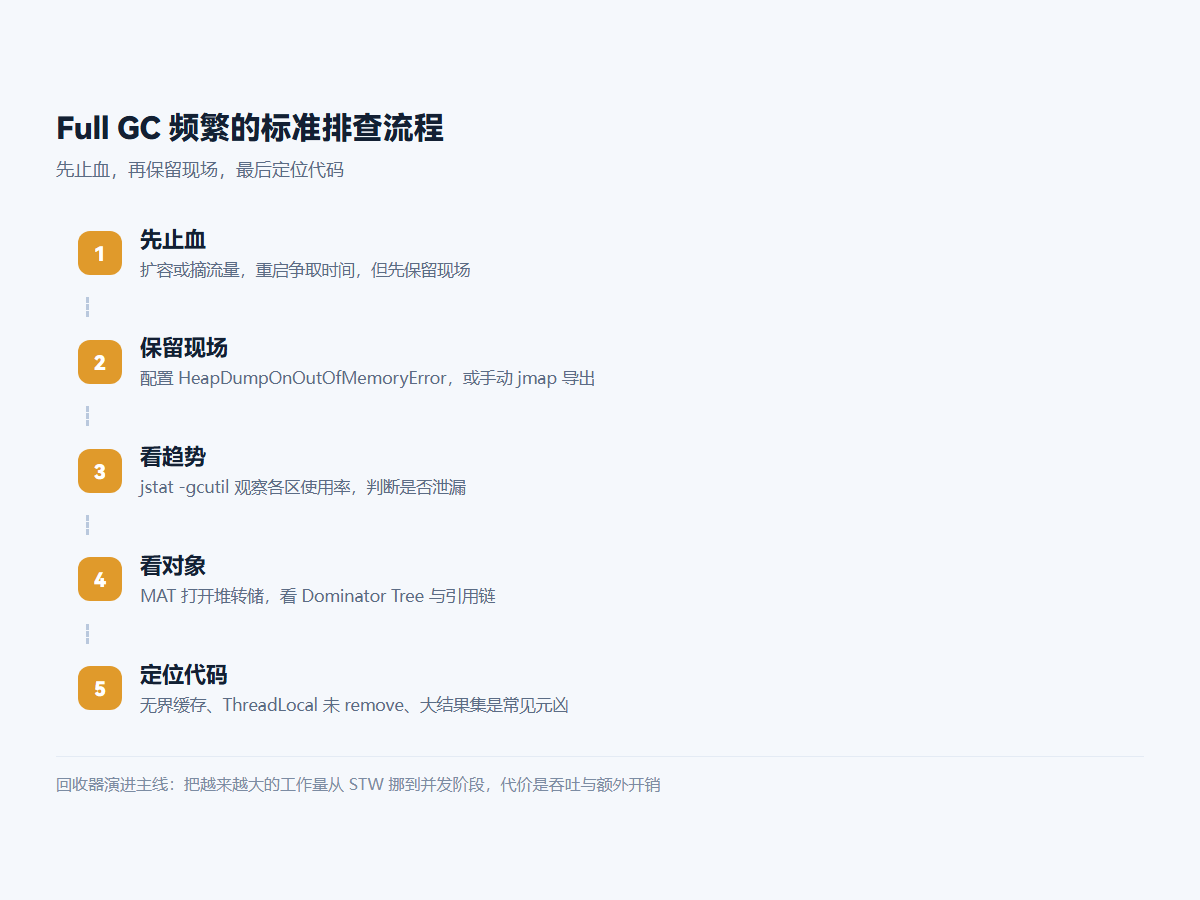
Q10:线上频繁 Full GC,你怎么排查?
给一套可复述的标准流程:
- 先止血:如果是突发,先扩容或摘流量,重启大法能争取时间,但一定要先保留现场。
- 保留现场:立即加
-XX:+HeapDumpOnOutOfMemoryError -XX:HeapDumpPath=/data/dump;或者手动jmap -dump:format=b,file=heap.hprof <pid>。 - 看趋势:
jstat -gcutil <pid> 1000观察各区使用率与 GC 次数,判断是内存泄漏(老年代持续上涨且 GC 后不降)还是容量不足。 - 看对象:用 MAT / JProfiler 打开堆转储,看 Dominator Tree 里最大的对象是谁、被谁引用。
- 定位代码:顺着引用链找到业务代码,常见元凶是无界集合缓存、ThreadLocal 未 remove、大结果集查询、流未关闭。
# 常用诊断命令速查
jps -l                      # 找进程
jstat -gcutil <pid> 1000    # 实时 GC 统计
jmap -histo <pid> | head -30        # 活对象直方图(轻量)
jmap -dump:live,format=b,file=h.hprof <pid>   # 堆转储
jstack <pid> > stack.txt    # 线程栈(查死锁、CPU 飙高)
jcmd <pid> VM.flags         # 查看实际生效的 JVM 参数
Q11:常用调优参数有哪些?
# 基础
-Xms4g -Xmx4g               # 堆大小设为相同,避免动态扩缩容抖动
-Xmn2g                      # 新生代大小(G1 下不建议手动设)
-XX:MetaspaceSize=256m -XX:MaxMetaspaceSize=512m

# G1
-XX:+UseG1GC
-XX:MaxGCPauseMillis=200    # 停顿目标,别设太小,否则 GC 会更频繁
-XX:InitiatingHeapOccupancyPercent=45   # 并发标记触发阈值

# ZGC
-XX:+UseZGC
-XX:+UseNUMA                # NUMA 架构下开启

# 诊断(生产建议常开)
-XX:+HeapDumpOnOutOfMemoryError -XX:HeapDumpPath=/data/dump
-Xlog:gc*:file=/data/logs/gc.log:time,uptime:filecount=10,filesize=100m
# JDK 25 性能相关
-XX:+UseCompactObjectHeaders # 紧凑对象头(需实测兼容性)追问”-Xms 和 -Xmx 为什么要设成一样“——避免 JVM 在运行中动态扩缩容,扩容时需要向操作系统申请内存并可能触发 GC,造成抖动。容器化环境下这一点尤其重要。
Q12:容器环境里 JVM 有什么坑?
经典问题:JVM 在 JDK 8u191 之前不识别 cgroup 内存限制,会按宿主机的物理内存来算默认堆大小。结果容器限制 1GB,JVM 却按 64GB 宿主机算出默认堆,直接被 OOM Killer 杀掉。
# 现代写法(JDK 8u191+ / JDK 11+ 默认开启)
-XX:+UseContainerSupport
-XX:MaxRAMPercentage=75.0 # 按容器限制的百分比分配堆,比写死 -Xmx 更灵活加分点:容器里不要写死 -Xmx,用 MaxRAMPercentage,这样调整 Pod 的 memory limit 时不用同步改 JVM 参数。
六、小结
JVM 这一块的答题主线是“分代假设 → 算法取舍 → 回收器定位”:绝大多数对象朝生夕死,所以新生代用复制算法;老年代存活率高,所以用标记-整理;回收器的演进主线是把越来越大的工作量从 STW 挪到并发阶段,代价是吞吐和额外开销。
2026 年回答时补上三点会显得跟得上:JDK 25 是当前 LTS;紧凑对象头(JEP 519)与分代 Shenandoah(JEP 521)已转正;虚拟线程的 synchronized 钉住问题已由 JEP 491 基本解决。
参考:OpenJDK JEP 索引、Oracle JDK 25 GC 调优指南、ZGC Wiki。参数与特性状态以所用 JDK 版本的官方文档为准。
标签
#JVM#GC#后端面试题#面试