设计一个秒杀系统这类题,最容易被答成一堆名词堆砌。本文按流量分层治理的思路组织:从客户端到数据库,逐层讲清每一层的手段、失效边界和常见追问,并给出一套可以直接套用的答题结构。
关键词高并发面试、限流算法、熔断降级、缓存雪崩、一致性哈希、系统设计
“设计一个秒杀系统””如何支撑百万 QPS”这类高并发题,是后端面试里最容易被答成一堆名词堆砌的一块。面试官听你念”限流、降级、缓存、MQ”的时候,其实在等你回答另一件事:你知道每一层挡住的是什么,以及挡不住的时候会发生什么。
本文按流量分层治理的思路组织:从客户端到数据库,逐层讲清每一层的手段、失效边界和常见追问。
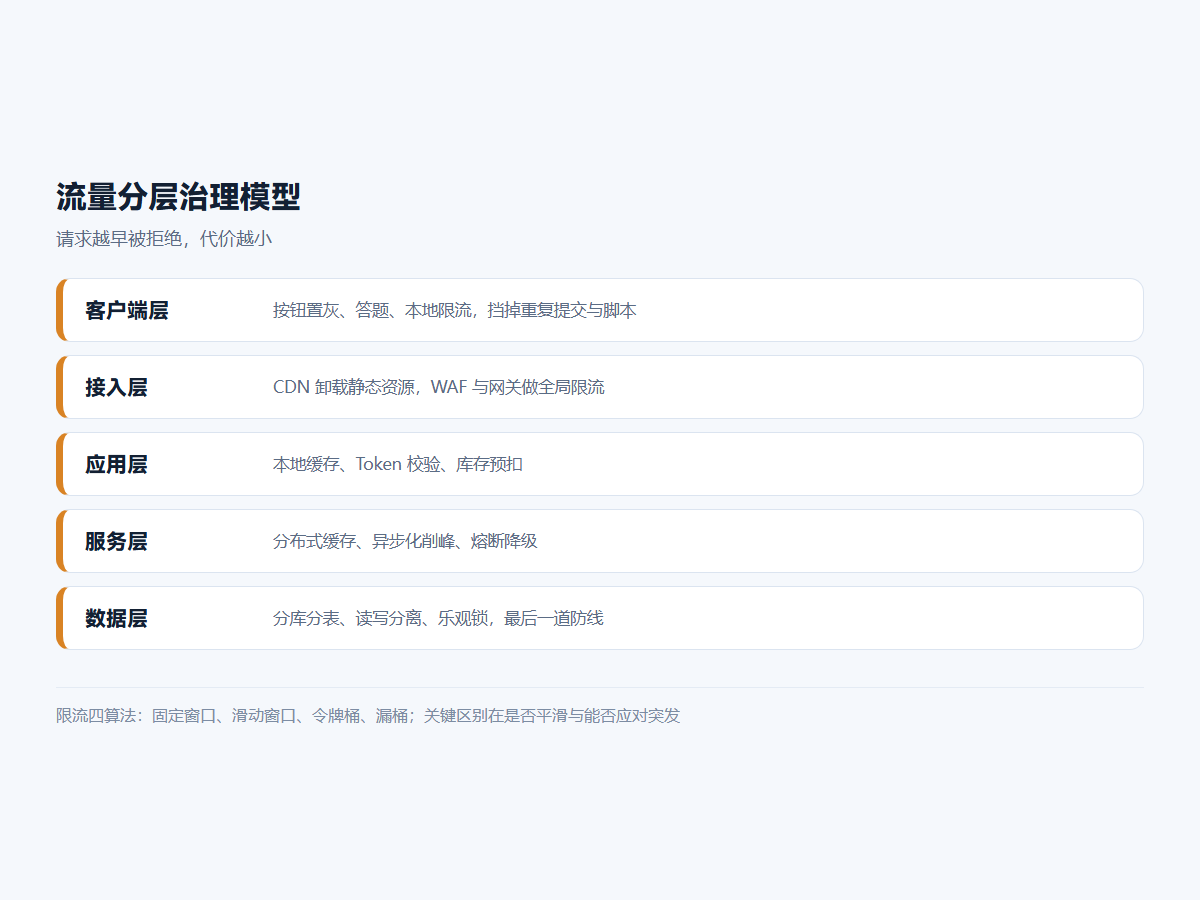
一、先建立一个正确的分层模型
高并发不是”加机器”,而是把尽可能多的请求在尽可能靠外的层挡掉或消化掉。标准的分层是:
- 客户端层:按钮置灰、答题、本地限流——挡掉重复提交和脚本。
- 接入层(CDN / 网关):静态资源卸载、WAF、全局限流——挡掉大部分无效流量。
- 应用层:本地缓存、Token 校验、库存预扣——承接真正的业务请求。
- 服务层:分布式缓存、异步化、熔断降级——削峰填谷。
- 数据层:分库分表、读写分离、乐观锁——最后一道防线。
高分开场白:“我做高并设计的第一原则是:请求越早被拒绝,代价越小。”只要说出这句,后面所有的手段都有了主线。
二、限流:三种算法必须会画出来
Q1:计数器、滑动窗口、令牌桶、漏桶有什么区别?
必考追问:固定窗口的临界问题。限流 100 QPS,如果在 0.9s 时来了 100 个请求、1.1s 时又来了 100 个,两个窗口各自都没超限,但这 0.2 秒内实际过了 200 个。滑动窗口就是为了解决它而出现的。
Q2:单机限流和分布式限流怎么选?
// 单机:令牌桶,性能好、无网络开销
RateLimiter limiter = RateLimiter.create(1000.0);   // Guava
if (!limiter.tryAcquire()) return tooManyRequests();

// 分布式:Redis + Lua(保证原子性)
// KEYS[1]=key, ARGV[1]=限流阈值, ARGV[2]=窗口秒数
local cur = redis.call('INCR', KEYS[1])
if cur == 1 then redis.call('EXPIRE', KEYS[1], ARGV[2]) end
return cur > tonumber(ARGV[1]) and 0 or 1
取舍要点:
- 单机限流:无网络开销、性能好,但机器数量变化时需要重新计算阈值;适合保护本机资源(CPU、连接池)。
- 分布式限流:精确控制全局总量,但每次请求都要打一次 Redis,本身成为热点;适合保护下游稀缺资源(数据库、第三方接口)。
- 实践上两者叠加:网关做粗粒度分布式限流,应用内再做一层单机限流兜底。
三、削峰:把尖峰拉成平谷
Q3:秒杀场景为什么要异步化?
同步链路的问题:100 万请求直接打到数据库,数据库连接池瞬间被打满,正常业务也跟着挂。异步化的本质是用 MQ 做缓冲区,把”瞬时 100 万”变成”匀速消费 1 万/秒”。
// 标准秒杀链路
// 1. Redis 预扣库存(原子操作,挡掉 99% 的请求)
Long remain = redis.eval(DECR_STOCK_LUA, keys, args);
if (remain < 0) return "已售罄";

// 2. 写入 MQ,立即返回"排队中"
mq.send(new OrderCreatedEvent(userId, skuId));

// 3. 消费者匀速落库,前端轮询或推送结果
// → 数据库实际承受的是消费速率,不是请求速率追问:MQ 积压了怎么办?三个层次——① 临时扩容消费者;② 如果积压在业务低峰期可以慢慢消化,就不用管;③ 真正危险的是消息堆积导致磁盘写满或 TTL 过期丢失,所以要设积压告警 + 死信队列兜底。
Q4:缓存三大问题的标准解法
// 逻辑过期方案:value 里带一个逻辑过期时间,物理上永不过期
class CacheItem {
    Object data;
    long   expireAt;   // 逻辑过期时间
}

// 命中后发现逻辑过期:不阻塞,先返回旧值,另起线程重建
if (item.expireAt < now) {
    executor.submit(() -> rebuildWithLock(key));   // 只放一个线程去重建
    return item.data;    // 其他线程继续用旧数据,不等待
}区分要点:击穿是”一个 key”,雪崩是”一批 key”。面试官经常故意混着问,你主动点出来会加分。
四、熔断与降级:什么时候该认输
Q5:熔断器的三种状态怎么转换?
- Closed(关闭):正常放行,统计失败率。
- Open(打开):失败率超阈值后,直接快速失败,不再调用下游。这是为了让下游有喘息时间恢复。
- Half-Open(半开):熔断一段时间后,放少量探测请求;成功则回到 Closed,失败则回到 Open。
关键认知:熔断保护的是下游,降级保护的是自己。熔断是”调用方发现下游不行了,先别打了”;降级是”我自己扛不住了,把非核心功能关掉保住核心链路”。
降级常见手段:返回兜底数据(默认值、缓存旧值)、关闭非核心功能(推荐、评论、排行榜)、异步化非必要步骤。
Q6:熔断和限流的区别?
一句话:限流是”我做不了这么多”,熔断是”下游不行了,我别给它添乱”。限流发生在入口,熔断发生在出口;限流是主动的容量管理,熔断是被动的故障响应。
五、一致性相关的高频追问
Q7:一致性哈希是什么?解决了什么问题?
普通哈希取模(hash(key) % N)的问题:节点数 N 变化时,几乎所有 key 的映射都会改变。集群从 3 台扩到 4 台,缓存命中率会直接崩掉,导致大量请求穿透到数据库。
一致性哈希把节点和 key 都映射到一个 0 ~ 2^32 的哈希环上,key 顺时针找第一个节点。增删节点时只影响环上相邻的一小段 key,大部分映射保持不变。
追问:节点太少导致数据倾斜怎么办?引入虚拟节点——一个物理节点对应环上几百个虚拟节点,让分布更均匀。这是标准答案,必须能说出来。
// 虚拟节点示意
for (int i = 0; i < VIRTUAL_NODES; i++) {
    String vnode = physicalNode + "#" + i;
    ring.put(hash(vnode), physicalNode);   // TreeMap 有序环
}
// 查找:tailMap(hash(key)) 取第一个,没有则回到环首
Q8:库存扣减怎么防超卖?
三种方案,按强度和代价递进:
- 数据库乐观锁:
UPDATE stock SET num = num - 1 WHERE sku_id = ? AND num > 0,靠影响行数判断是否成功。简单可靠,但高并发下大量失败重试,数据库压力大。 - Redis 原子预扣:Lua 脚本保证”判断 + 扣减”原子性,挡掉绝大部分请求,只有真正下单的才落库。秒杀场景的标准做法。
- 分段库存:把 1000 件库存拆成 10 个段各 100 件,请求随机落到某一段,把热点打散。能显著提升并发上限,代价是可能出现”某段卖完了但总量还有”的情况,需要额外的归并逻辑。
必考陷阱:”先查再改为什么不行?“——因为
SELECT num和UPDATE是两条语句,并发下两个事务可能同时读到num=1,然后都判断通过后扣减,结果变成 -1。核心是判断与修改必须在同一个原子操作里完成。
Q9:接口幂等怎么保证?
- 唯一索引:最简单可靠。业务上用一个唯一键(订单号 + 操作类型),重复插入直接报错捕获。
- Token 机制:进入页面前先申请一个 token,提交时带上,服务端校验后删除。用 Redis 的
DEL返回值判断是否首次(原子性)。 - 状态机:更新时带上前置状态,
WHERE status = 'CREATED',只有状态匹配才更新。 - 分布式锁:兜底手段,代价最高,慎用。
// Token 幂等:DEL 是原子的,返回 1 表示首次提交
Long deleted = redis.del("idempotent:" + token);
if (deleted == null || deleted == 0) {
    return "重复提交";     // 已被消费过
}
// 继续处理业务...
六、怎么把设计题答出层次
给一个可以直接套用的答题结构:
- 先问清量级:峰值 QPS 多少?读多写少还是相反?一致性要求多高?开口就上 Redis 集群是减分项。
- 给出分层架构:从 CDN 到数据库,画出请求流经的每一层,标注每层挡掉多少。
- 抓住核心矛盾:秒杀的核心是”库存扣减的原子性 + 流量削峰”;Feed 流的核心是”读写放大与扇出”;排行榜的核心是”实时性与写压力”。不同场景矛盾不同,别一套方案打天下。
- 主动说代价:每个方案都有副作用——异步化带来一致性延迟,缓存带来数据陈旧,限流带来部分用户失败。能说出”我接受什么代价”是资深和初级的分水岭。
- 补上可观测:监控哪些指标(QPS、RT、错误率、缓存命中率、MQ 积压)、告警阈值怎么定。
七、小结
高并发设计题考察的不是方案背诵,而是分层治理的思维方式 + 对每个手段失效边界的认知。把五层模型记住,把限流四算法、缓存三问题、熔断三状态、幂等四方案讲清楚,再配上”请求越早被拒绝代价越小”这条主线,这一块就能答得有结构、有取舍。
参考:Redis Lua 脚本文档、Sentinel 官方文档、Resilience4j 文档。实现细节请以所用组件的最新官方文档为准。
标签
#后端面试题#高并发#系统设计#面试