ArkTS 语言特性与并发模型是鸿蒙面试里最能区分写过 Demo 和做过项目的一块。本文按语言约束、类型系统、并发模型、线程通信、常见坑组织,讲清每一条限制的真正理由,并给出 UI 不刷新时的排查顺序。
关键词鸿蒙面试题、ArkTS、TaskPool、Worker、并发模型、ArkUI 状态管理
鸿蒙面试题里,ArkTS 语言特性与并发模型是最能区分”写过 Demo”和”做过项目”的一块。原因很简单:ArkTS 不是 TypeScript,它在 TS 的基础上加了静态约束;而鸿蒙的并发模型(TaskPool / Worker)和传统线程模型差异明显,很多人只会用 async/await,一问到跨线程数据传递就答不上来。
本文按语言约束 → 类型系统 → 并发模型 → 线程通信 → 常见坑组织,每题给出可直接口述的答案。
一、ArkTS 与 TypeScript:到底差在哪
Q1:ArkTS 是 TypeScript 的超集还是子集?
严格说是”受限子集 + 扩展”。ArkTS 基于 TypeScript 语法,但主动砍掉了一部分动态特性,同时增加了自己的语法(装饰器、ArkUI 声明式描述)。
被限制的核心原因只有一个:为了在编译期进行更激进的优化,并保证运行时行为可预测。ArkTS 的编译目标是确定性强、性能可预期的运行环境,动态特性会让这些优化失效。
Q2:具体哪些 TS 特性在 ArkTS 里不能用?
高分表述:“ArkTS 用’牺牲一部分 TS 的动态灵活性’,换取了’编译期可确定的对象布局’。”这句话能解释后面几乎所有语法限制——包括为什么必须给属性初始值、为什么不能动态加字段。
Q3:为什么 ArkTS 要求属性必须有初始值或明确可选?
// 不合规:属性未初始化且未标记可选
class User {
  name: string        // 报错:必须初始化或标记 ?
}

// 合规写法
class User {
  name: string = ''                 // 给默认值
  age?: number                      // 明确可选
  readonly id: string               // 构造函数中赋值
  constructor(id: string) { this.id = id }
}原因:编译器需要为每个类生成固定的对象布局(隐藏类)。如果属性可以在运行期才出现,属性访问就无法优化成固定偏移量的内存读取,只能退化成哈希查找,性能大幅下降,也让 AOT 编译难以进行。
二、类型系统:名义类型是核心差异
Q4:什么是名义类型(Nominal Typing)?和结构类型有什么不同?
interface PointA { x: number; y: number }
interface PointB { x: number; y: number }

// TypeScript(结构类型):结构相同即可赋值,编译通过
let a: PointA = { x: 1, y: 2 }
let b: PointB = a          // OK

// ArkTS(名义类型):需要显式声明类型关系
interface PointB extends PointA { }   // 或用 implements
let b: PointB = a as PointB // 需要显式转换影响:从 TS 迁过来的代码,很多隐式兼容的赋值会报错。处理方式是用 extends/implements 显式建立关系,或适度重构类型定义,而不是到处 as 强转。
Q5:as 类型转换在 ArkTS 里有什么限制?
- 只能在有继承/实现关系的类型之间转换,或者用于可空类型断言(
obj!.prop)。 - 不能像 TS 那样用
as any绕过类型检查——ArkTS 对any的支持是受限的。 - 优先用类型守卫(
instanceof、typeof)做安全收窄,而不是强转。
Q6:泛型与空安全怎么落地?
// 泛型约束
function getFirst<T extends object>(list: T[]): T | undefined {
  return list.length > 0 ? list[0] : undefined
}

// 空安全:可空类型必须处理
let name: string | undefined = getName()
// let len = name.length            // 报错:可能为 undefined
let len = name?.length ?? 0         // 正确:可选链 + 空值合并

if (name !== undefined) {
  console.info(name.length)         // 收窄后安全
}要点:ArkTS 的空安全是编译期强制的,与 Kotlin/Swift 的可空类型思路一致。养成用 ?. 和 ?? 的习惯,比到处加 ! 断言更可取。
三、并发模型:鸿蒙面试的核心区
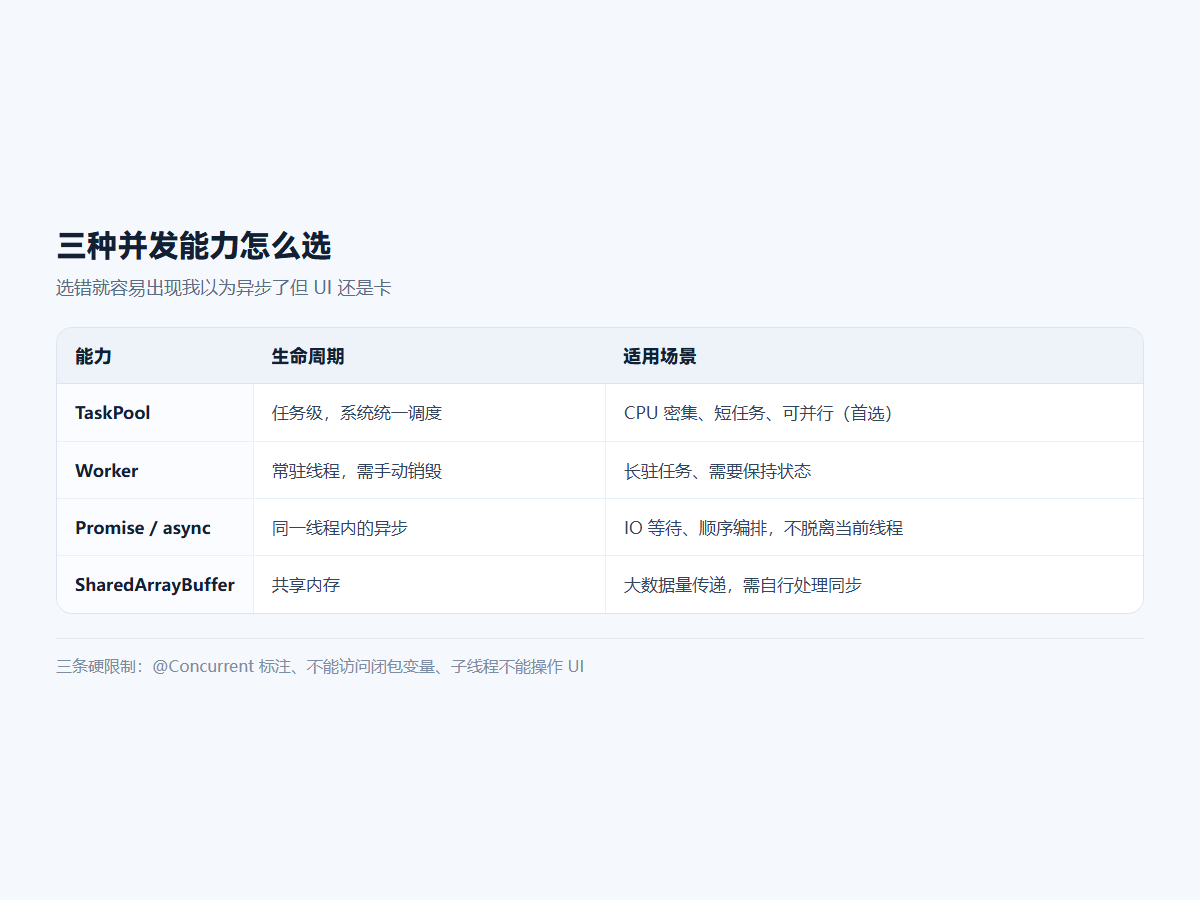
Q7:鸿蒙有几种并发能力?怎么选?
一句话选型:能用 TaskPool 就用 TaskPool,需要常驻才用 Worker,只是等 IO 用 Promise 就够了。很多人的误区是把
async/await当成”多线程”——它只是不阻塞当前线程的等待,实际执行仍在原线程。
Q8:TaskPool 怎么用?有什么限制?
import { taskpool } from '@kit.ArkTS'

@Concurrent
function heavyCompute(data: number[]): number {
  // 这个函数运行在任务池的工作线程里
  let sum = 0
  for (const v of data) sum += v * v
  return sum
}

async function run() {
  const data = generateLargeArray()
  // 派发任务,返回 Promise
  const result = await taskpool.execute(heavyCompute, data) as number
  console.info(`结果:${result}`)

  // 批量执行多个任务
  const tasks = chunks.map(c => new taskpool.Task(heavyCompute, c))
  const results = await taskpool.execute(tasks) as number[]
}
三个硬性限制必须记住:
- 必须用
@Concurrent装饰器标注并发函数。 - 函数体内不能访问外部闭包变量,所有输入只能通过参数传入。
- 不能使用线程本地存储、不能操作 UI;
taskpool工作线程里没有 UI 上下文。
另外任务执行有时间上限(长耗时任务建议用 Worker),且系统会根据负载动态调整工作线程数量,不要依赖固定并发数做业务假设。
Q9:Worker 和 TaskPool 的数据传递有什么区别?
两者都不是共享内存,都通过结构化克隆(序列化/反序列化)传递数据。区别在于通信模型:
- TaskPool:一次性派发任务并拿回结果,模型简单,适合无状态计算。
- Worker:通过
postMessage/onmessage双向持续通信,Worker 内可以持有长期状态。
// 主线程
const worker = new worker.ThreadWorker('entry/ets/workers/MyWorker.ets')
worker.onmessage = (e: MessageEvents) => {
  console.info(`收到:${e.data}`)
}
worker.postMessage({ cmd: 'start', payload: data })
// 用完必须销毁,否则线程常驻
worker.terminate()

// Worker 线程(MyWorker.ets)
workerPort.onmessage = (e: MessageEvents) => {
  const result = process(e.data.payload)
  workerPort.postMessage(result)
}追问”能不能共享内存避免拷贝?“——可以,鸿蒙提供了 SharedArrayBuffer / Atomics 等能力用于大数据量的共享,但需要自己处理同步(用 Atomics 做原子操作与等待通知)。这是进阶考点,能说出来说明做过真实的性能优化。
Q10:为什么不能在子线程更新 UI?
因为 UI 组件树不是线程安全的。ArkUI 的组件树在主线程构建和刷新,如果允许多线程并发修改,会需要大量锁来保证一致性,代价远超收益。这也是几乎所有 UI 框架的共识(Android、iOS、Flutter 都是单线程 UI 模型)。
正确做法:子线程算完 → 把结果传回主线程 → 更新状态变量 → 触发 UI 刷新。耗时任务结束后通常需要切回主线程更新 @State。
四、状态管理与渲染:常见的连环追问
Q11:@State 和 @Prop 的区别?
@State:组件私有状态,变化时触发该组件及其子组件的重新渲染。必须初始化。@Prop:单向从父组件传入,子组件内部修改不会同步回父组件。适合”父给子传值,子只读或本地改”。@Link:双向绑定,子组件的修改会同步回父组件的@State。调用时要用$语法传引用。
@Component
struct Child {
  @Prop countProp: number = 0      // 单向
  @Link countLink: number          // 双向
  build() { /* ... */ }
}

@Component
struct Parent {
  @State count: number = 0
  build() {
    Child({ countProp: this.count, countLink: $count })   // Link 用 $
  }
}
Q12:深拷贝 vs 浅拷贝在状态更新里的坑?
核心陷阱:直接修改对象内部字段不会触发刷新,必须整体替换引用。
// 反例:改了字段但引用没变,UI 不会刷新
this.user.name = 'Tom'           // @State user: User,不会触发更新

// 正例:整体替换
this.user = new User('Tom', this.user.age)
// 或展开语法
this.user = { ...this.user, name: 'Tom' }

// 数组的同理
this.list.push(item)                    // 不一定触发
this.list = [...this.list, item] // 正确原理:@State 的观察粒度是”引用是否变化”(浅观察)。深层的嵌套对象变化需要配合 @Observed + @ObjectLink 才能被观察到。
Q13:@Observed 和 @ObjectLink 解决什么问题?
@Observed
class User {
  name: string
  age: number
  constructor(name: string, age: number) { this.name = name; this.age = age }
}

@Component
struct UserCard {
  @ObjectLink user: User        // 能观察到嵌套对象内部的属性变化
  build() {
    Row() {
      Text(this.user.name)
      Button('改名').onClick(() => { this.user.name = 'Jerry' })  // 会刷新
    }
  }
}关键点:@Observed 装饰类,@ObjectLink 装饰子组件中的变量,且不能在子组件里初始化(必须由父组件传入)。这套组合是处理”嵌套对象/数组元素”刷新的标准方案。
五、常见踩坑清单
Q14:ArkTS 里最容易犯的错误有哪些?
- 把
async/await当多线程用——它不脱离当前线程,CPU 密集任务照样卡 UI。 - 在子线程里直接改
@State——跨线程操作 UI 未定义行为,必须切回主线程。 - 直接改对象字段期望刷新——必须整体替换引用,或用
@Observed/@ObjectLink。 - 在 build 里做耗时操作——
build()会被频繁调用,必须保持轻量,且不允许有副作用。 - 在 build 里改状态——会造成无限重建循环。
- Worker 忘了 terminate——线程常驻,内存和 CPU 持续占用。
- 把大量数据通过 postMessage 频繁传递——序列化开销大,大数据应考虑共享内存或分批。
Q15:怎么排查”UI 不刷新”?
给一套排查顺序:
- 确认状态变量是否用了正确的装饰器(
@State/@Link/@ObjectLink)。 - 确认是整体替换了引用而不是只改了内部字段。
- 确认修改发生在主线程(子线程回调里改状态不会生效)。
- 确认被观察的对象类型是否支持观察(基础类型、数组、
@Observed类)。 - 用 DevEco Studio 的 ArkUI Inspector 看组件树与状态,确认数据是否真的变了。
六、小结
ArkTS 与并发这一块的答题主线是“约束及其理由”:语言层面的每一条限制(禁止动态属性、名义类型、强制初始化)都指向同一个目的——让编译器能在编译期确定对象布局,从而做激进优化。并发层面的三条能力(Promise / TaskPool / Worker)则对应“等待”、”短任务并行”、”长驻任务”三种需求,选错就容易出现”我以为异步了但 UI 还是卡”这种典型问题。
准备策略:把”ArkTS 不是 TypeScript”和”async 不等于多线程”这两句话讲透,再配上 TaskPool 与 Worker 的选型对照,这一块基本就稳了。
参考:HarmonyOS ArkTS 开发指南、TaskPool 官方文档。语言规范与 API 随版本迭代,请以所用 SDK 版本的官方文档为准。
标签
#鸿蒙面试题#ArkTS#并发#面试