后端面试必考组合:MySQL 的 B+Tree 索引、覆盖索引与回表、最左前缀、锁与隔离级别;Redis 的三大缓存问题与内存淘汰策略,以及最难答的缓存一致性四问。
关键词MySQL索引、B+Tree、间隙锁、隔离级别、Redis、缓存一致性、缓存穿透
MySQL 与 Redis 几乎是后端面试的必考组合:前者考察你对存储引擎与并发控制的理解,后者考察你对缓存设计与一致性的把握。两者结合的那道”缓存一致性”题,更是区分初中高级的分水岭。
本文按高频真题组织,每题给出标准答法与追问陷阱。
一、索引:从数据结构问到优化
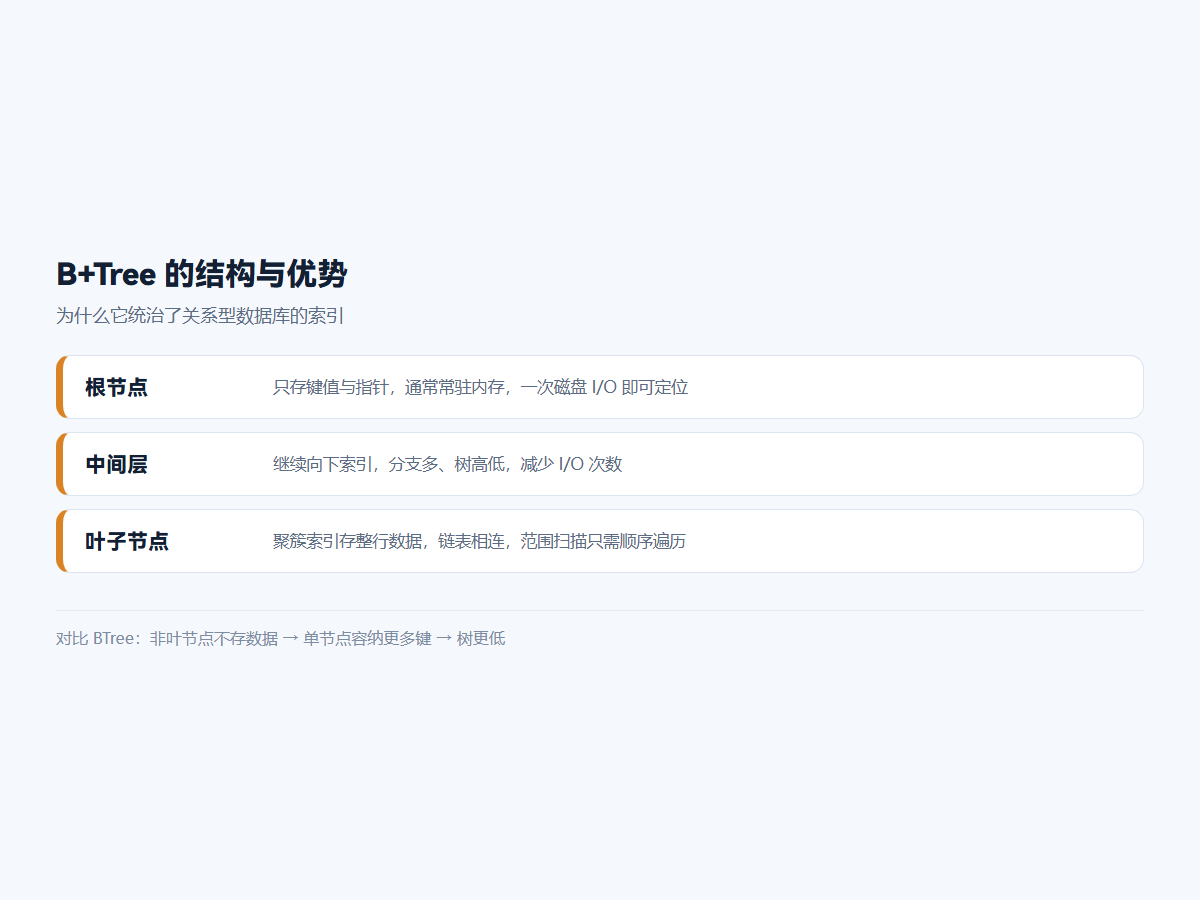
Q1:为什么 MySQL 用 B+Tree 而不是 BTree 或哈希?
- 对比哈希:哈希只支持等值查询,不支持范围查询与排序,而业务里
BETWEEN、ORDER BY极其常见; - 对比 BTree:B+Tree 的非叶子节点只存键值不存数据,因此单个节点能容纳更多键,树高更低、磁盘 I/O 次数更少;
- B+Tree 的叶子节点用链表相连,范围扫描只需顺序遍历叶子节点,效率极高。
Q2:聚簇索引和二级索引的区别?什么是回表?
InnoDB 中,聚簇索引的叶子节点存整行数据(按主键组织);二级索引的叶子节点存主键值。通过二级索引查到主键后,再到聚簇索引取完整行,这个过程叫回表。
追问:“怎么避免回表?” → 覆盖索引:让查询的字段都包含在索引里,EXPLAIN 中会出现 Using index。
Q3:最左前缀原则是什么?
对联合索引 (a, b, c),查询条件必须从最左列开始连续匹配才能用上索引。a=1 AND b=2 可用;b=2 不可用;a=1 AND c=3 只能用到 a 部分。注意:范围查询之后的列无法继续走索引。
Q4:哪些情况索引会失效?
- 对索引列做函数运算或隐式类型转换(如
WHERE YEAR(created_at)=2026、字符串列传数字); - 使用
LIKE '%xxx'前置通配符; - 违反最左前缀;
OR连接的条件中存在未建索引的列;- 优化器判断回表代价过高(如命中行数占比太大)时选择全表扫描。
二、锁与事务隔离
Q5:InnoDB 有哪几种行锁?
- 记录锁(Record Lock):锁单条索引记录;
- 间隙锁(Gap Lock):锁索引记录之间的间隙,防止插入;
- 临键锁(Next-Key Lock):记录锁 + 间隙锁,锁”左开右闭”区间,是 InnoDB 默认行锁算法。
Q6:为什么有间隙锁?
为了解决幻读。在可重复读(RR)隔离级别下,间隙锁阻止在范围内插入新记录,从而保证同一事务内两次范围查询结果一致。
Q7:RR 和 RC 的区别?生产选哪个?
互联网业务常选 RC:并发度更高、死锁更少,幻读问题通过业务设计规避。
Q8:死锁怎么排查与避免?
排查用 SHOW ENGINE INNODB STATUS 查看最近死锁日志;避免手段:固定加锁顺序、缩短事务、减少锁定范围、合理设计索引(没索引会升级为表锁)。
三、Redis:数据结构与过期
Q9:Redis 为什么快?
四点:① 纯内存操作;② 单线程模型避免锁与上下文切换(指命令执行主线程);③ I/O 多路复用;④ 高效数据结构。注意补充:Redis 后期版本引入了多线程处理网络 I/O,但命令执行仍是单线程。
Q10:缓存穿透、击穿、雪崩分别是什么?怎么解决?
Q11:内存满了怎么办?淘汰策略怎么选?
常用:allkeys-lru(所有 key 中淘汰最近最少用)、volatile-lru(只在设了过期时间的 key 中淘汰)、allkeys-lfu(淘汰最不经常使用,适合有明显热点且希望保留高频访问数据的场景)。若数据不允许丢失,应设为 noeviction 并配合监控扩容。
四、缓存一致性:核心难题
Q12:先更新数据库还是先删缓存?
推荐 先更新数据库,再删除缓存(Cache-Aside)。原因:如果先删缓存再更新数据库,在删除后、更新完成前的并发读会把旧值重新写回缓存,导致长期不一致——这个概率远高于另一种顺序。
Q13:删缓存失败了怎么办?
三层保障:① 重试机制;② 订阅数据库 binlog 异步删除(如 Canal 类方案);③ 设置较短的过期时间兜底。第二点是生产环境的常见做法:
// Cache-Aside 标准写法:更库 + 删缓存,失败进重试队列
public void updateItem(Item item) {
    itemMapper.update(item);                       // 1. 先更库
    boolean ok = redis.delete(key(item.getId()));  // 2. 再删缓存
    if (!ok) {
        retryQueue.offer(new CacheEvictTask(item.getId(),
            System.currentTimeMillis() + backoff()));  // 3. 失败重试
    }
}
// 兜底:Canal 订阅 binlog 的 row_change 事件再删一次,
// 即使应用层两次都失败,最终也会被 binlog 驱动的删除修正
Q14:能做到强一致吗?
能,但代价是加锁串行化(读时加读锁、写时加写锁),吞吐会大幅下降。绝大多数业务的正确选择是最终一致 + 过期时间 + 监控对账。
加分答法:主动说明”缓存的作用是提升读性能,不应承担强一致职责。如果业务要求强一致,应该考虑读写分离到主库,而不是给缓存加复杂的同步逻辑。”
五、小结
MySQL 部分的答题主线是 B+Tree → 索引优化 → 锁与隔离级别;Redis 部分是 数据结构 → 过期与淘汰 → 三大缓存问题 → 一致性。
准备时最有效的方法是:把每个结论都用 EXPLAIN 或 Redis 命令实际验证一遍。面试时能说出”我用 EXPLAIN 看过,这个查询没走索引是因为隐式类型转换”,比背诵十条规则更有说服力。
版本参考:MySQL LTS 版本信息见 endoflife.date,Redis 版本见 endoflife.date;采集于 2026 年 9 月 1 日。实现细节请以 MySQL 官方文档 与 Redis 官方文档 为准。
标签
#MySQL#Redis#后端面试题#数据库