多线程性能不升反降,CPU 没跑满、锁也没竞争——问题可能出在伪共享。本文讲清 64 字节缓存行的作用、伪共享的产生机制、三种解法与面试高分答法。
关键词伪共享、缓存行、False Sharing、MESI、并发编程、性能优化
有一段代码,单线程跑得飞快,一上多线程就慢得离谱,而且加的线程越多越慢。排查半天发现:CPU 没跑满、锁竞争也不严重、业务逻辑毫无问题。
元凶往往藏在你根本没看过的地方——CPU 缓存行与伪共享(False Sharing)。这是并发编程中最被低估、也最容易被误诊的性能杀手。
一、先建立缓存行的基本认知
CPU 访问内存的速度比访问缓存慢一到两个数量级。为了摊薄这个差距,CPU 不是按字节读内存,而是按”缓存行”(Cache Line,主流架构为 64 字节)为单位整块加载。
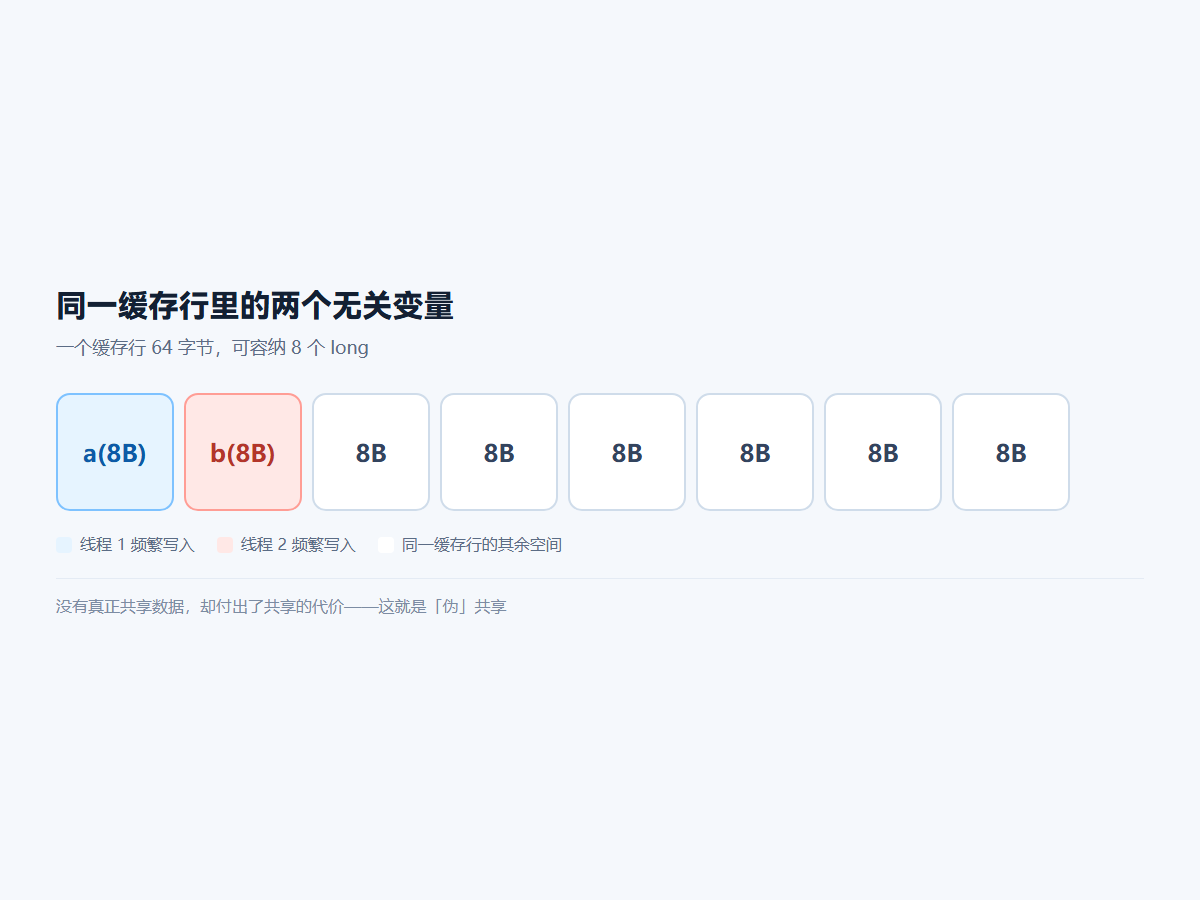
关键推论:即使你只改一个 8 字节的 long,CPU 也会把包含它的整个 64 字节缓存行加载进来。在多核环境下,这带来了缓存一致性协议的开销。
二、伪共享是怎么发生的
假设有两个变量 a 和 b,它们在内存中恰好相邻,落在同一个缓存行里:
class Counter {
  volatile long a;  // 线程 1 反复写
  volatile long b;  // 线程 2 反复写
}
从逻辑上看,两个线程写的是完全不同的变量,没有任何数据竞争。但从 CPU 的角度:
- 线程 1 改了
a,它所在的缓存行被标记为脏; - 缓存一致性协议(MESI)会让其他核心上同一个缓存行的副本全部失效;
- 线程 2 想写
b,发现缓存行失效,必须重新从内存加载; - 线程 2 写完,又把线程 1 的副本搞失效……
结果就是:两个毫无关联的变量,因为住在同一间”房子”里,导致两个核心反复互相使绊子。 这就是伪共享——没有真正共享数据,却付出了共享的代价。
三、怎么判断自己踩了这个坑
三个特征同时出现时,高度怀疑伪共享:
- 多线程性能不升反降,线程数越多越慢;
- CPU 使用率很高,但有效吞吐很低(大量时间在缓存一致性上);
- 用 perf 等工具观察时,能看到大量的缓存未命中与总线事务。
Linux 下可以用 perf c2c 观察 cache line 的争用热点;Java 侧可用 JFR 的相关事件辅助定位。
四、三种解法
1. 填充(Padding):把变量隔开
最常见的做法是在变量前后填充无用字段,让它们各自独占一个缓存行:
// Java 8+ 可用 @Contended(需 JVM 参数启用)
@sun.misc.Contended
static final class PaddedCounter {
    volatile long value;
}

// 或手动填充(示意)
class PaddedLong {
    volatile long value;
    long p1, p2, p3, p4, p5, p6, p7; // 占位
}
2. 让每个线程写自己的对象
更彻底的方案是避免共享:让每个线程持有独立的计数器,读取时再汇总。这也是 LongAdder 相比 AtomicLong 在高争用下快得多的原因——它内部把计数分散到多个单元,降低争用。
3. 只读数据无需处理
伪共享只对频繁写入的场景有害。只读或极少写的数据放在同一个缓存行里反而能提升缓存命中率,不要盲目填充——填充会增加内存占用,过犹不及。
五、实践中的取舍
最重要的建议:先测量,再优化。 伪共享只在”高频写入 + 变量相邻”时才值得处理。凭感觉到处加填充,只会让代码变丑、内存变多,性能毫无变化。
六、面试怎么答
如果被问到”什么是伪共享”,一个完整的回答要包含四层:① 缓存行是 CPU 加载内存的最小单位(64 字节);② 多核间通过一致性协议保证缓存行同步;③ 相邻变量被不同线程写入时会产生无谓的失效风暴;④ 解法是填充隔离、分片计数或减少共享写入。
能补上一句”只读共享不是问题,盲目填充反而有害”,基本就是高分答案。
七、小结
伪共享是典型的”知道很简单,不知道就永远查不出来”的问题。它提醒我们一件事:并发性能的瓶颈,往往不在你写的逻辑里,而在硬件如何执行你的代码。
当多线程性能表现反常时,把怀疑范围从”锁”扩展到”内存布局”,你会少走很多弯路。
延伸阅读:MDN · SharedArrayBuffer(前端多线程共享内存同样受此影响)。硬件相关行为请以具体 CPU 架构手册为准。
标签
#计算机基础#并发编程#CPU缓存#性能优化