拥塞控制的分布式限流本质、Reno/CUBIC/BBR 三代算法的演进逻辑对照、Linux 下 BBR 的启用配置与选型经验,以及慢启动、AIMD、bufferbloat 等高频面试问题的推导式回答。
关键词TCP 拥塞控制、CUBIC、BBR、慢启动、AIMD、bufferbloat
TCP 拥塞控制是面试与实际调优的交叉地带:面试官用它考察网络理解的深度,工程师则会在传输密集型服务(上传下载、直播推流、跨机房同步)里真实遇到它。2026 年的生产环境,CUBIC 仍是 Linux 默认,但 BBR(已迭代到 v3,纳入 相关 RFC 体系的讨论)在高丢包、长肥管道场景的优势已经被广泛验证。这篇把演进脉络与工程选型一次讲清。
一、问题本质:网络是个没有中央调度的共享系统
路由器缓存有限,所有发送方加起来的速率超过链路容量就会拥塞——队列堆积、延迟暴涨、最终丢包。拥塞控制的本质是分布式限流协议:每个发送方根据隐式信号(丢包/延迟)猜测网络状态,自觉调整发送速率。整个算法围绕一个窗口 cwnd 展开,实际发送量 ≈ min(拥塞窗口, 接收窗口)。
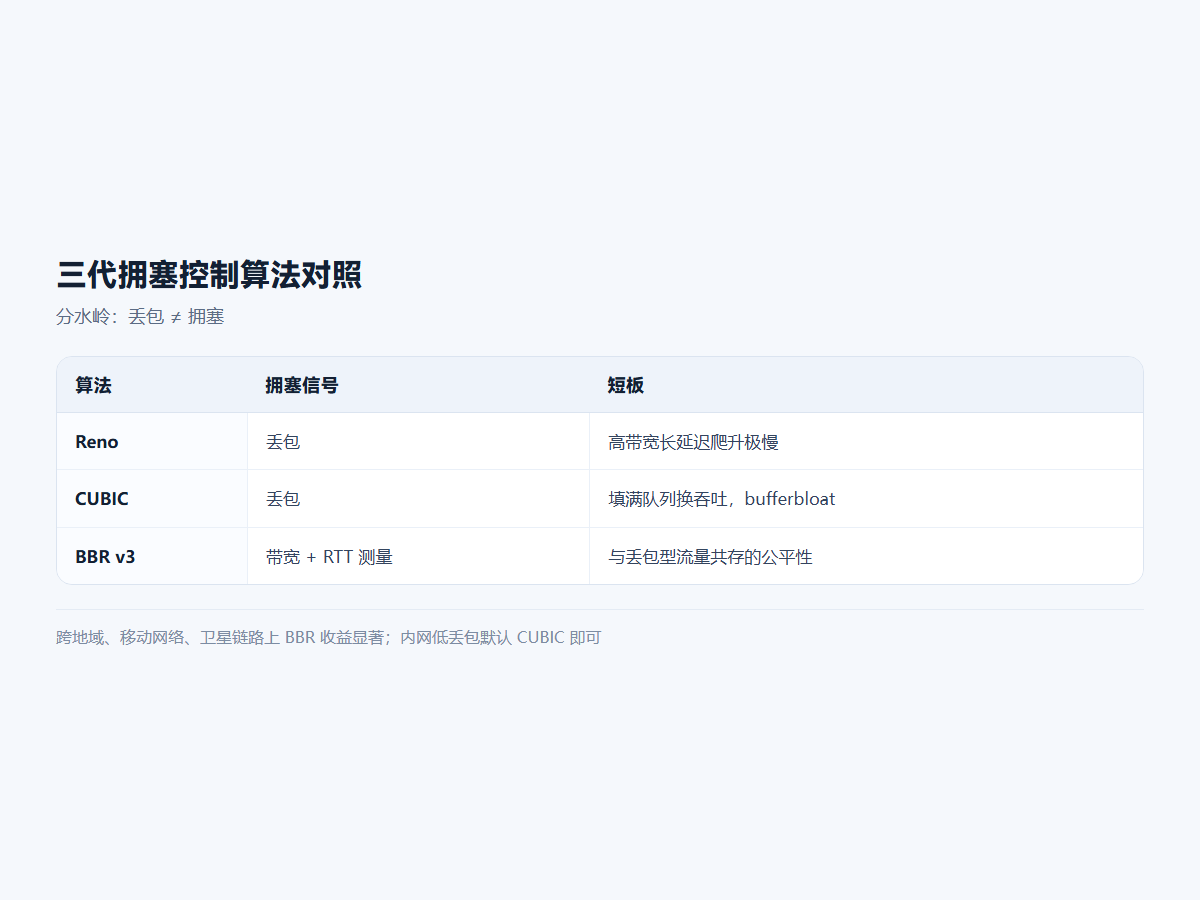
二、三代算法的演进逻辑
理解 CUBIC 与 BBR 的分水岭:丢包 ≠ 拥塞。Wi-Fi、5G、跨洋链路存在大量非拥塞性丢包,把丢包当拥塞信号会导致这些场景下的带宽利用率极低——这正是 BBR 的出发点。
三、工程视角:Linux 下怎么调
# 查看可用与当前算法
sysctl net.ipv4.tcp_available_congestion_control
sysctl net.ipv4.tcp_congestion_control

# 启用 BBR(内核 4.9+,v3 需要较新内核)
modprobe tcp_bbr
sysctl -w net.ipv4.tcp_congestion_control=bbr
sysctl -w net.core.default_qdisc=fq   # BBR 推荐 fq 队列规则
选型经验:内网或丢包极低的环境,CUBIC 与 BBR 差距不大,默认即可;跨地域传输、移动网络、卫星/跨境链路,BBR 收益显著(吞吐提升数倍是常见结果)。反向代理与下载服务值得逐台评估切换,注意服务端与对端各自的算法独立生效。
四、与面试高频问题的对齐
- 慢启动为什么存在:没有先验信息时用指数增长快速探测可用带宽,直到丢包或达到阈值(ssthresh)转入拥塞避免;
- AIMD 为什么公平:加性增(每 RTT +1)使各流线性爬升,乘性减(减半)让占用多的流让出更多,长期收敛到公平分享;
- BBR 为什么不怕随机丢包:它不把丢包当拥塞信号,只依据 btlbw 与 rtprop 两个测量值控制速率;
- bufferbloat 是什么:过大的路由器缓冲让「填满缓冲才丢包」的算法把延迟推到数百毫秒——CUBIC 时代网页卡顿的经典根源之一。
一句话总结:从 Reno 到 CUBIC 是「更聪明地利用丢包信号」,从 CUBIC 到 BBR 是「换掉信号本身」。理解这条主线,算法细节都可以现场推导。
标签
#TCP#网络协议#BBR#性能调优