大促容量保障的完整方法论:从业务目标到链路模型的容量推演、影子库与流量染色的安全实现(含定时任务等三处易漏点)、单链路到全链路的三级推进节奏,以及缓存失效等三个必演练场景。
关键词全链路压测、影子库、流量染色、容量保障、故障演练、大促备战
大促、开学季、爆款活动——容量问题总在流量峰值时爆发,而容量保障的所有工作都必须在流量到来之前完成。全链路压测是容量保障体系的核心手段,但它不是「压一下看看」,而是一套包含目标设定、数据隔离、流量染色、预案演练的完整工程。这篇按执行顺序拆解。
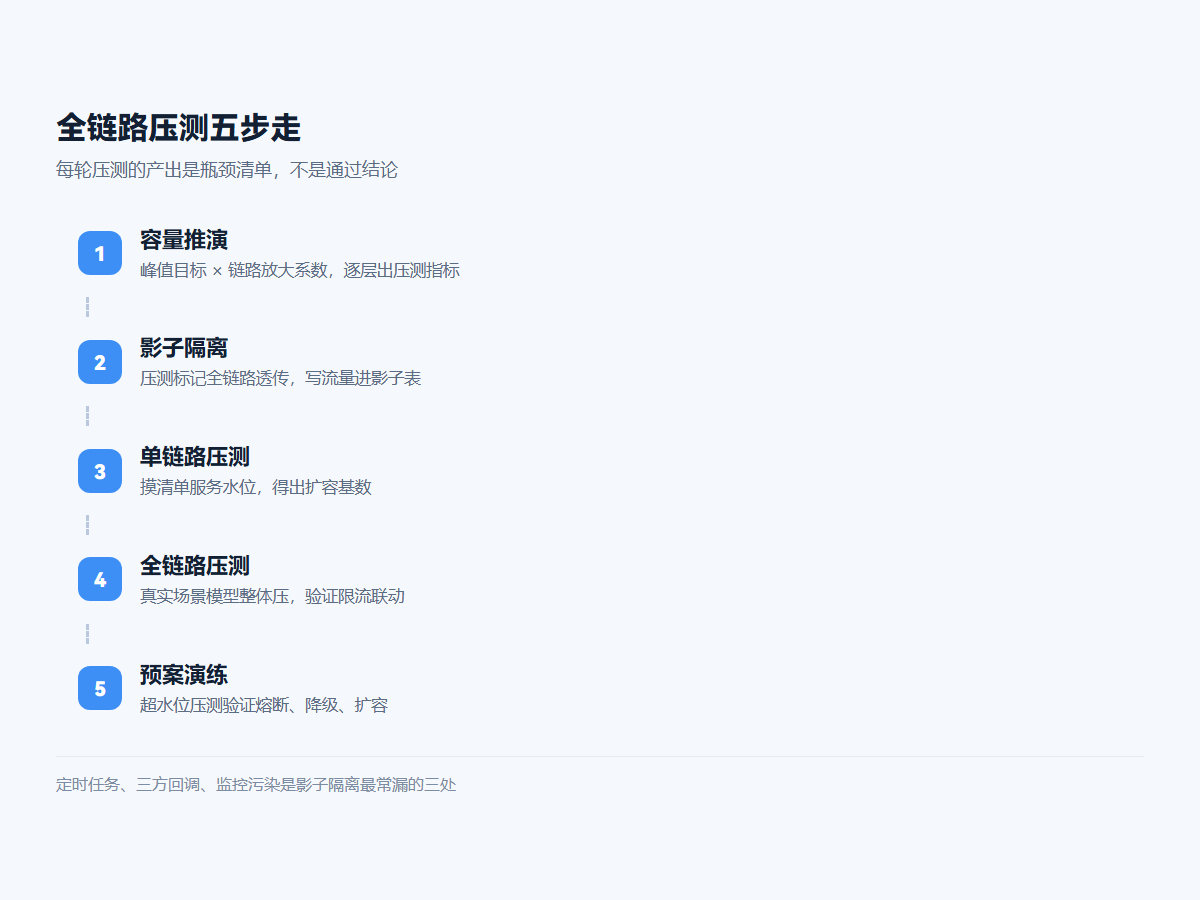
一、第一步:把「能扛多少」变成可计算的模型
压测前先做容量推演,否则压测就是盲目的。三个输入:
- 业务目标:峰值 QPS 预估(去年峰值 × 增长系数,或活动玩法折算);
- 链路模型:从入口到存储,每一跳的调用比例(下单 1 次 → 库存服务 2 次 → 缓存 5 次 → DB 0.8 次),逐层放大出每一层的压测目标;
- 瓶颈假设:根据历史监控标注最可能先顶不住的组件(通常是 DB 连接、缓存热 key、下游三方接口限流)。
二、数据与流量隔离:影子库是安全底线
压测流量绝不能污染生产数据。行业标准做法是影子表/影子库:压测请求打上标记(Header 或 RPC context),中间件层识别标记后把写操作路由到影子表,读操作正常走生产(读不会污染)。关键实现点:
// 全链路透传压测标记:入口打标 → RPC/MQ/DB 各层识别
if (ctx.getHeader("X-Load-Test") === "1") {
  ctx.loadTest = true;
  // DB 层:INSERT INTO shadow_order ... 而不是 order
  // MQ 层:发往 shadow_topic,消费者同样打标
}容易遗漏的三处:定时任务(压测产生的数据触发真实扣款/通知)、三方回调(支付回调打到压测订单)、监控污染(压测流量进大盘导致告警误报——大盘要分桶)。
三、执行:从单链路到全链路的三级推进
- 单服务压测:摸清每个服务的单机容量水位,得出「扩容到多少实例」的基数;
- 链路压测:核心链路(下单、支付)单独压,验证服务间配比与缓存命中率;
- 全链路压测:真实场景模型整体压,验证限流、降级、扩容联动是否按预期工作。
每轮压测的产出不是「通过了/没通过」,而是瓶颈清单:哪一跳在多少 QPS 时出现什么征兆(RT 翻倍、错误率抬头、连接池打满)。压测的价值 = 修掉瓶颈的速度。
四、预案演练:压测的最终目的是验证「坏的时候会怎样」
容量保障的完整闭环必须包含故障演练:把压测推到超过目标水位,验证限流是否按预期挡住多余流量、降级开关是否生效、扩容是否自动触发。三个必演练场景:缓存整体失效(DB 瞬时承压)、三方接口挂掉(降级到本地兜底)、某一服务节点批量宕机(负载均衡与重试风暴)。
一句话总结:全链路压测的本质是用可控的成本,在演练环境里把生产事故提前发生一遍。目标模型 → 影子隔离 → 三级推进 → 预案演练,四步走完,大促才有底气说「我们准备好了」。
标签
#全链路压测#容量规划#稳定性保障#故障演练