PostgreSQL 生产环境的五件要事:PgBouncer 连接池的事务模式与前提、B-tree/GIN/BRIN/部分索引的选型速查、MVCC 与 autovacuum 的膨胀治理、EXPLAIN ANALYZE 的三处必看,以及分区与近零停机升级路径。
关键词PostgreSQL 18、PgBouncer、VACUUM、索引选型、EXPLAIN、数据库调优
PostgreSQL 在 2026 年的生态地位不需要再论证:AI 应用的向量检索(pgvector)、地理数据(PostGIS)、时序(TimescaleDB)都在往 PG 上收敛,PostgreSQL 18(2025 年 9 月发布)带来的异步 I/O(io_method = io_uring/worker)让顺序扫描和大表读取有明显提速。但「选 PG」和「用好 PG」是两回事,这篇聚焦生产环境最常翻车的五件事。
一、连接:别让连接数杀死数据库
PG 的每个连接是一个进程,直连模式下几千个连接的内存与调度开销足以拖垮实例。生产标配是 PgBouncer 或内置连接池(Supabase/云厂商 RDS 均已内置):
# pgbouncer.ini 关键项
pool_mode = transaction        # 事务级复用,吞吐最高
max_client_conn = 5000         # 客户端侧上限
default_pool_size = 40         # 到 PG 的真实连接数
server_reset_query = DISCARD ALL
用 transaction 模式的前提:不用 session 级特性(SET、游标跨事务、advisory lock 的 session 模式),否则会出现「连接串味」的诡异 bug。
二、索引:会建更要会查
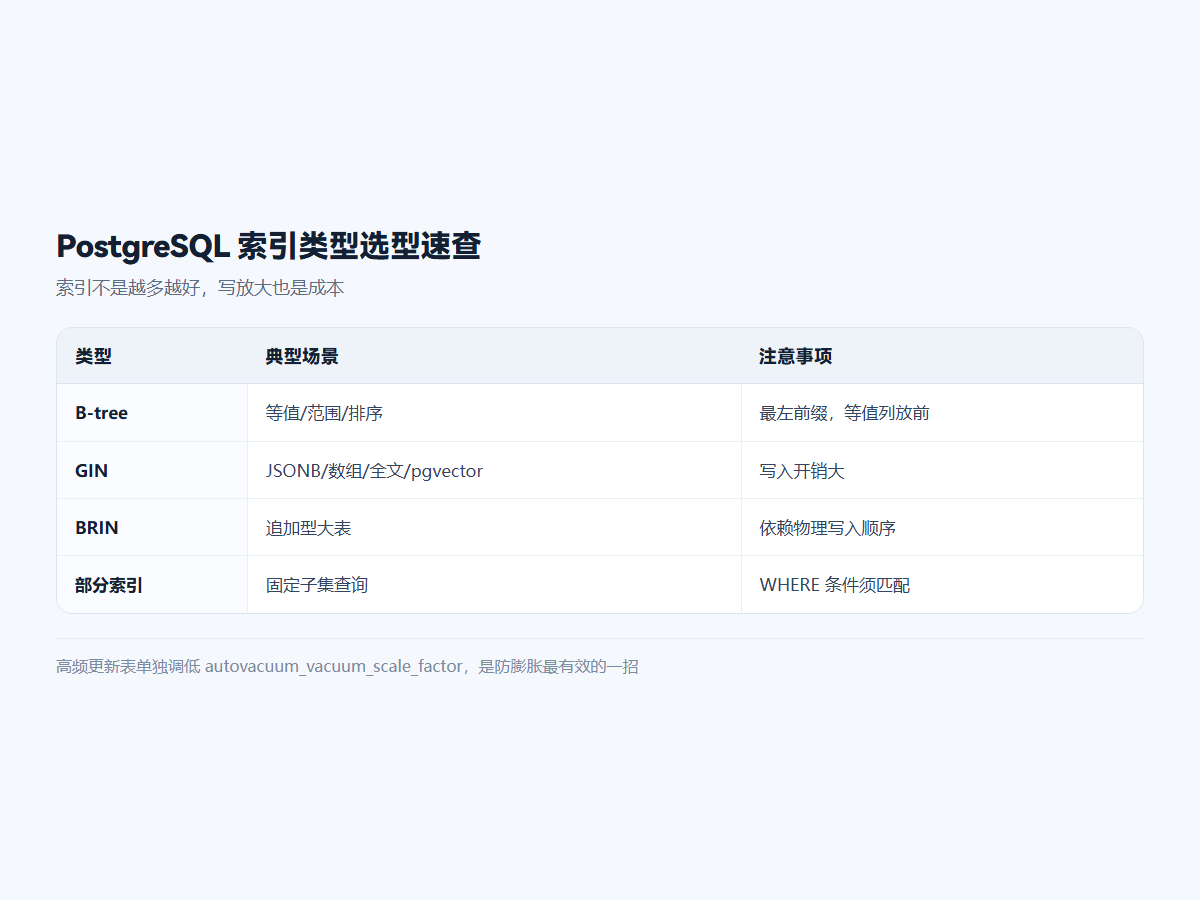
索引不是越多越好,写放大和规划器的开销都是成本。选型速查:
三、VACUUM:理解 MVCC 才能理解膨胀
PG 的 UPDATE/DELETE 不原地修改数据,而是留旧版本等 VACUUM 回收。autovacuum 默认参数对大表过于保守,容易出现表和索引膨胀。两个硬性动作:高频更新的表单独调低 autovacuum_vacuum_scale_factor(如 0.01),定期用 pg_repack 在线重建膨胀严重的索引。监控上盯住死元组数与表年龄(防事务 ID 回卷),比盯 CPU 更能提前发现问题。官方文档对 routine vacuuming 有完整说明。
四、EXPLAIN:调优的第一入口
所有慢查询先用 EXPLAIN (ANALYZE, BUFFERS) 而不是 EXPLAIN——前者拿真实执行数据。重点看三处:行数估算与实际的偏差(偏差大说明统计信息过期,先 ANALYZE);是否出现 Seq Scan 扫大表;Buffers: shared read 是否远大于 hit(缓存命中率低)。
五、分区与扩展:设计期决定上限
单表过亿再想分区就晚了。PG 18 的原生分区按 时间范围分区最常用(配合 BRIN 索引近乎零成本),把「删旧数据」变成「drop 分区」这种瞬时操作。水平扩展方面,Citus 或应用层分片都成熟,但先做好垂直拆分与归档,90% 的场景不需要一开始就分片。版本升级用逻辑复制做近零停机迁移,是当前最稳的路径(大版本变更参考 官方升级指南)。
一句话总结:PG 生产化的功夫在连接池、autovacuum、索引选型这三件朴素的事上——它们不起眼,但决定了系统是「能跑」还是「稳跑」。
标签
#PostgreSQL#数据库#性能调优#运维实践