API 网关的职责边界、四种限流算法的特性差异与 Nginx 配置实践、熔断的双条件触发与降级预案设计,以及什么时候才真正需要 Service Mesh——一篇讲清入口流量的治理方法论。
关键词API 网关、限流算法、令牌桶、熔断降级、Service Mesh、流量治理
流量入口的架构在 2026 年发生了明显分化:南北向流量(客户端 → 服务)继续收敛到 API 网关,东西向流量(服务 ↔ 服务)则分化出 Service Mesh 与传统 SDK 治理两条路线。很多团队的问题是把两类流量塞进同一套治理方案,结果两头不讨好。这篇讲清入口网关的职责边界、限流熔断的正确打开方式,以及什么时候才真的需要 Mesh。
一、入口网关只做四件事,多了就是负担
API 网关(Nginx 1.30/1.31 稳定线、APISIX、Higress、Kong 等)的核心价值高度收敛:
- 路由与协议转换:路径/域名/Header 路由,gRPC-Web、WebSocket 等协议桥接;
- 安全防护:TLS 终止、认证鉴权(JWT/OIDC)、WAF、IP/地域封禁;
- 流量治理:限流、熔断、灰度分流、重试与超时策略;
- 可观测:访问日志、Trace 采样入口、监控埋点。
把业务逻辑、复杂聚合、数据拼装放进网关层是最常见的反模式——网关应该保持「薄」,编排型 BFF 单独成层。
二、限流:算法选对,位置放对
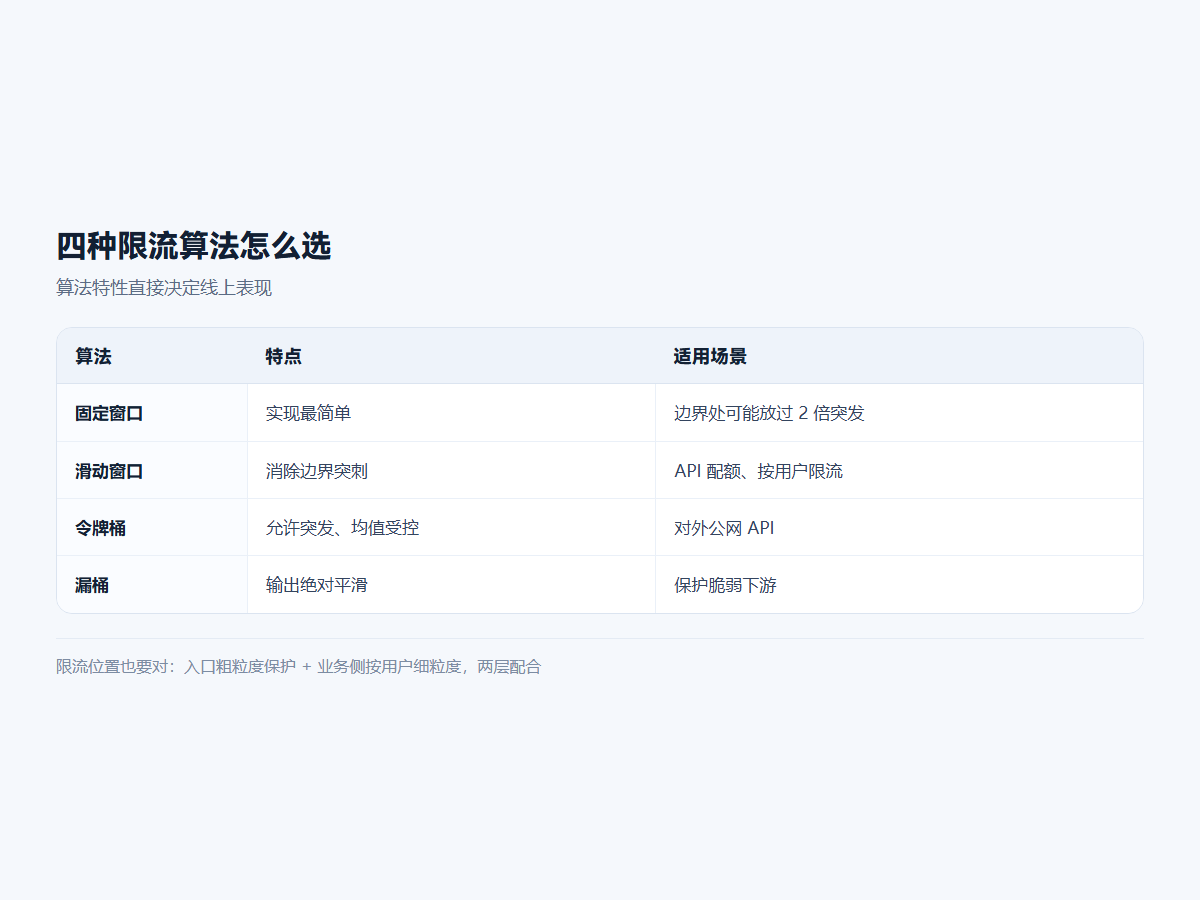
限流不是「配个数字」,算法特性差异直接影响线上表现:
以 Nginx 为例,limit_req 的 burst + nodelay 组合就是「令牌桶」语义:
limit_req_zone $binary_remote_addr zone=api:10m rate=100r/s;

server {
  location /api/ {
    limit_req zone=api burst=200 nodelay;  # 允许 200 的突发,不排队
    limit_req_status 429;
    proxy_pass http://upstream;
  }
}
三、熔断与降级:给失败留一条设计好的路
熔断的判断依据建议用滑动错误率 + 最小请求数双条件(例如 30 秒内错误率 > 50% 且请求数 ≥ 100 才触发),避免低峰期几个偶发错误就误熔断。半开状态放小流量探测恢复。降级预案必须在设计期确定:返回缓存数据、返回默认值、还是功能开关关闭入口——没有预案的熔断只是把 500 换成另一种 500。
四、什么时候才需要 Service Mesh
Mesh 解决的是东西向流量的治理逻辑从 SDK 中剥离的问题。判断标准很实际:语言/框架异构程度高(Java + Go + Node 混合)、微服务数量大(50+)、SDK 升级成本已经成为团队痛点——三条满足两条再上 Mesh,否则 Sidecar 的资源开销与运维复杂度会先吃掉收益。中小规模的服务治理用「网关 + 稳定版 SDK(重试/熔断/负载均衡)」依然是性价比最高的组合。
一句话总结:南北向靠网关做薄而稳的入口治理,东西向先靠 SDK,规模到了再上 Mesh。顺序反了,复杂度就会反过来治理你。
标签
#API 网关#限流#高可用#微服务