一套能落地的前端监控体系:LCP/INP/CLS 三指标的准确采集口径,JS 错误、资源失败、接口异常四类数据的低侵入上报,指标到归因字段的翻译方法,以及告警分级与发布门禁两个闭环抓手。
关键词前端监控、Core Web Vitals、INP、LCP、CLS、RUM
很多团队的前端监控停留在「接了个 SDK,看个大盘」的阶段,指标全绿但用户投诉不断。问题不在工具,而在采集口径与行动闭环。这篇按「采什么、怎么采、采完怎么办」三段,给出一套能落地的监控体系,所有指标口径对齐 Google Core Web Vitals。
一、采什么:三个核心指标 + 四类异常
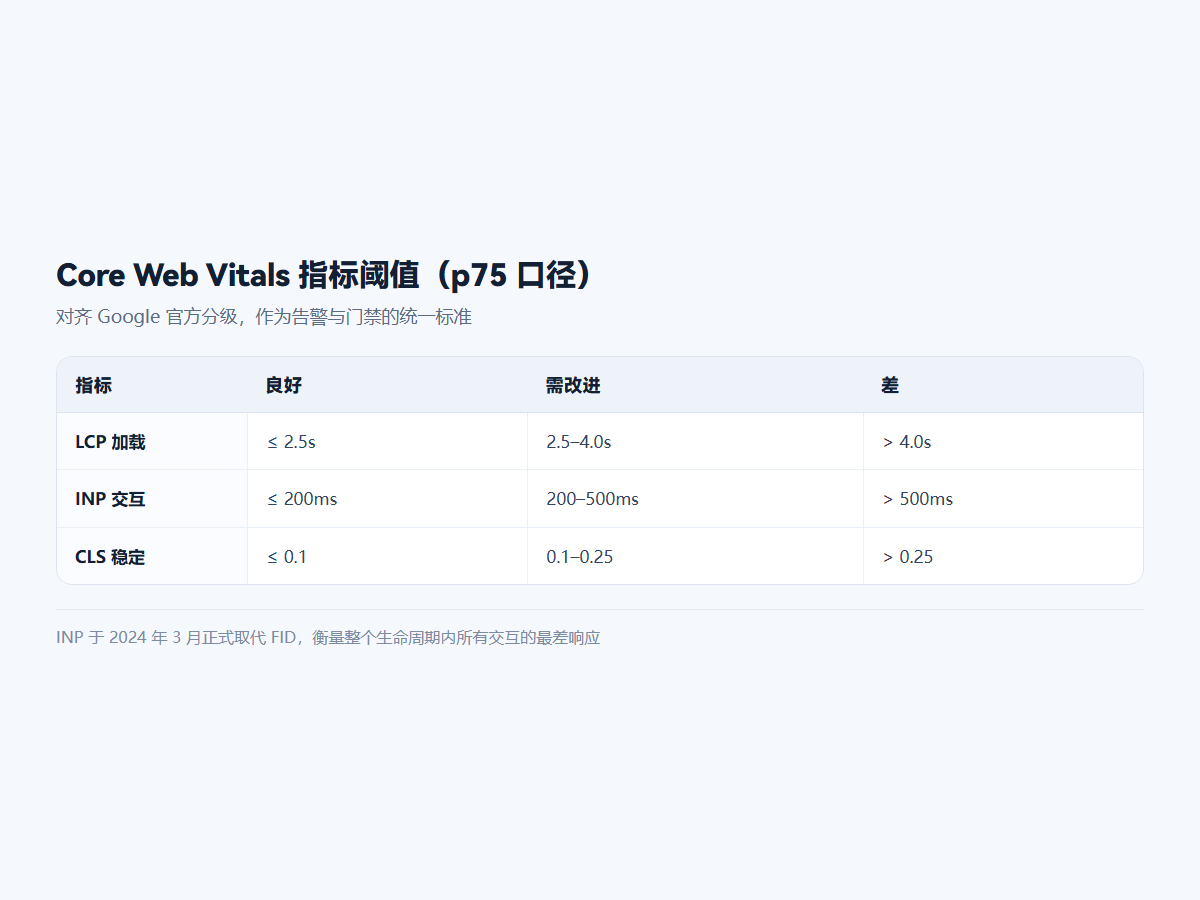
体验指标只看三个:LCP(加载)、INP(交互响应,2024 年 3 月起正式取代 FID)、CLS(视觉稳定)。INP 是最容易被低估的——它衡量整个页面生命周期内所有交互的响应延迟,比 FID 严格得多,长任务、 hydrate 未完成、事件处理过重都会在这里现形。
异常采集四类:JS 运行时错误(window.onerror)、Promise 未捕获拒绝(unhandledrejection)、资源加载失败(error 捕获阶段)、接口失败与慢请求(封装层统一埋点)。
二、怎么采:低侵入、可归因、控成本
官方 web-vitals 库(当前 6.x)已经把三个指标的测量逻辑封装好,自己实现很容易踩口径偏差:
import { onLCP, onINP, onCLS } from "web-vitals";

const report = (metric) => {
  navigator.sendBeacon("/api/rum", JSON.stringify({
    name: metric.name, value: metric.value,
    id: metric.id,          // 同一会话去重/聚合的键
    nav: performance.getEntriesByType("navigation")[0]?.type,
    url: location.pathname, // 只采路径,不采 query,防敏感信息泄露
  }));
};
onLCP(report); onINP(report); onCLS(report);三条工程红线:上报走 sendBeacon(页面卸载也不丢);采样率按流量分级(头部页面全量、长尾 1%–10%);采集脚本独立版本化,不要跟着业务 bundle 一起发,否则 SDK 自身出问题就是监控盲区。
三、归因:把「指标差」翻译成「哪里坏了」
指标只是结果,归因要靠细节字段。实践中最值钱的几个:
- LCP 差:看
metric.entries里 LCP 元素是什么、其资源的 TTFB/下载耗时各占多少——TTFB 高是服务端问题,下载慢是资源问题,元素晚出现是渲染阻塞问题; - INP 差:用
performance的 LongTask 与事件 timing 定位到具体长任务,常见元凶是 hydrate 未完成就绑交互、同步计算、大量 DOM 操作; - CLS 差:查没有尺寸的图片/广告位、动态插入在首屏上方的元素、字体切换闪动。
建议把「指标 + 归因字段 + 用户会话 ID」落成一条记录,能从大盘一路点到一个会话的完整行为序列,这是排查投诉时最省时间的形态。
四、闭环:告警分级与回归门禁
没有闭环的监控只是报表。两个抓手:
- 告警分级:p75 指标劣化超 10% 持续 1 小时 → 群通知;超 25% 或错误率突增 → 电话拉人。按页面维度拆开告警,避免大盘均值掩盖局部恶化;
- 发布门禁:每次上线前用实验室环境(Lighthouse/自建 lab)跑核心页面,LCP/INP/CLS 与 bundle 体积超阈值即阻断合并。线上回归 lab 数据不准确,但拦住「明显变差」足够了。
一句话总结:监控体系的价值 = 采集口径的准确 × 归因链路的完整 × 告警后的响应速度。三个指标、四类异常、两个闭环抓手,就构成了 2026 年前端监控的合格线。
标签
#前端监控#性能优化#Web Vitals#可观测性