并发这个词底下至少藏着四套完全不同的模型。本文从最重的进程讲起,逐层拆到线程、虚拟线程与协程,给出一张可以按图索骥的选型表,并澄清三个常见误解:并发数越多越好、协程能解决所有性能问题、用了并发就不用管锁。
关键词并发模型、虚拟线程、协程、线程池、上下文切换、计算机基础
“并发”这个词底下至少藏着四套完全不同的模型:进程、线程、协程、虚拟线程。它们经常被混着讨论,但在内存占用、切换成本、适用场景上的差异是数量级的。
本文把这四层讲清楚,并给出一张可以按图索骥的选型表。
一、从最重的一层说起:进程
进程是操作系统分配资源的基本单位,拥有独立的虚拟地址空间。这意味着进程之间天然隔离——一个崩了不会带崩另一个,但也意味着:
- 创建与销毁成本高:要分配独立的地址空间、页表、文件描述符表;
- 上下文切换最贵:切换时要换页表基址,TLB 大概率全部失效,缓存命中率断崖下跌;
- 通信必须走 IPC:管道、共享内存、Socket,没有共享变量这一说。
什么时候该用进程?答案是当你需要隔离性而不是并发度时:浏览器给每个标签页开独立进程、容器化部署里一个容器一个进程、数据库用多进程架构避免一个连接的 bug 拖垮整个实例。用进程换的是”故障隔离”和”安全边界”,不是性能。
二、线程:并发的主力,但有天花板
线程是CPU 调度的基本单位,同一进程的线程共享地址空间,因此创建成本比进程低得多,通信可以直接读写共享变量——代价是必须面对数据竞争。
但线程有两个真实存在的天花板:
1. 内存占用
每个线程要预留独立的栈空间(典型值在几百 KB 到数 MB 量级)。这意味着开一万条线程,光栈就要吃掉几个 GB——还没跑业务逻辑。
2. 调度开销
线程是抢占式调度,由操作系统内核决定什么时候切走。线程数远超 CPU 核数时,大量时间花在上下文切换上:保存恢复寄存器、内核态与用户态往返、缓存污染。到了某个点,加线程反而会降低吞吐。
这也就是”万级并发连接”在传统线程模型下很难做的原因——不是写不出来,是每个连接一条线程的模型撑不住。
三、虚拟线程:把”线程很贵”这件事解决掉
虚拟线程(JDK 21 引入,在最新的 LTS 版本中已是成熟能力)的核心思路是:让大量虚拟线程复用少量操作系统线程。
关键机制在于阻塞时的自动让出:虚拟线程执行到阻塞操作(等 IO、等锁、sleep)时,运行时会把它从载体线程上卸载下来,让载体线程去跑别的虚拟线程;等 IO 就绪了再挂回去继续。对写代码的人来说,这就是普通的同步代码。
这个设计的价值是:你可以用最简单的同步写法,获得接近异步框架的并发能力。不用回调、不用 CompletableFuture 链式编排、不用把业务逻辑撕成两半。
// 一万并发请求,写法和单线程一样直白
try (var executor = Executors.newVirtualThreadPerTaskExecutor()) {
    for (String url : urls) {
        executor.submit(() -> fetchAndProcess(url));
    }
}
但虚拟线程不是万能的,有两个明确的坑
- CPU 密集任务没有收益:虚拟线程的收益来自”阻塞时让出”。如果任务一直在算,它就会一直占着载体线程,开多少虚拟线程都没用;
- 下游资源池才是真瓶颈:把 Web 层换成虚拟线程后,并发请求全都压到数据库连接池上。池大小没变,等待只是从线程池搬到了连接池——这类”优化”经常查不出效果,原因就在这。
还有个容易被忽略的点:虚拟线程适合的是”阻塞式 IO 多的场景”,但它不会让 IO 本身变快。
四、协程:语言层面的协作式调度
协程和虚拟线程很像——都是”用户态的轻量级执行单元,复用少量系统线程”。核心区别在调度方式:协程是协作式的,需要代码显式让出执行权(比如 Kotlin 的 suspend、Go 的调度点在特定操作上)。
这带来两个实际差异:
- 可控性更强:结构化并发(Kotlin 的
coroutineScope)让”一组并发任务的生命周期”可以被明确管理——父任务取消,子任务自动取消。这在写复杂异步流程时是很大的优势; - 需要显式配合:在协程里调用阻塞式 API 会占住底层线程,把协程的收益抵消掉。因此生态上要求配套的非阻塞库。
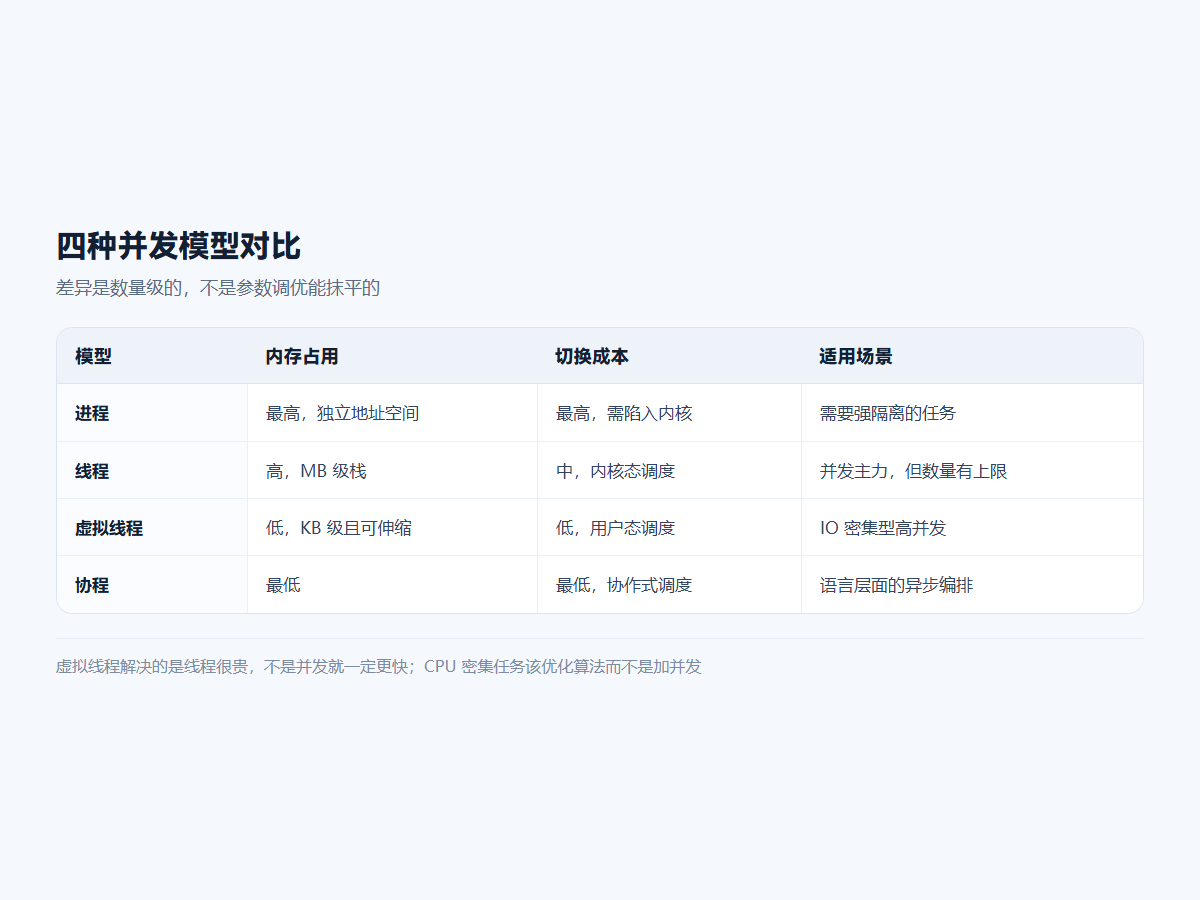
五、一张表选型
- 进程:需要故障隔离、安全边界、或利用多机扩展。成本高,并发度低,换的是可靠性。
- 线程(平台线程):CPU 密集计算的默认选择。数量应控制在与核数同量级,配线程池使用。
- 虚拟线程:IO 密集、希望保持同步写法的服务端应用。改造成本极低,但要先确认下游资源池跟得上。
- 协程:需要精细控制异步任务生命周期、或已在 Kotlin/Go 生态内。灵活但需要配套的异步库与团队共识。
六、三个常见误解
误解一:并发数越多越好
超过某个点之后,增加并发只会增加等待。正确的并发度应该由瓶颈资源决定:CPU 密集看核数,IO 密集看下游能承受多少并发。盲目加大并发数,是压测时把系统压垮的最快方式。
误解二:虚拟线程 / 协程能解决所有性能问题
它们解决的是”线程数量不再是并发上限“这一个问题。慢 SQL、不合理的数据结构、串行调用链、锁竞争——这些它一个都解决不了。先定位瓶颈,再选模型。
误解三:用了并发模型就不用管锁了
恰恰相反:共享可变状态的问题在虚拟线程和协程下依然存在,而且因为并发度上去了,竞争可能更激烈,低概率的竞态 bug 会从”偶尔出现”变成”经常出现”。要么用不可变数据,要么老老实实加锁或用并发容器。
七、小结
四层模型的本质差异,在于用什么代价换取什么能力:进程换隔离、线程换简单、虚拟线程换并发度、协程换可控性。
实际工程中,最常见的正确组合是:用多进程做部署级隔离,进程内用虚拟线程或协程处理 IO 并发,CPU 密集任务交给固定大小的线程池。搞清楚瓶颈在哪一层,比选哪个模型重要得多。
标签
#并发#操作系统#虚拟线程#计算机基础