数据库迁移是发布流程里最不可撤销的一环。本文讲清零停机迁移的核心模式 expand-contract、各类变更的安全步骤,以及那些看起来无害但实际会锁表的操作,并给出一份可执行的检查清单。
关键词零停机迁移、数据库迁移、expand-contract、在线 DDL、锁表
数据库迁移是发布流程里最不可撤销的一环。代码发错了可以回滚,数据表改错了——尤其是删列、改类型这类操作——回滚意味着停机和数据抢救。
本文讲清零停机迁移的核心模式(expand-contract)、各类变更的安全步骤,以及那些”看起来无害但实际会锁表”的操作。
一、核心模式:expand → migrate → contract
所有安全的数据库迁移,底层都是同一个模式:先把结构扩展成新旧兼容,再迁移数据,最后才收缩掉旧结构。
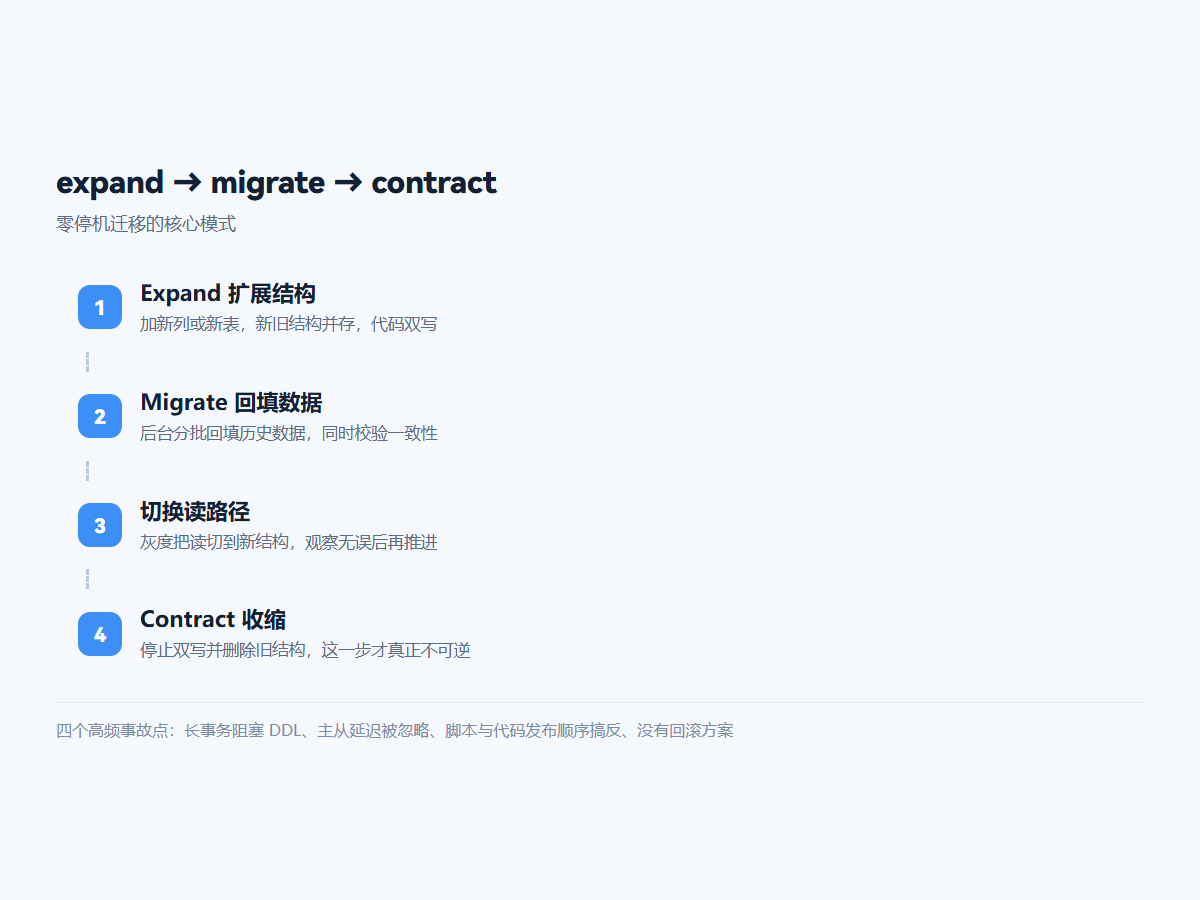
关键在于每个阶段都可以独立部署和回滚,且中间态下新旧版本代码能同时正常工作。这就是为什么它必须拆成多次发布,而不是一次搞定。
二、逐类变更的安全步骤
1. 加字段:默认安全,但有两个例外
加一个可为空、有默认值的列,在主流数据库上通常很快。但下面两种情况会出事:
- 加了 NOT NULL 且没有默认值:已有数据无法满足约束,直接失败;
- 老版本数据库上给大表加带默认值的列:某些版本会触发整表重写,表越大锁得越久。
安全做法分两步走:
-- 第一步:先加可为空的列(快速,不锁表)
ALTER TABLE orders ADD COLUMN channel VARCHAR(32) NULL;

-- 第二步:回填历史数据,分批进行,控制单次影响行数
UPDATE orders SET channel = 'web' WHERE channel IS NULL LIMIT 5000;

-- 第三步:确认无 NULL 后,再加约束(按需,注意仍可能触发校验扫描)
注意第二步的分批回填:一次性更新几千万行会撑爆事务日志、拖垮主从同步。分批 + 每批之间留出间隔,是标准做法。
2. 改字段:几乎都要走”加新列”路线
不要想着直接 MODIFY 或 ALTER COLUMN TYPE。正确路径是:
- 加一个新列(新类型);
- 代码改成双写——同时写旧列和新列;
- 后台任务回填历史数据;
- 校验新旧列数据一致;
- 代码切到只读新列,观察一段时间;
- 代码停止写旧列;
- 最后才删除旧列。
七步听起来繁琐,但每一步都可回退——这正是它值得的原因。合并成一步的结果是:出问题只能停机。
3. 删字段:先停写,再删
删除列的致命风险在于旧版本代码还在读它。发布期间新旧版本必然共存(滚动发布、灰度、多实例),因此顺序必须是:
- 代码完全移除对该列的所有读写引用,并发布;
- 确认所有实例都跑在新版本上,且监控中该列无任何查询;
- 等待一个足够长的观察期(覆盖最长可能的旧实例存活时间);
- 才执行
DROP COLUMN。
一个实用技巧:删除前先把列改名而不是直接删掉(如 old_col → old_col_deprecated_202609)。万一有遗漏的引用,改名会立刻报错暴露出来,而删除则会导致数据永久丢失。
4. 加索引:必须用在线方式
在大表上直接 CREATE INDEX 会阻塞写入,时间与表大小成正比。这是生产事故的高频来源。
-- PostgreSQL:并发建索引(不阻塞写入,但耗时更长且可能失败残留)
CREATE INDEX CONCURRENTLY idx_orders_channel ON orders(channel);

-- MySQL:InnoDB 的多数场景下在线 DDL 已较成熟,但仍需确认版本与算法
ALTER TABLE orders ADD INDEX idx_channel(channel), ALGORITHM=INPLACE, LOCK=NONE;
两个注意点:并发建索引失败会留下无效索引,需要清理后重试;另外它耗时更长,别在超时时间短的迁移脚本里跑。
5. 改表名 / 拆分表:用视图做过渡层
最稳妥的做法是建新表 → 双写 → 回填 → 切读 → 用视图兼容旧表名 → 最后下线。视图的作用是给还没来得及改造的旧查询留一个兼容层,把一次性切换变成可分批推进。
三、四个高频事故点
1. 长事务阻塞 DDL
一个跑了十分钟未提交的查询,就能让 DDL 等十分钟,进而阻塞后续所有对该表的请求。执行迁移前必须检查并清理长事务,同时给 DDL 设置合理的锁等待超时,避免它自己变成阻塞源头。
2. 主从延迟被忽略
在主库上分批回填,会造成大量 binlog/WAL,从库追不上。而很多读流量在从库上,用户会看到”数据一会儿有一会儿没有”。回填必须限速并监控主从延迟,超阈值就暂停。
3. 迁移脚本和代码发布顺序搞反
经典错误:先发代码(读写新列),再跑迁移(加新列)——中间那段时间全部报错。正确顺序永远是结构变更先行,代码变更随后,且结构变更必须是向后兼容的。
4. 没有回滚方案
每次迁移都要提前想清楚:这一步失败了怎么办?加列可以删列,回填可以清数据,但删列、改类型就很难回退。回滚难度高的操作,一定要先备份,且放在整个流程的最后一步。
四、执行清单
建议把下面这些固化成发布模板:
- 确认本次变更属于哪一类,套用对应步骤;
- 检查目标表大小、当前长事务、主从延迟基线;
- DDL 设置锁等待超时,避免阻塞扩散;
- 数据回填分批 + 限速,全程监控主从延迟;
- 按”结构 → 代码 → 数据 → 清理”的顺序推进,不合并步骤;
- 每步之间留出观察期,确认无异常再进下一步;
- 高危操作(删列、改类型)前置备份,放在最后执行;
- 全部完成后,清理废弃列、临时索引和兼容视图。
五、小结
零停机迁移的核心不是某个工具或命令,而是把不可逆操作拆成一串可逆的小步骤。这个思路的代价是发布周期变长——一次字段类型变更可能要跨两三个发布窗口。
但相比”一次上线导致半小时全站不可用”,这点时间成本几乎总是值得的。记住一句话:能加的先加,能晚删的晚删,中间态要能同时服务新旧代码。
标签
#数据库#迁移#DDL#工程实践