我们该用哪个 MQ?这个问题在 2026 年并没有更容易,因为可选方案变多了,而它们的架构差异是根本性的。本文把四类主流方案的底层取舍讲清楚,给出一棵可以直接用的决策树,并列出四个高频踩坑点。
关键词消息队列选型、Kafka、RocketMQ、Pulsar、Redis Streams、架构设计
“我们该用哪个 MQ?”这个问题在 2026 年并没有变得更容易——因为可选方案变多了,而它们的架构差异是根本性的,不是参数调优能抹平的。
本文不打算给出”XX 最好”的结论,而是把四个主流方案的底层取舍讲清楚,再给一棵可以直接用的决策树。
一、版本坐标
截至 2026 年 9 月,从 Maven Central 元数据核对到的正式版本:
- Apache Kafka:
kafka-clients 4.3.1; - Apache Pulsar:
pulsar-client 4.2.4; - Apache RocketMQ:
rocketmq-client-java 5.2.2; - Redis(Streams):服务端最新稳定为
8.10.1。
注意客户端版本和服务端版本是两回事,跨大版本的客户端/服务端混用要查兼容矩阵,别只看客户端版本号。
二、先分清两类根本不同的架构
很多人把 MQ 选型理解成”比吞吐量”,这是个误区。真正的分水岭在第一层:
1. 日志型(Kafka 为代表)
本质是append-only 的分布式日志。消息写入后按偏移量顺序堆积,消费端自己维护读到哪儿。这个设计带来三个直接后果:
- 消息可重放:出问题可以回到任意偏移量重跑,这是流式处理和事件溯源的基石;
- 多消费者互不影响:不同消费组各读各的,新增一个消费者不会影响已有的;
- 吞吐量极高:顺序写盘 + 零拷贝,硬件能跑多快它就能接近多快。
代价是:单条消息的确认、重试、延迟投递这些”业务友好”的能力,都要自己在应用层搭。
2. 队列型(RocketMQ、RabbitMQ 为代表)
本质是带状态的消息服务。服务端维护每条消息的状态(已发送/已消费/需重试),提供延迟消息、事务消息、消费重试、死信队列这些开箱即用的语义。
代价是:服务端要维护状态,横向扩展和重放能力就不如纯日志型灵活,重放一条历史消息通常没那么顺手。
3. 计算存储分离型(Pulsar)
Pulsar 的架构是Broker 无状态 + 存储独立(BookKeeper)。它想同时拿到日志型的重放能力和队列型的扩展弹性:扩 Broker 不用搬数据,扩存储不用动 Broker。
代价是运维复杂度上升——你要同时理解并维护两套组件。团队规模不够时,这个复杂度会变成负担。
4. 轻量型(Redis Streams)
如果消息量不大、允许一定丢失、且已经重度使用 Redis,Streams 是成本最低的选择——不引入新组件,运维成本几乎为零。
但它不是为”关键业务消息”设计的:持久化策略、容量规划、积压处理都要自己兜底,数据量一大就会跟主 Redis 抢资源。适合通知、轻量级异步任务这类场景。
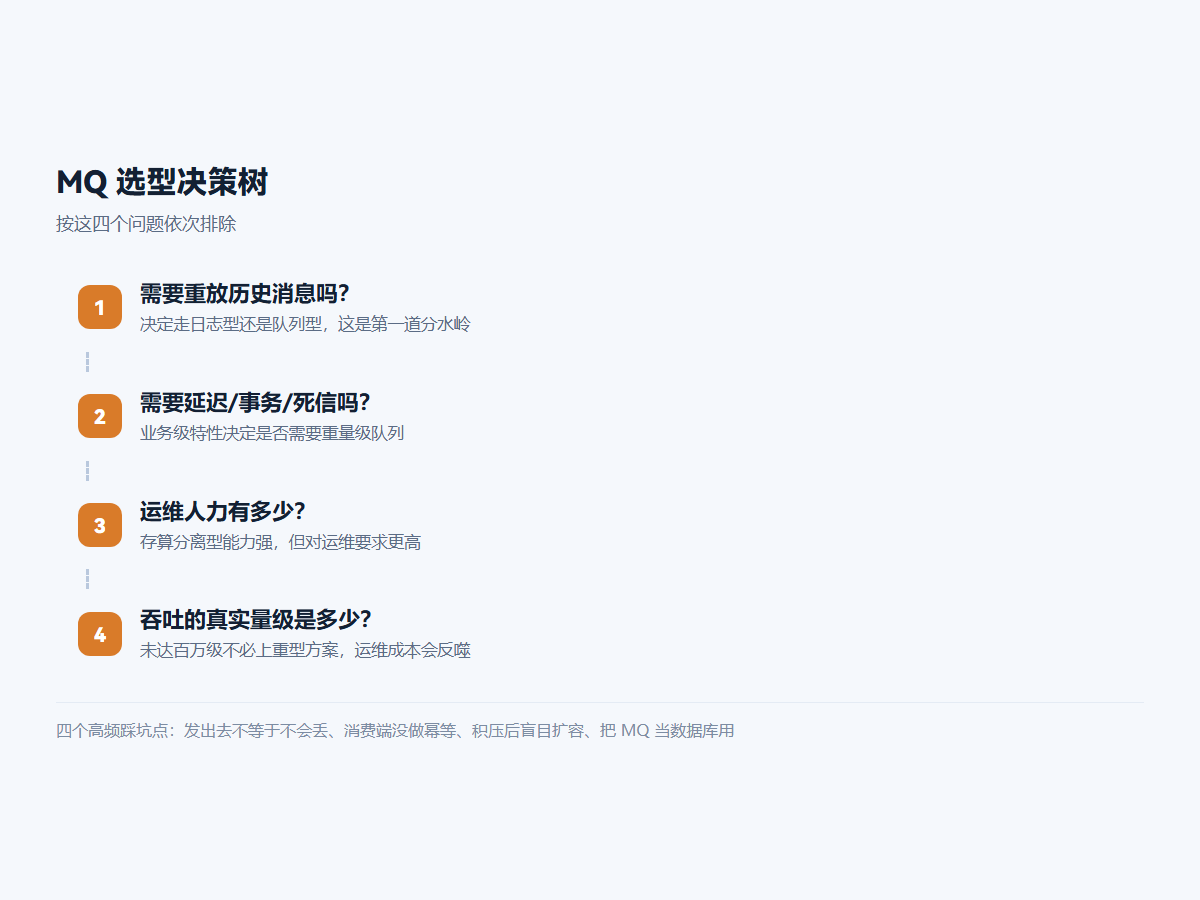
三、决策树:按这四个问题依次排除
按顺序问自己,前一个问题往往就能直接排除掉一半选项。
问题 1:需要重放历史消息吗?
需要(事件溯源、流处理、下游重建缓存)→ 排除 Redis Streams,Kafka / Pulsar 优先。
不需要(纯任务分发)→ 四个都能选,继续下一问。
问题 2:需要延迟消息 / 事务消息 / 死信队列吗?
需要,且希望开箱即用→ RocketMQ 是这一层的强项,Kafka 需要自己在应用层搭延迟队列(通常靠时间轮 + 分级 topic)。
不需要,或愿意自己实现→ 继续。
问题 3:运维人力有多少?
这是最诚实的一个问题。没有专职运维、团队规模小→ 优先考虑云厂商托管版,或直接用 Redis Streams。自建 Kafka 集群能跑起来和能稳定跑三年,是两件完全不同的事。
有专职 SRE→ Kafka、Pulsar 都能考虑。
问题 4:吞吐量的真实量级是多少?
很多团队高估了自己的量级。日均百万级以下的,四个方案在性能上都不构成瓶颈,选型应该完全由”语义需求 + 运维成本”决定。
日均亿级以上,或者需要对接 Flink 等流计算生态 → Kafka 的生态优势难以替代。
四、四个高频踩坑点
1. 以为”消息发出去了”就等于”不会丢”
默认配置下,生产者发送成功只代表消息到了 Broker 内存,未必落盘。要真的不丢,生产端要配 acks 策略、服务端要配多副本同步、消费端要先处理业务再提交位点——三处都得对:
# Kafka 生产端:all 表示等所有 ISR 副本确认才算发送成功
acks=all
enable.idempotence=true          # 幂等生产者,防重试导致的乱序重复
retries=2147483647

# 服务端:topic 副本与最小同步副本
replication.factor=3
min.insync.replicas=2            # 与 acks=all 配合,容忍一台副本故障

// 消费端:先落库再提交位点,配合幂等键防重复
while (records := consumer.poll()) {
    db.tx { saveAll(records) }   // 业务与幂等键同一事务
    consumer.commitSync()        // 处理完才提交
}
2. 消费端没有做幂等
分布式消息系统提供的是”至少一次“语义,重复投递是常态而非异常。消费端必须能容忍重复:唯一键去重、状态机校验、或者业务本身幂等。这一条几乎是所有线上消息事故的根源。
3. 积压后盲目扩容消费者
Kafka 这类分区模型下,消费者数量超过分区数就不会再提升并行度。扩容前先看分区数,否则加多少实例都是白加。
4. 把 MQ 当数据库用
消息堆积几千万条还指望快速回溯查询、或者把业务状态只存在消息里——这类用法会在某个凌晨反噬。MQ 是传输通道,不是存储系统。
五、一张表总结
- Kafka:吞吐与生态最强,重放能力原生;业务语义要自己搭,运维门槛高。适合日志、埋点、流处理、事件溯源。
- Pulsar:计算存储分离,弹性最好,多租户原生;组件多、运维复杂。适合多租户平台、需要弹性的中大型场景。
- RocketMQ:业务语义最全(事务、延迟、死信),Java 生态亲和;国际生态相对弱。适合交易、订单等强语义业务。
- Redis Streams:零新增组件,成本最低;可靠性与容量有限。适合轻量级异步、通知、已有 Redis 的小团队。
六、小结
选型的本质不是比参数,而是匹配架构假设:你需要重放吗?需要服务端维护消息状态吗?运维能扛几套组件?真实量级是多少?
对大多数团队,我的实际建议是:先用云厂商托管版跑起来,把业务语义和幂等做对,等量和复杂度真的上来了,再考虑自建和迁移。过早为”未来可能的量级”付出架构复杂度,是这一领域最常见也最贵的浪费。
标签
#消息队列#Kafka#RocketMQ#后端架构